Чем заменить Claude или Gemini после блокировки
Меня тоже заблокировали, и я пошёл разбираться, чем теперь пользоваться. Хотелось найти замену для работы с кодом и файлами и понять, сколько она будет стоить. Вот что получилось на ноябрь 2026 года.
Меня тоже заблокировали, и я пошёл разбираться, чем теперь пользоваться. Хотелось найти замену для работы с кодом и файлами и понять, сколько она будет стоить. Вот что получилось на ноябрь 2026 года.

Если Claude заблокировал аккаунт, ищите сообщение об ограничении доступа и возможность подать апелляцию. Если закончился лимит Claude, сервис обычно показывает время его сброса. Ошибка входа, слишком длинный чат и перегрузка требуют другой проверки. При сообщении «Claude не работает» сначала прочитайте уведомление целиком. С повторной оплатой пока стоит подождать.

Эйнштейн считал, что волновая функция похожа на прогноз погоды: описывает не сам мир, а наше неполное знание о нём. Белл в 1964 году показал, что мир не может быть одновременно реальным и локальным, но лазейка для идеи Эйнштейна осталась. В 2012 году Мэтью Пьюзи, Джонатан Барретт и Терри Рудольф доказали теорему PBR: если у мира есть объективное состояние и реальные состояния независимо приготовленных систем не влияют друг на друга, то квантовое состояние входит в эту реальность и не сводится к информации в голове наблюдателя. Как три теоремы закрыли компромиссный путь и что физикам осталось выбирать — на примере карточной игры, в которой квантовый игрок не проигрывает никогда.

Мы привыкли считать, что хороший интерфейс — это интерфейс, который снимает с человека лишнее умственное усилие. Для обычного продукта это верно: пользователь пришёл решить задачу, а не научиться чему-то. С ИИ-ассистентами эта логика перестаёт работать. Они убирают не только лишнее усилие, но и ту работу с материалом, из которой складывается навык. Разберёмся, какая нагрузка мешает, какая нужна и почему продукту с ИИ одного снижения внешней нагрузки мало.

Чуть больше года назад у меня вышла статья про биржу Kwork (ссылка на статью). Она набрала 30 000 просмотров. Результат неплохой, но в топе того же хабра лежат публикации по 150 000 и 350 000 просмотров. Мне стало интересно, почему одни статьи собирают пару тысяч просмотров, а другие читают сотнями тысяч.
Я решил проверить это с помощью Python и машинного обучения. План был простой: собрать статистику по статьям из моего хаба, оценить качество текстов через языковую модель, загрузить все метрики в Random Forest и посмотреть, какие параметры сильнее всего влияют на просмотры.
В процессе я уперся в лимиты облачного API, локальная нейросеть в LM Studio схитрила на промпте, а сам алгоритм машинного обучения сначала выдал аномальный прогноз из-за утечки данных. Ниже расскажу, как я это исправлял и какие цифры получил в итоге.

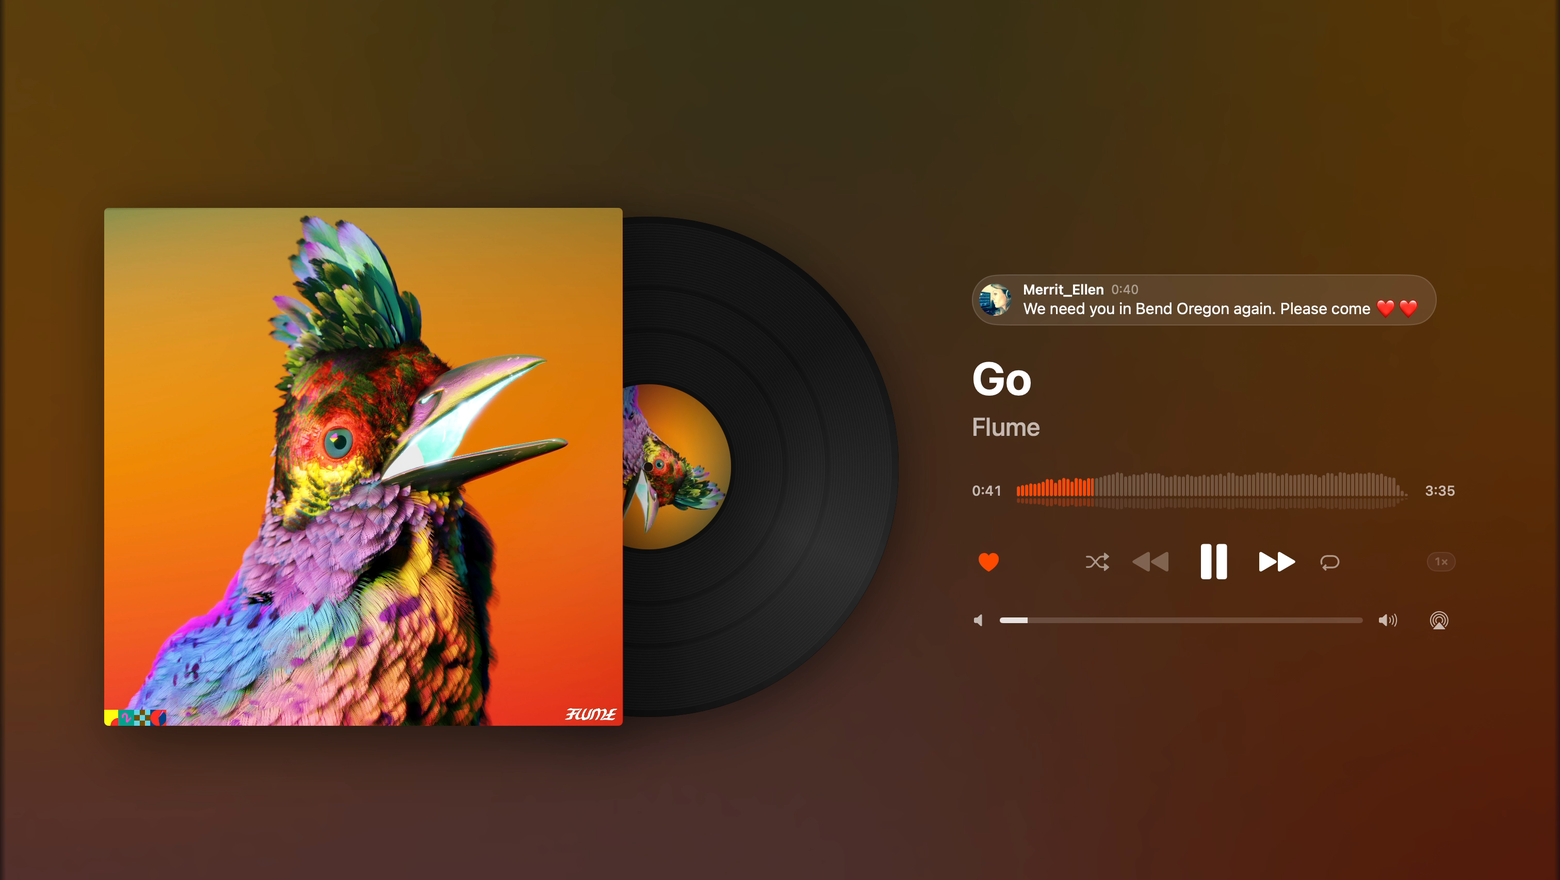
Я слушаю SoundCloud каждый день, а на Mac у него есть только сайт. Поэтому я написал Nimbus — нативный клиент на SwiftUI и AppKit: треки сменяют друг друга без паузы, работают медиаклавиши и Now Playing, музыку можно отправить на Chromecast, а полноэкранный режим превращает трек в пластинку.
Внутри — куда уходят полторы секунды между треками, почему SwiftUI пришлось посадить на AppKit и как подружить Mac с Chromecast, для которого нет SDK под macOS.

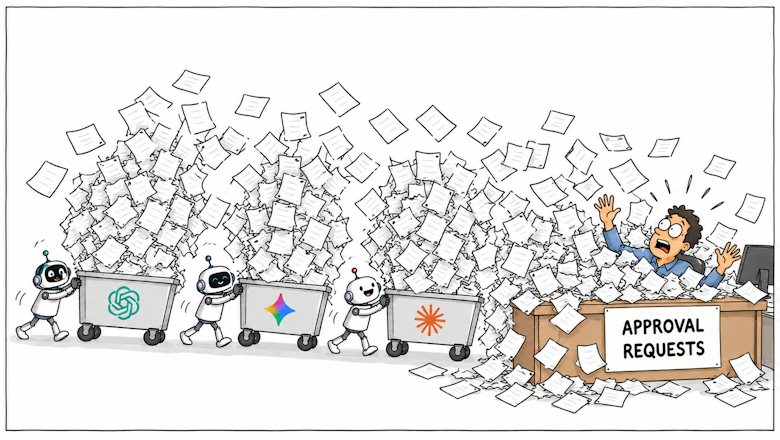
Сейчас LLM всё чаще внедряют в работающие бизнес-процессы: поиск и сбор информации, структурирование данных, проверку и публикацию. При этом цена одной ошибки модели бывает довольно высокой: это потерянные деньги, врея и репутация в глазах клиентов.
Снизить этот риск помогает принцип Human-in-the-Loop: в процесс добавляется человек, который валидирует данные. В этой статье собраны наши выводы на примере двух реальных бизнес-задач: автоматического перевода и поиска размерных сеток.

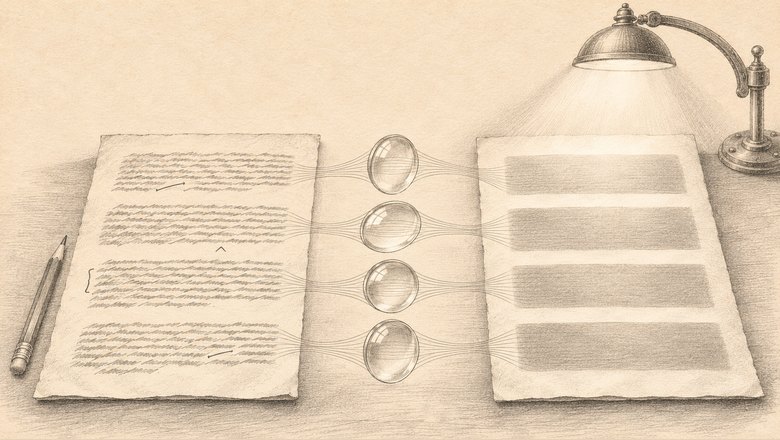
Нейросеть получает статью на редактуру и возвращает гладкий текст, в котором автора уже не узнать. В препринте 2026 года исследователи из Berkeley, Google DeepMind и других организаций показали, что ИИ-модели меняют смысл текста, даже когда их просят исправить только грамматику. Kimi AI, Qwen, DeepSeek и Grok всё чаще пробуют для текстов вместо ChatGPT, и выбирать среди них редактора на глаз рискованно.
По умолчанию нейросеть, которой дали текст на редактуру, переписывает его, хотя просили только править. Ограничить её можно только жёстким промптом и сравнением версий. Модели для редактуры надо сравнивать по тому, какую долю текста они изменили и сохранился ли смысл, а не по впечатлению, что стало лучше.

В админке нашего бота было два лимита: сколько ответов дать до передачи менеджеру и сколько бессмысленных сообщений терпеть подряд. Ни один не срабатывал: в условии стояло И вместо ИЛИ, а ветка передачи писала результат туда, откуда его никто не читал. Рассказываю, почему две ошибки прятали друг друга, как решение переехало в чистую функцию с 16 тестами и где в формулах лимитов прячутся ошибки на единицу.

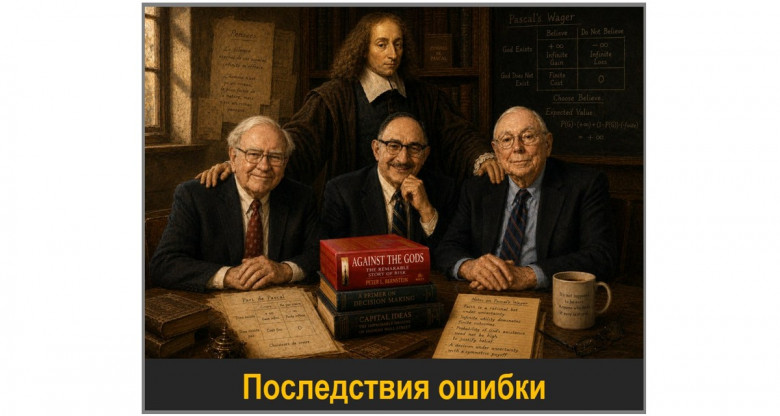
Питер Бернстайн, мудрец, о котором многие говорили, что он понимал природу риска лучше большинства, однажды получил вопрос о том, какие главные уроки о риске можно извлечь из его книги «Против богов» (Against the Gods). Бернстайн ответил: два урока.

Расскажу, почему вам нужно отказаться от bool и Option. На примерах Rust покажу, как описать режимы и состояния через enum, чтобы код было проще читать, а компилятор не позволял создавать недопустимые состояния.

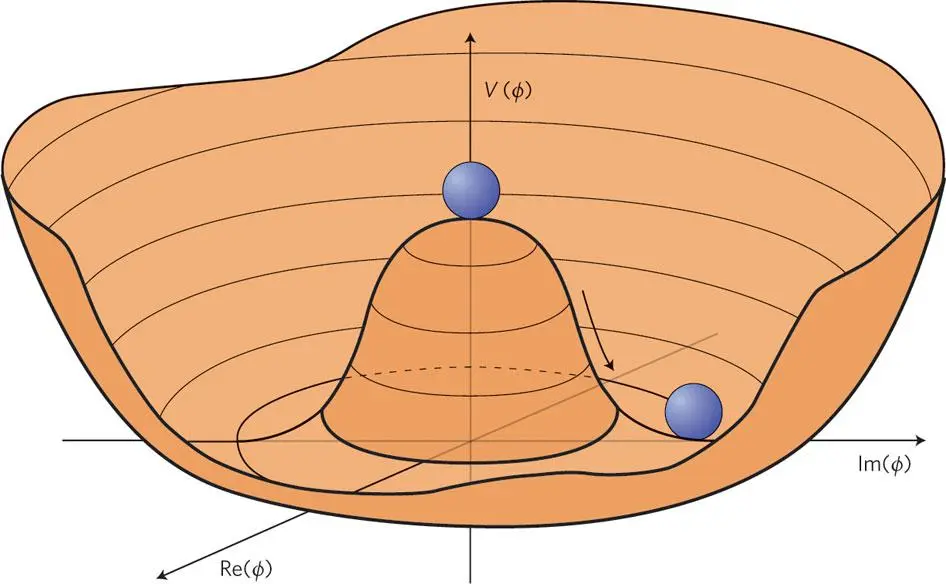
Итан Сигел (американский астрофизик‑теоретик и научный журналист, автор рубрики «Спросите Итана», один из пропагандистов современных научных знаний), разбирает вопрос о «естественности», или, скорее о кажущейся нам «неестественности» соотношений некоторых физических величин. Одни нам кажутся подозрительно близкими, другие непонятно почему различаются на многие порядки...
@avshkol сделал перевод этой статьи, чтобы разобраться в том, где «неестественность» кажущаяся, всего лишь отражение природы такой, какова она есть, а где такие совпадения или нестыковки могут потенциально привести нас к научному открытию?..

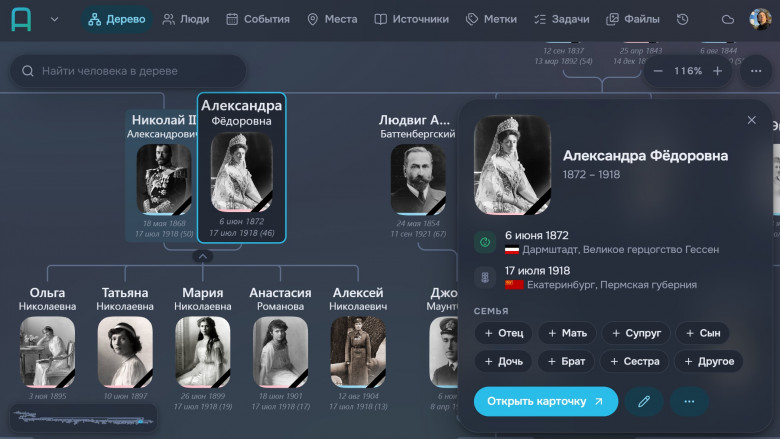
Несколько лет назад мне захотелось заняться составлением своего генеалогического древа. Я опробовал различные существующие инструменты для этого и не могу сказать, что остался в большом восторге. Во-первых, у подавляющего числа из них интерфейс, мягко говоря, оставлял желать лучшего, а во-вторых, большинство из них подразумевало хранение информации о всех своих близких где-то на серверах этих сервисов (причём ряд из них сейчас вовсе недоступен напрямую из России, что удобства не добавляет).
Разумеется, как у любого уважающего себя разработчика, у меня зачесались руки написать собственное решение. Благо в целом задача не выглядела сверхмасштабной, ведь хранилище семейной истории — это по сути небольшая БД с 6-8 типами сущностей и визуализатором связей между ними. Но, как это нередко бывает, идея застряла на стадии раннего прототипа, и только сейчас, благодаря помощи LLM её удалось довести до относительно законченного вида.
Ниже расскажу, что получилось и чем же именно мой сервис — я назвал его Arca — существенно отличается от других подобных решений. Кроме особенностей хранения проектов также затрону несколько других любопытных нюансов — выбранный мной подход к локализуемому представлению имён, а также исторических названий городов и регионов.
AI Overviews — нейроответ, который Google ставит над обычной выдачей. По слухам, что этот ответ стоит уже над 80% запросов. В первоисточниках так выходит только у Semrush, и только на 400 коммерческих ключах по десктопу США, а в других замерах получилось 30% и 18%. О проектах в Рунете эти цифры почти ничего не говорят: Яндекс не публикует, у какой доли запросов есть ответ Алисы AI, а каждый отчёт по Google описывает Google и набор запросов конкретного сервиса. Цифра больше 80% — свойство выборки, а не рынка. Для Рунета ориентир один: доля нейроответов Алисы AI в поиске на вопросах своей тематики.

Если работаешь c чувствительными данными или в высоко стрессовой среде, то цена ошибки может быть вполне серьезной. Вот зачем разбираться с собственной головой: заметить, что мешает нормально работать, пока последствия не заметили за тебя.

Представьте, что вы нанимаете программиста. Даёте ему 100 задач из реальных проектов, проверяете решения автоматическими тестами и получаете результат: 99 правильных.
Впечатляет. Особенно если программист — нейросеть.
Но затем выясняется, что часть экзаменационных заданий составлена неправильно. Некоторые тесты отвергают работающий код. Другие принимают неполные исправления. А в отдельных случаях испытуемый может найти готовый ответ в интернете.
Именно с такой проблемой столкнулись исследователи, оценивающие современных ИИ-агентов для программирования.
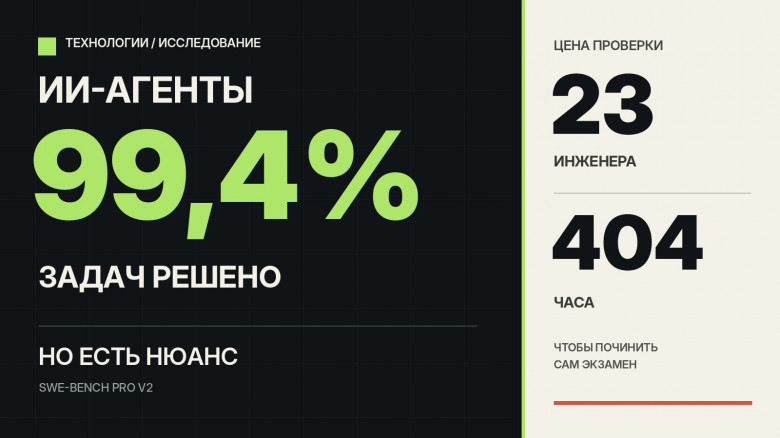
В сентябре 2026 года вышла обновлённая версия SWE-Bench Pro V2 — набора реальных инженерных задач из GitHub-репозиториев. Лучший результат на публичном наборе достиг 99,4%.
Но самое интересное в этой истории — не рекорд модели, а то, что пришлось сделать для его измерения.
Как ИИ-программистов вообще проверяют
Обычный тест по программированию выглядит просто: напиши функцию, которая сортирует массив, ищет элемент или обрабатывает строку.
Для современных моделей такие задания уже не особенно показательны.
В реальной разработке всё сложнее. Есть существующий проект, десятки файлов, зависимости, старый код и ошибка, которую нужно исправить, ничего не сломав.
Именно такие задачи используются в семействах бенчмарков SWE-bench.
Агент получает репозиторий в определённом состоянии и описание проблемы. Затем он может читать файлы, анализировать код, запускать тесты и изменять проект.
В конце оценивается полученный патч.
Изначальный SWE-Bench Pro содержал 1865 задач из 41 репозитория. Это существенно ближе к настоящей инженерной работе, чем отдельные алгоритмические упражнения.

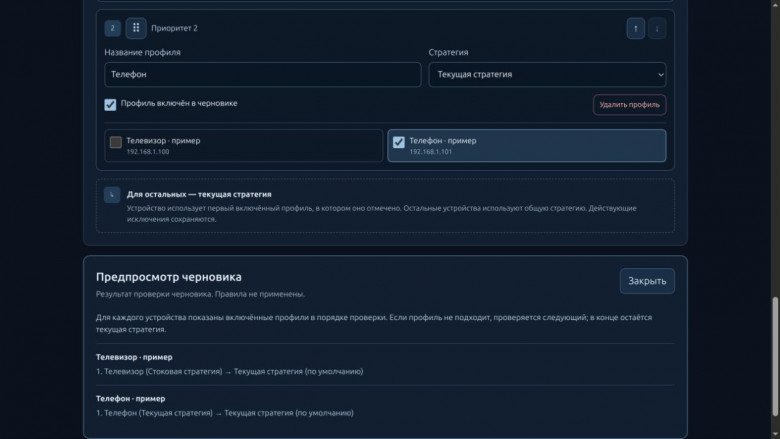
В первой статье «Как я адаптировал nfqws2 для ASUS и добавил поддержку OpenWrt» я рассказал, как установить проект и настроить общую стратегию. Теперь покажу, как назначать разные стратегии устройствам, проверять результат и переносить удачные настройки. Всё ниже доступно в Build 99.
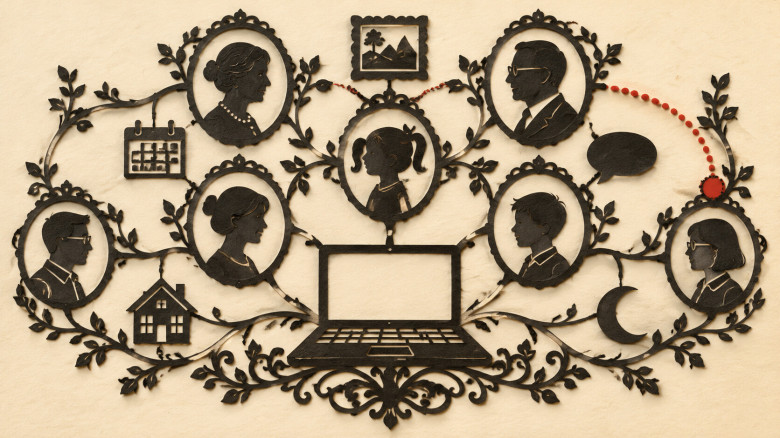
Начиная с macOS 13 два демона, knowledgeconstructiond и intelligenceplatformd, строят на каждом Mac граф о владельце и людях вокруг него. В каталоге ~/Library/IntelligencePlatform лежит 51 SQLite-база, а в graph.db — триплеты по словарю из 181 класса и 278 предикатов. Пара XGBoost-классификаторов по 144 признакам, в основном по тому, кому вы пишете и с кем фотографируетесь в какой день и час, оценивает, кто вам семья, а кто семья или друзья. Ещё пятнадцать столбцов, от матери до коллеги, заполняет механизм, который авторы проследить не смогли. Отозванные строки переезжают в отдельную таблицу и сохраняют уверенность и источники. Исследователи 8rank разобрали хранилище на macOS 26 и выложили локальную панель iKnow, чтобы каждый мог посмотреть свой граф.

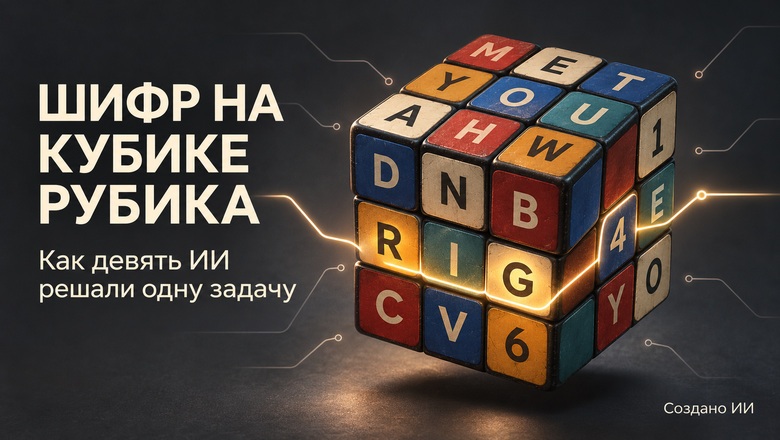
Из девяти ИИ-моделей задачу с шифром на кубике Рубика полностью решила одна, две выдали выдуманные ответы с ложной «проверкой», остальные честно признали неудачу.

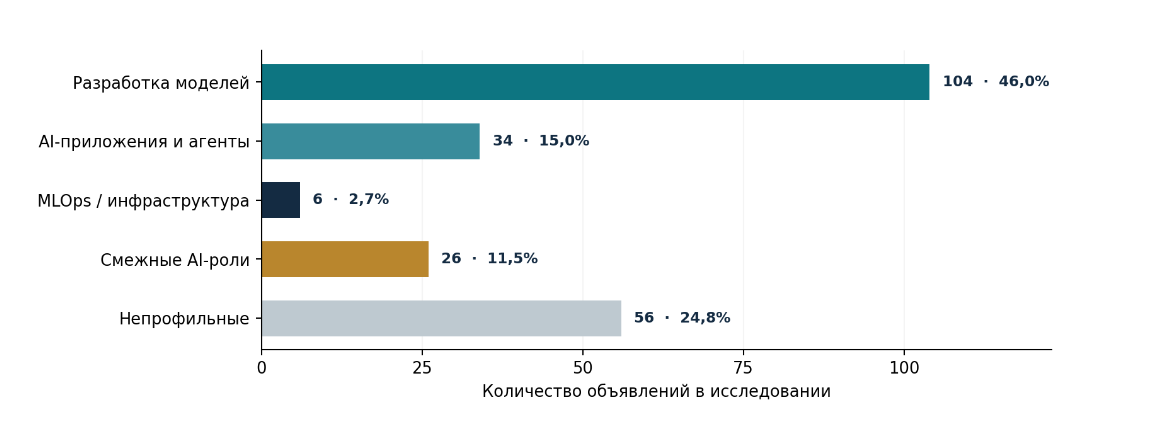
Рынок ML, DL и прикладного AI. Исследование 226 объявлений о работе на hh.ru
Вместе с нашей командой, мы пропарсили и обработали 226 вакансий с hh.ru. Подробно описали ниже.

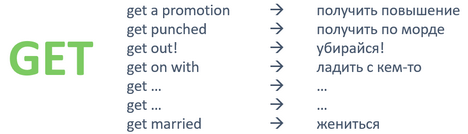
Современный Google переводчик это 249 языков, 100 миллиардов переведенных слов в день, 200 миллионов уникальных пользователей в день.