Обновить
128K+

Исследования и прогнозы в IT *

Исследования, тренды и прогнозы в IT-сфере

449,69
Рейтинг
Сначала показывать
Порог рейтинга
Уровень сложности
Формат публикации

Lexometrica Ground Truth: 15 LLM на 30 кейсах по практике ВС РФ
Уровень сложностиСложный
Время чтения10 мин
Охват и читатели7.2K

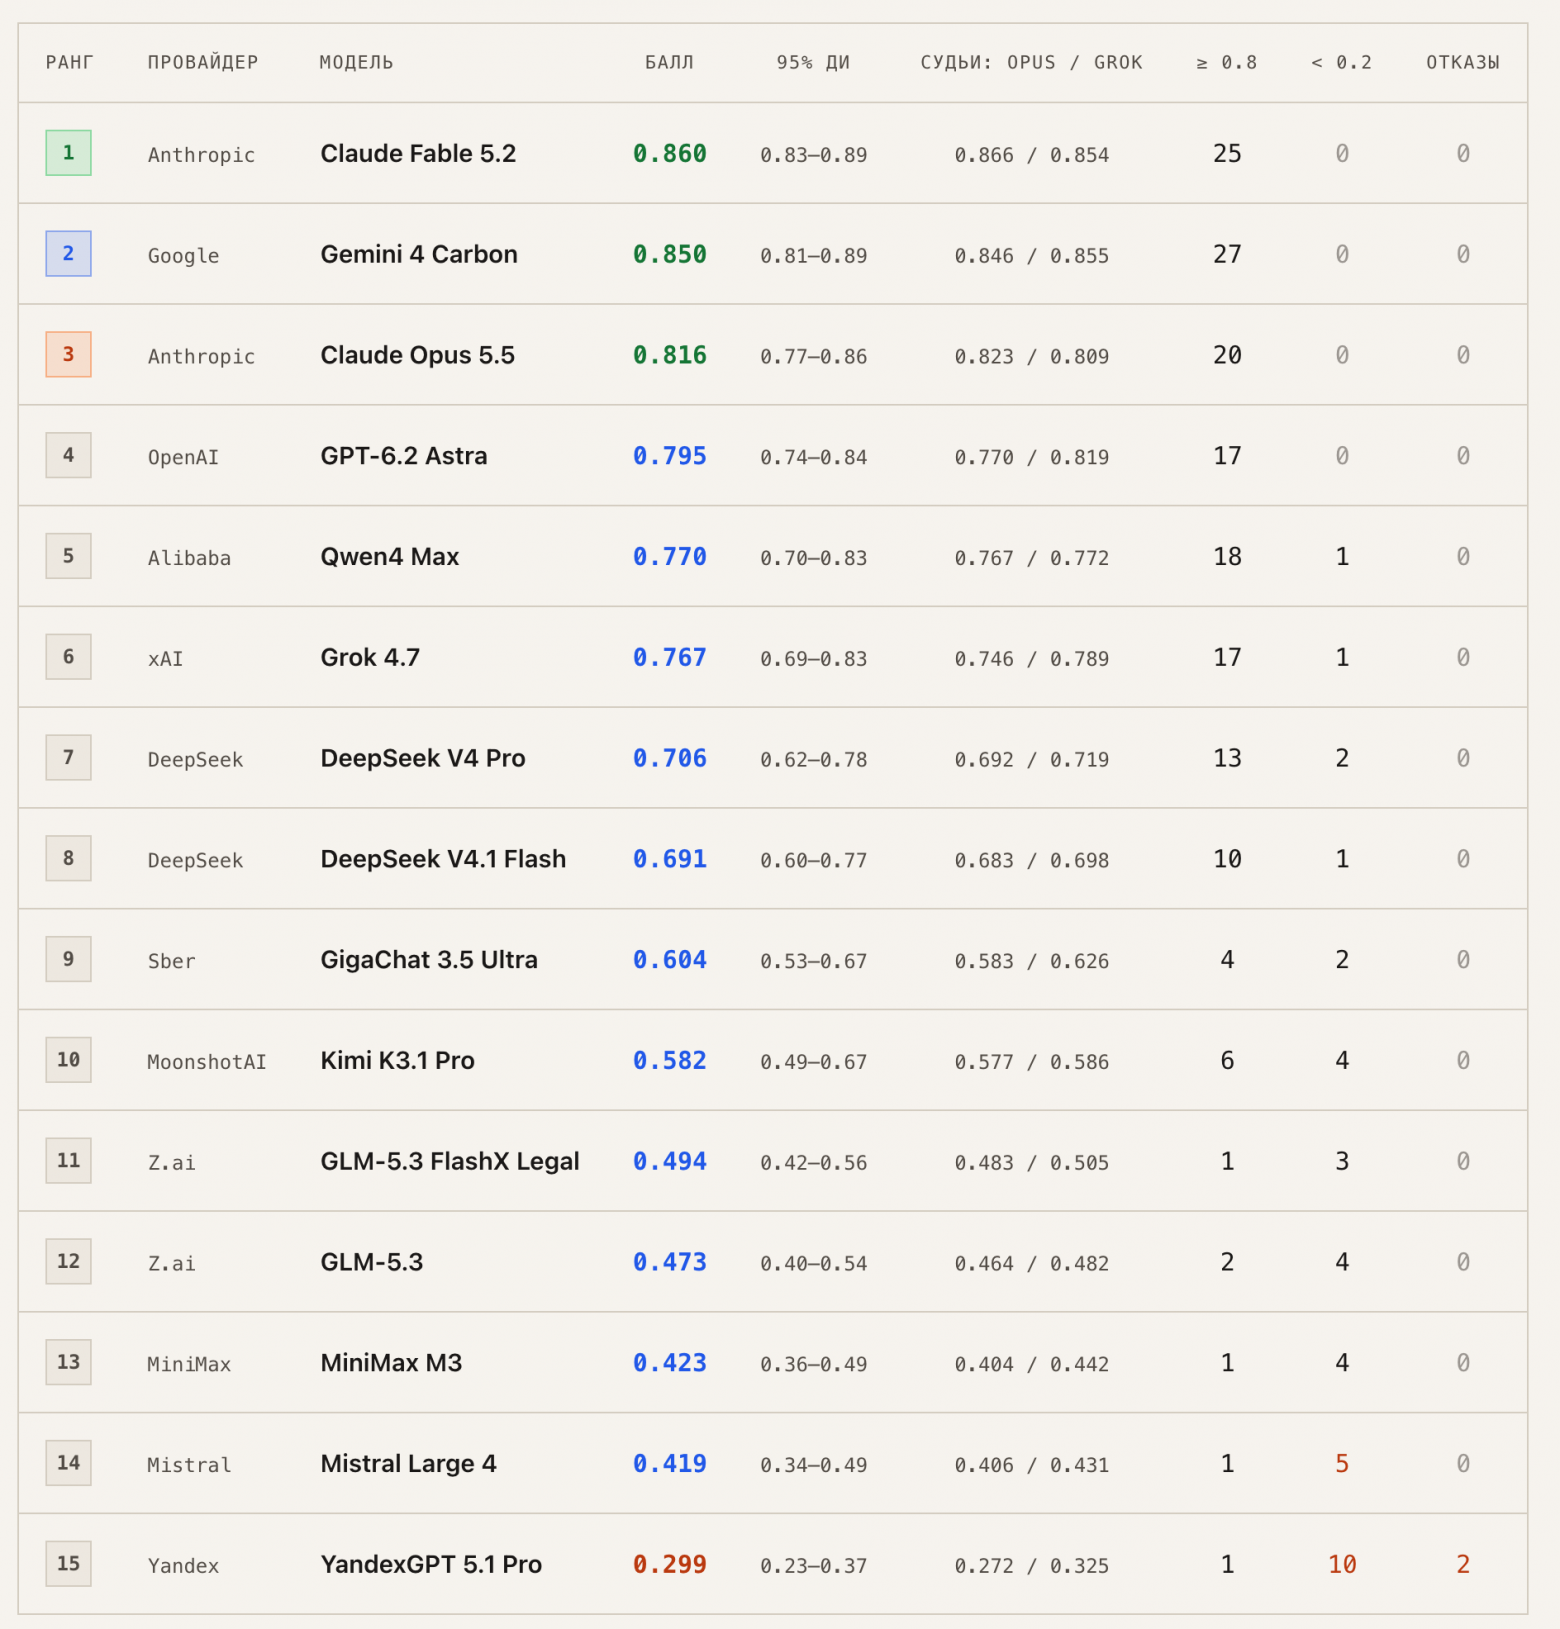
Рейтинги языковых моделей обычно читают как турнирную таблицу. Для юридических задач это мало что дает: различия между соседними строками, как правило, меньше погрешности измерения, а надежность модели-судьи, которая выставляет оценки, почти никогда не проверяется. В ноябре я повторил срез Lexometrica Ground Truth - 15 моделей, 30 закрытых кейсов по практике Верховного Суда РФ, два LLM-судьи - и на этот раз проверял не только модели, но и судей. Ниже - дизайн исследования, результаты и то, что удалось измерить про LLM-as-a-Judge: согласие судей, смещение судьи-участника и вклад судьи в общую погрешность. Полная версия с расчетами выйдет препринтом.

У замеров есть прикладная цель - в сервисе «неШемяка!» исход судебного спора прогнозируется по материалам дела пространным LLM-пайплайном. Модели в нем мы меняем на флагманские по мере их выхода, но дважды в год решили подтверждать выбор на собственном датасете. Предыдущий срез был в марте 2026 года, этот - в ноябре.

Читать далее

Вспоминаем, как NVIDIA стала мировым гигантом

Время чтения9 мин
Охват и читатели7.2K

В начале ноября 2026 года главным героем технологических новостей (и мемов) стал не новый ускоритель NVIDIA, а ее основатель Дженсен Хуанг, который возглавлял компанию 33 года. Он лично и компания в целом сейчас переживают не самые простые времена.

Если воздержаться от шуток, домыслов и слухов, то вся эта история заставляет задаться вопросами: что дальше будет с компанией, на которой держится значительная часть мировой ИИ-индустрии? Почему один человек влияет на рынок сотни миллиардов долларов? И как вообще вышло, что NVIDIA создала настолько масштабный вендор-лок? Чтобы это понять, придется вернуться на 33 года назад и проследить историю компании.

Читать далее

Подготовленное продолжение цифровой среды и другой ход: EXIT-0

Уровень сложностиСредний
Время чтения7 мин
Охват и читатели11K

Хороший интерфейс обычно старается не заставлять нас каждый раз начинать заново. Закончился ролик, следующий уже ждёт. Раунд завершился, можно начать новый. Переписка остаётся открытой там, где мы остановились. Документ помнит страницу, курсор и последние изменения.

Это удобно. Было бы странно, если бы после каждого ролика YouTube спрашивал, хотим ли мы продолжать смотреть видео, открыть калькулятор или, на всякий случай, заполнить налоговую декларацию. Огромная часть интерфейсной работы как раз направлена на обратное: рекомендации, автопроигрывание, бесконечные ленты, сохранённый прогресс, следующий раунд, «продолжить с того же места». Продолжение должно происходить легко.

Подготовленное продолжение

JEDEC анонсировали первые параметры DDR6: чем она отличается от DDR5 и где это будет заметно

Уровень сложностиСредний
Время чтения5 мин
Охват и читатели6.6K

18 ноября JEDEC рассказала, какой будет DDR6. В первую очередь DDR6 рассчитана на дата-центры, облака и ИИ, но в планах есть и клиентские ПК. Стандарт еще в разработке, и организация отмечает, что все параметры предварительные, они могут измениться.

Читать далее

Выходные, автор и длинные слова: с чем связаны просмотры 46 тысяч статей Хабра

Уровень сложностиСредний
Время чтения25 мин
Охват и читатели6.9K

Пока моя первая статья для Хабра ждала правок от редактора, я задался простым вопросом: когда её лучше публиковать? Почитал существующие разборы, но прямого ответа не нашёл. Пришлось копать глубже. Так появилась вторая статья, которая, по иронии судьбы, выходит раньше первой. Неплохое начало для исследования о времени публикации.

Лорду Морли приписывают слова: «В речи имеют значение три вещи: кто говорит, как говорит и что говорит. Из этих вещей наименьшее значение имеет третья». К ним я добавил четвёртую — когда — и попробовал проверить, что из этого видно на Хабре.
Я собрал данные о 46845 статьях, изучил язык 1516 текстов и построил модели прогноза популярности. Из-за собственных ошибок несколько выводов пришлось вычеркнуть. Самые поучительные промахи разобрал в разделе 9.

Читать далее

Что Apple готовит для ИИ-агентов на Mac

Время чтения3 мин
Охват и читатели7.9K

14 шагов вместо четырех. Столько действий, по данным Bloomberg, теперь нужно пользователю ChatGPT, чтобы разрешить стороннему инструменту управлять Mac в бете macOS 27.3. Одновременно с этим выяснилось, что сама Apple разрабатывает собственного автономного агента, который умеет писать код, ходить по сайтам, управлять приложениями и устройствами от имени пользователя. Проводим расследование ниже.

Читать далее

Что не так со снятием Дженсена Хуанга

Время чтения8 мин
Охват и читатели7.4K

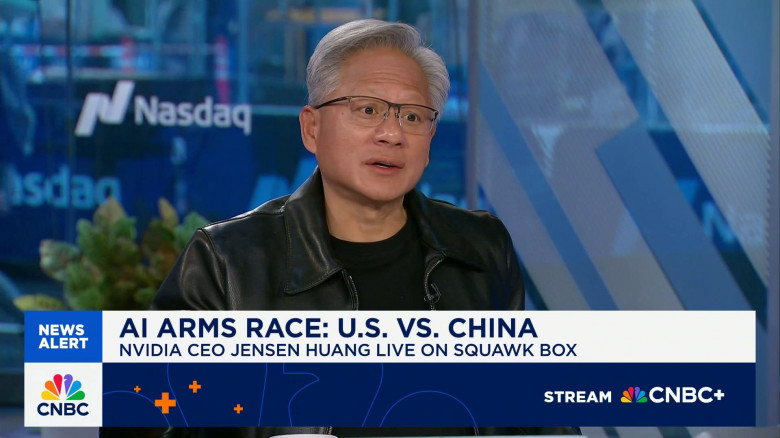
Проблема с саги Дженсена Хуанга, бывшего CEO Nvidia не в том, продавал ли он — сознательно или нет — чипы в Китай в обход санкций в ИИ-гонки США против КНР, а в имплицитном принятии подспудного посылка, что США с КНР находятся в состоянии ИИ-гонки, эдакого цифрового ремейка гонки ядерных вооружений США и СССР, потому что первое, что нужно сказать: никакой «гонки ИИ» между США и КНР нет.

Есть только нарратив об ИИ-гонке, звучащий только с одной стороны — стороны США, и имеющий внутреннее назначение: это лоббистский нарратив техноолигархата США, баронов Кремниевой долины, для воздействия на госполитику и ресурсы государства США. Для того, чтобы «ИИ-гонка» была реальностью, каковой была та же гонка вооружений XX века, в ней должны принимать участие две стороны — а подход КНР к ИИ совершенно, радикально иной, нежели у «бро-лигархов», никакой гонки не подразумевающий. (Какой — тема для отдельного материала, и, возможно, на Хабре найдутся те, кто смогут об этом рассказать лучше меня.)

Второе, и даже более важное, что нужно указать: никакой гонки за ИИ между США и КНР и кем-либо ещё не должно быть в принципе, т.к. именно отношение к ИИ как к орудию (оружию) разрешения экономической (за рынки) и/или политической (за раздел мира) борьбы толкает развитие ИИ по направлению, которое делает его угрозой — точно так же, как Холодная война направила открытую учёными способность распоряжаться энергией атома по пути создания оружия планетарного самоуничтожения вместо того, чтобы приложением того же количества усилий, что ушло на создание ядерных арсеналов, к мирному атому, с избытком обеспечить потребности человеческой цивилизации в экологически чистой и достаточно безопасной энергии.

Читать далее

Дашборд команды из Jira за час вместо месяца: как ИИ-агент собирает пульс спринта

Время чтения4 мин
Охват и читатели5.8K

Раньше качественный дашборд по командам из Jira аналитик собирал порядка месяца. Теперь сборка зашита в скиллы ИИ-агента, данные обновляются сами, и борд для новой команды я собираю максимум за час.

Немного контекста. Я был CTO, в инженерном блоке было больше 50 человек. Сейчас руковожу платформой на 2000 финансовых операций в секунду. Борды команд мне нужны каждый спринт, а ждать месяц на каждый новый борд я не готов.

Ниже — как это устроено, что видно на таком борде и где агент ошибается. Последнее, по-моему, самое полезное.

Читать далее

Код-ревью в команде Linear

Уровень сложностиСредний
Время чтения7 мин
Охват и читатели5K

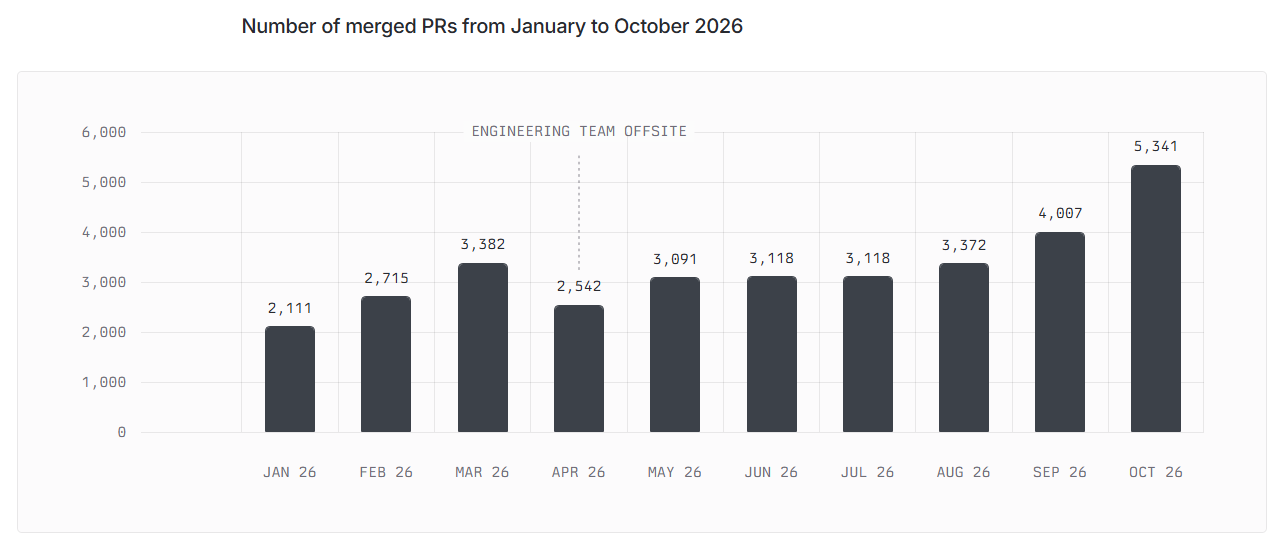
Идея, которая совсем недавно считалась излишне радикальной, постепенно внедряется в практику: ИИ-агенты генерируют код с такой скоростью, что человек физически не успевает его вычитывать — а значит, пора перестать этим заниматься.

Команда из Linear выкатила подробный разбор с цифрами: за десять месяцев 2026 года количество PR выросло на 153%, а больше половины изменений теперь улетают в мастер вообще без второго ревьюера.

Читать далее

Как я написал 2 языка программирования и решил отказаться от разработки ЯП вовсе…

Уровень сложностиПростой
Время чтения6 мин
Охват и читатели5.4K

Как-то я занялся решением алгоритмических LeetCode-задачек. Так как я больше привык к реальным, прикладным задачам, для меня это было достаточно дико поначалу. Затем втянулся: это как решать головоломки. Я люблю разгадывать судоку, например, и в шахматы играть — это из той же оперы, развлекуха.

Так вот, решая задачки, я переосмыслил программирование в принципе и задался вопросом — почему такие простые задачки нужно решать так сложно? Ведь некоторые вещи достаточно очевидно решаются на уровне понимания, но становятся сложными на уровне написания кода.

И это касается не только разработки. Так же обстоит дело и в математических вычислениях — наверное, потому что у них общие корни. Я периодически размышлял над этим, когда делал рабочие проекты и свои pet project-ы. И пришел к выводу, что основная причина — это закрытость. Многое делается под капотом, и разработчику (читай — пользователю языка) нужно многое додумывать, многое держать в голове, о многом догадываться, многое проверять.

Отсюда растет сложность, отсюда множатся ошибки, отсюда разработчики частенько выгорают. Забавно, что наши боли породили целую индустрию решателей таких болей — и даже не одну: тестирование, продуктивность, мотивация, лечение от выгорания, курсы программирования… (И все потому, что мы простые вещи делаем сложными способами.)

Тогда я задался вопросом, а как бы я сделал? Как можно сделать по-другому? Наглядно и удобно, очевидно и просто? И пришел к очевидному выводу: надо сделать модель того, что происходит под капотом, когда исполняется код. И тогда я смоделировал обход списка с выполнением действия — по сути, foreach. У меня получился странник, который идет по 1D-карте. Если добавить вложенный for, то странник уже идет по 2D-карте и так далее…

Но мой подход был реализован теми же закрытыми средствами, и поэтому наглядности не получилось: да, метафорично, но не видно ни карты, по которой идет путник, ни самого путника. Тогда я остановился на этом и перешел к написанию ЯП — правда, цель у меня была другая :)

Читать далее

ИИ в CRM-системах: ИТ хочет быструю разработку, а бизнес – эффективность процессов

Уровень сложностиПростой
Время чтения4 мин
Охват и читатели5.9K

Привет! Мы в BPMSoft (ИТ-холдинг LANSOFT) вместе с экспертно-аналитическим центром издательства «Открытые системы» решили выяснить, что крупный российский бизнес ждет от искусственного интеллекта в CRM, и какие есть помехи на пути его внедрения.

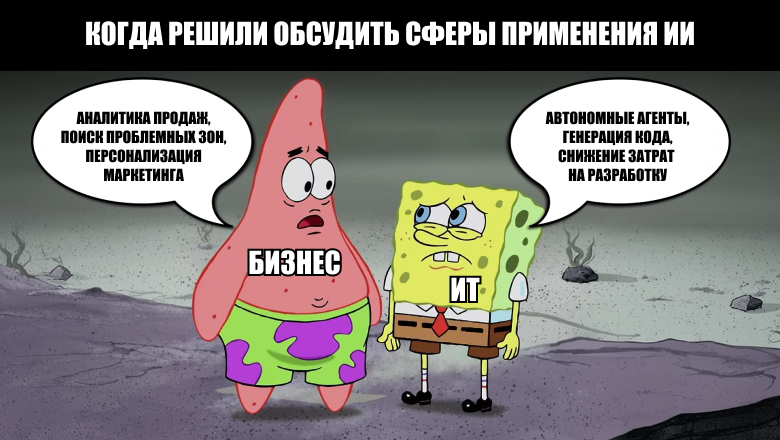
Один из наиболее любопытных результатов исследования – заметное расхождение во взглядах ИТ-специалистов и представителей бизнеса на перспективы ИИ. Особенно это заметно в отношении к автономным ИИ-агентам: 37% представителей ИТ-подразделений считают их важными, и лишь 4% бизнес-респондентов соглашаются с этой оценкой. Менее явные, но все же достаточно очевидные расхождения обнаружились и в оценке сфер применения ИИ в CRM.

Посмотрим, какие тенденции показал опрос и откуда взялась эта разница в восприятии.

Читать далее

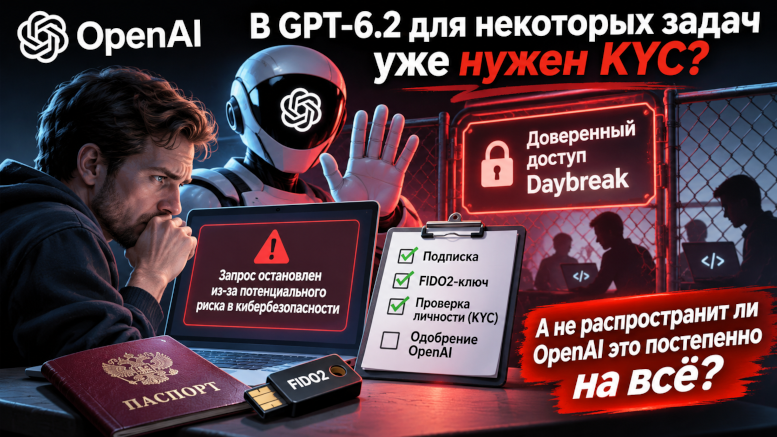
В GPT‑6.2 для некоторых задач уже нужен KYC. Не станет ли это новым ограничением для обычных разработчиков?

Уровень сложностиСредний
Время чтения16 мин
Охват и читатели15K

17 ноября OpenAI представила GPT‑6.2 Astra и Sol. Новые модели стали сильнее в программировании и решении сложных задач, но вместе с ними появились дополнительные ограничения, о которых, подозреваю, знают далеко не все пользователи ChatGPT и Codex.

Изучая документацию, обнаружил интересную деталь: для получения более свободного доступа к некоторым возможностям моделей в области кибербезопасности уже предусмотрены проверка личности, дополнительные требования безопасности и отдельное одобрение OpenAI. Речь не о том, что паспорт нужен для каждого запроса к GPT‑6.2. Модели доступны и без него, но с более строгими ограничениями. А вот возможность выполнять некоторые задачи с меньшим количеством отказов уже зависит не только от подписки.

Причём у OpenAI существуют разные уровни доверенного доступа, а процесс получения разрешений устроен гораздо сложнее, чем просто отправка паспорта. Но не распространит ли OpenAI постепенно подобные проверки на другие категории задач, а затем и на обычных разработчиков? Учитывая собственный опыт блокировки оплаченного Claude Max 20x после проверки личности и недавние проблемы при работе с Codex, этот вопрос кажется мне далеко не праздным.

Давайте разбираться.

Читать далее

Вышел Gemini 4 Neon. Золотая середина, по мнению Google

Время чтения3 мин
Охват и читатели9.1K

18 ноября 2026 года Google представила Gemini 4 Neon — по сути, недостающее звено в своей новой линейке. До этого момента приходилось выбирать между быстрой моделью Hydrogen для простых скриптов и рутины и мощной, но дорогой Carbon. 

Neon ориентирован на технические задачи: разработку, аналитику, научные исследования и корпоративные процессы. Эта модель — некий баланс между мощной но дорогой Carbon и повседневной и дешевой Hydrogen. Давайте посмотрим, как она устроена, что показывает в тестах и стоит ли переводить на нее свои пайплайны.

Читать далее

Ближайшие события

Исследование: запрет мобильных телефонов в школах повышает успеваемость

Время чтения2 мин
Охват и читатели7.7K

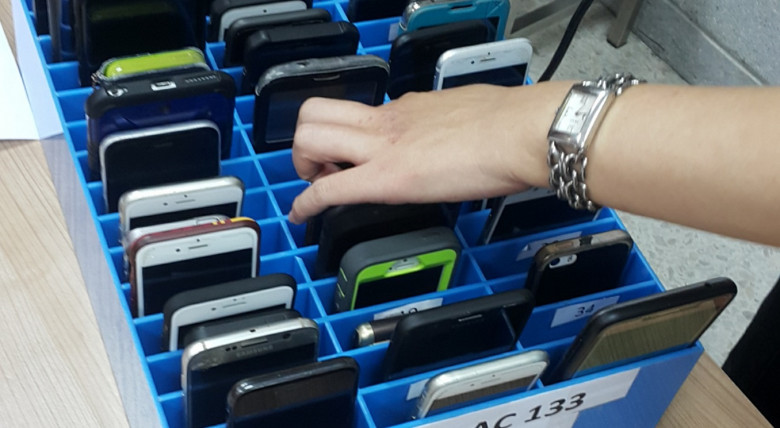
Запрет на использование мобильных телефонов действительно помогает учиться — к такому выводу пришли в Центре исследований образовательной политики при Гарвардском университете. Эксперты Центра выяснили, что в школах, где действуют подобные меры, показатели по математике и чтению улучшились — как если бы ученики получили дополнительную пару недель по предмету, пишет The New York Times. 

Читать далее

Мир Кузи: ИИ, который не разговаривает, а принимает решения

Уровень сложностиСредний
Время чтения8 мин
Охват и читатели7.5K

Decision Models — новый класс моделей искусственного интеллекта

Это статья из серии «Мир Кузи». Decision Models — новый класс моделей искусственного интеллекта. Они не разговаривают с человеком, а принимают решения: выбирают вариант, проверяют условие или ставят оценку. Разбираю, чем они отличаются от классических классификаторов и LLM, какие модели уже есть — Jev, Liquid d1, Gemini Decision, Kev — и где их применять. В конце — бонус.

Читать далее

Anthropic выходит на биржу с оценкой $1,5 трлн: $900 млрд обязательств за вычисления и $104 млрд убытка

Время чтения6 мин
Охват и читатели6.2K

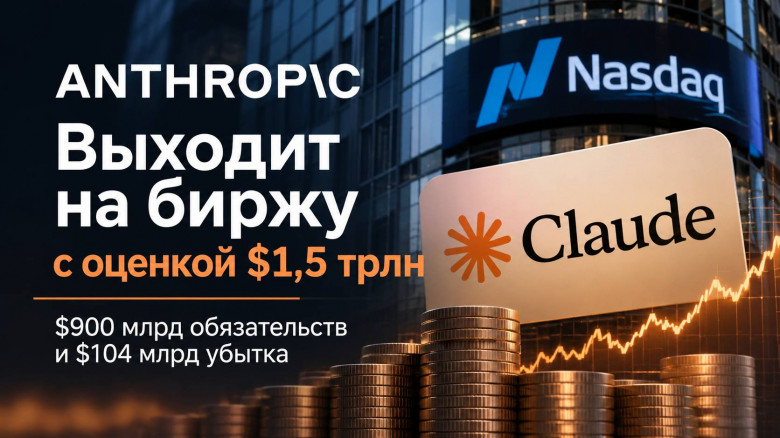
Anthropic провела IPO по цене $83 за акцию, привлекая $81,34 млрд. Параллельно компания разместит ещё $26 млрд акций среди стратегических инвесторов. Однако в финансовой документации Claude есть и другие впечатляющие цифры: выручка за девять месяцев выросла на 1206%, а обязательства по закупке вычислительных мощностей и инфраструктуре приблизились к $901 млрд.

Сегодня на Nasdaq должны начаться торги акциями Anthropic под тикером ANT. Компания оценивается примерно в $1,5 трлн с учётом потенциального разводнения акций. Это одно из крупнейших публичных размещений в истории.

Первоначально Anthropic планировала разместить акции по цене $70–78, но в итоге установила её на уровне $83. Всего инвесторам предложено 980 млн акций на $81,34 млрд. Из них 956,35 млн продаёт сама компания, остальные 23,65 млн принадлежат действующим акционерам. Андеррайтеры также получили опцион на покупку дополнительных 147 млн акций.

Одновременно с IPO Anthropic проводит частное размещение ещё на $26 млрд. Среди участников — Google, NVIDIA, AMD, Broadcom, Micron, Microsoft и TSMC. В совокупности объём двух сделок достигает $107,34 млрд до учёта комиссий и расходов.

Читать далее

Слишком важна, чтобы стоить дорого, или Что случилось с Nvidia

Уровень сложностиСредний
Время чтения19 мин
Охват и читатели12K

Разбирая октябрьский обвал ИИ-акций, я предполагал, что главной точкой отсчета станет ноябрьский отчет Nvidia. За три недели до него компания успела пережить скандалы, интриги, расследования и отставку основателя, у которого обнаружился роман с предполагаемой китайской шпионкой и пара служебных романов вдогонку. А 17 ноября Nvidia отчиталась о лучшем квартале в своей истории, 115,8 млрд долларов выручки — вдвое больше, чем годом раньше. Читала цифры уже финансовый директор Колетт Кресс, временно занявшая кресло основателя и главы компании Дженсена Хуанга. Пока одни инвесторы в панике сбрасывали акции, другие перекладывали деньги в бумаги соседей по отрасли, Nvidia, следуя разрешению совета директоров, выкупила собственные акции еще на 227 млрд долларов. А Васька слушает да ест.

При этом относительно своей прибыли Nvidia стоит так дешево, как не стоила с 2012 года, и объяснение «все из-за любовницы» здесь слишком удобное. Компания давно стала узким горлышком, от которого зависит весь мировой ИИ. При этом в самой компании уже тридцать три года очень многое, я бы сказал слишком многое, зависело от одного человека. А для Штатов, которые привыкли на уровне стран решать, кто кому должен, такая ставка оказалась слишком дорогой, и смена ключевого звена через постельный скандал выглядит самым мягким из возможных вариантов. Условный «кирпич с крыши на голову кому надо» обошелся бы рынку куда дороже. Попробуем разобраться, почему Nvidia стоит так дешево после лучшего квартала в своей истории и при чем тут вечные разговоры об отрицательном платежном балансе США.

Читать далее

Вторая модель проверяет ответ ИИ-консультанта до отправки: как это устроено и чем за это платишь

Время чтения4 мин
Охват и читатели5.7K

В Konsul, моём ИИ-консультанте по сайту компании, ответ можно пропускать через вторую модель. Она сверяет каждое утверждение о компании с найденными источниками. Если хоть что-то не подтвердилось, клиент этот ответ не увидит: он получит отказ, а диалог уйдёт сотруднику. Одна проверка стоит около 0,08 ₽ — это расчёт, на живом трафике я его ещё не сверял. И по умолчанию проверка выключена.

Ниже — что с чем сверяется, когда ответ считается подтверждённым, что видит клиент, почему ответ больше не печатается по словам и где проверка ничего не даёт.

Читать далее

Охваты можно купить. Возвращение человека завтра нельзя: что мы поменяли в первых 48 часах

Время чтения2 мин
Охват и читатели4.1K

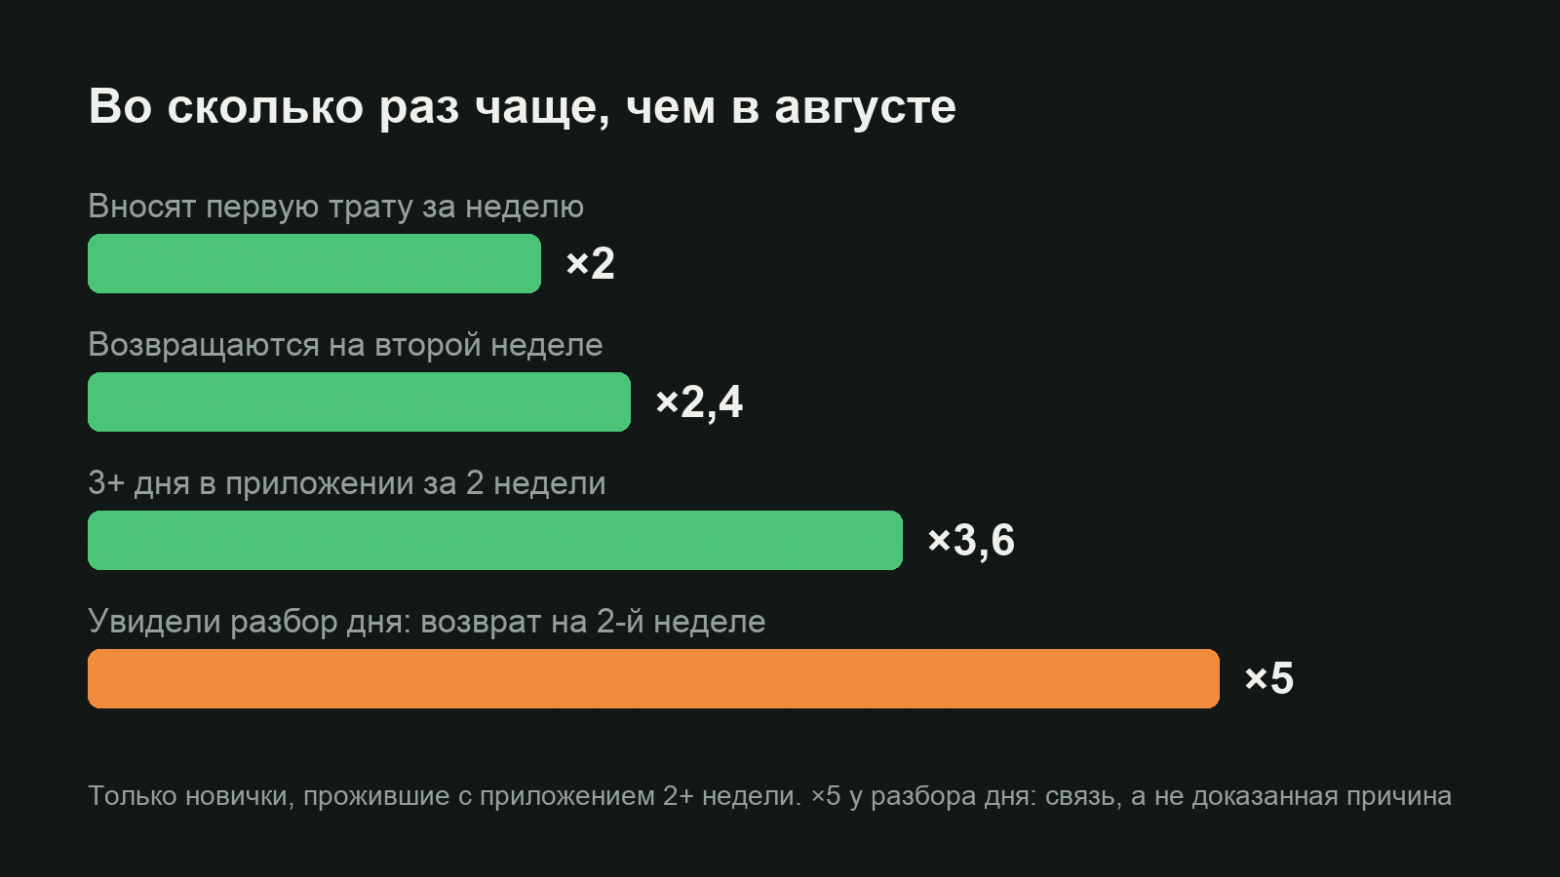
Это четвертый пост серии «Месяц без найма». В первых трех я рассказывал про каналы, которые дали охваты, но почти не дали установок. Параллельно я молча занимался другим: тем, что происходит с человеком в первые двое суток после установки. И именно это выросло сильнее всего.

Читать далее

Ограничение данных для российских моделей приведет к потере их конкурентного преимущества

Время чтения4 мин
Охват и читатели5.1K

Российские большие языковые модели справляются лучше иностранных нейросетей в задачах, где требуется знание русского языка, истории и локального культурного контекста. При этом сохранить это преимущество можно только при наличии достаточного для обучения объема как качественных русскоязычных данных, так и данных на других языках. К такому выводу пришли авторы исследования российского рынка LLM и данных для их обучения, подготовленного Институтом ИИ ИТМО при участии экспертов ИТМО, МГУ, РАНХиГС, ВШЭ, AIRI и российских технологических компаний. 

Читать далее
1
23 ...