Обновить
128K+

Обработка изображений *

Работаем с фото и видео

90,6
Рейтинг
Сначала показывать
Порог рейтинга
Уровень сложности

Одна картинка -шедевр, сто картинок -катастрофа: как я пытался укротить AI-генерацию ассетов для инди-RPG
Уровень сложностиПростой
Время на прочтение11 мин
Охват и читатели372

Разработка инди-игры - это постоянная борьба с ресурсами. Обычно не хватает времени, денег, людей и, желательно, ещё пары часов в сутках.

Когда я начал делать Morveyn (https://habr.com/ru/articles/1100432/)- пошаговую RPG для Telegram, вдохновлённую классическими фэнтезийными стратегиями вроде King's Bounty, - довольно быстро выяснилось, что написать игру и наполнить её контентом - две совершенно разные задачи.

С технической частью всё было относительно понятно: Next.js на фронтенде, Java на бэкенде, игровая логика, взаимодействие с сервером, генерация карты. Это привычная территория разработчика.

А вот графика оказалась отдельным приключением.

Игре нужны десятки, а в перспективе сотни изображений: юниты, портреты персонажей, здания, объекты окружения, тайлы глобальной карты, иконки и элементы интерфейса. Причём всё это должно выглядеть так, будто создано одним художником для одной игры.

Нанимать художника для каждого экспериментального ассета на стадии MVP было нерационально. Поэтому я решил попробовать генеративный AI.

В итоге основным инструментом стал Gemini.

И тут началось самое интересное.

Читать далее

Новости

Фотосессия стоматологов без фотосессии за $3: FLUX.3 klein + ComfyUI + RunPod = 290 кадров

Уровень сложностиСредний
Время на прочтение16 мин
Охват и читатели7.6K

Я настраиваю платный трафик для стоматологических клиник (и не только). Для хороших креативов всегда нужны фото врачей: настоящее лицо врача в кабинете работает лучше стока. Но для клиники фотосессия врачей превращается в отдельный проект с большими временными и денежными тратами. Врачи заняты пациентами, кабинеты заняты, фотографу надо платить, а хорошему надо платить много. Через месяц нужны новые кадры, потому что старые креативы выгорели. В общем, для стоматологий это долгая и дорогая морока. Я понимал это с самого начала и решил пойти другим путём.

Читать далее

Как я рисовал NFT-подарки Telegram в 60 fps, не имея API: бот для эмодзи, стикеров и подарков

Уровень сложностиСредний
Время на прочтение7 мин
Охват и читатели3.7K

В Telegram есть премиум-эмодзи, паки стикеров и NFT-подарки. Всё это красиво выглядит, но достать оттуда что-то для своей работы неудобно. Скачать пак целиком нельзя. Чтобы узнать custom_emoji_id, нужен отдельный бот или отладчик. А анимацию подарка вне Telegram можно разве что записать с экрана.

Я написал бота Emoji Studio, который всё это делает. В статье — не столько про сами функции, сколько про несколько интересных задач, которые пришлось решить по дороге:

Читать далее

Дедупликация фото без нейросетей. Часть 1: измеряем перцептивные хеши

Уровень сложностиСредний
Время на прочтение9 мин
Охват и читатели5.7K

Недавно у нашей команды появилась необходимость отвечать на вопрос: А такое фото у нас уже есть?». Не «такой же файл» — его можно было бы легко проверить по SHA-256, — а именно такое же фото: пережатое, уменьшенное, с чужим логотипом поперёк кадра, подрезанное по краям.

Про перцептивные хеши на Хабре написано много, почти везде разбирают устройство алгоритма. Мне же хотелось понять, что он выдерживает. Поэтому я взял двадцать фотографий, изменил каждую двадцатью шестью способами из тех, что реально случаются при перезаливе, и посчитал расстояния.

Это первая часть из двух. Она про то, что хеши умеют и где ошибаются: водяные знаки, геометрия кадра, выбор метода, длина хеша, порог. Во второй части я расскажу, как из этого сделать работающую систему: предобработка, зеркало и поиск в PostgreSQL с бенчмарком на десяти миллионах строк.

Читать далее

Автоматизация моего процесса сканирования 35-миллиметровых плёнок

Время на прочтение7 мин
Охват и читатели6.3K

Я люблю фотографию. Есть что‑то волнующее в наблюдении за изображением через объектив, выстраивании кадра для получения композиции и работы над получившимся фото. Я менял зеркальные и беззеркальные камеры, пока, наконец, не влюбился в Canon AE-1P — аналоговую зеркалку, с которой мой отец путешествовал по миру, пока, наконец, не обосновался в Штатах.

Фотосъёмка на плёнку проста, но специфична: отражённый свет падает на пластмассовую плёнку, выжигая в ней химическое изображение. Сочетание освещения, типа плёнки и объектива создаёт волшебно‑уникальные композиции.

Долгие годы мой процесс работы выглядел так: я заправляю плёнку и делаю фотографии, отправляю плёнку в лабораторию и жду проявки, забираю плёнку, разрезаю негативы на полосы, вставляю их в держатель, сканирую негатив каждого кадра специальным сканером, открываю каждый файл в Darktable, инвертирую вручную, вношу правки, а затем решаю, где хранить и/или публиковать экспортированное изображение. Поначалу этот процесс казался мне восхитительным, но чем больше я снимал плёнок, тем больше времени уходило на обработку всех 36 её кадров.

Читать далее

Сколько стоит интеллектуальная автоматизация: четыре кейса, бюджеты и стоимость эксплуатации

Время на прочтение19 мин
Охват и читатели4.2K

Привет, Хабр! Меня зовут Мирза, я руководитель проектов ROBIN и Robovoice компании SL Soft. «Сколько стоит автоматизировать наш процесс?» — один из самых частых вопросов, с которым к нам приходят компании. Для одного проекта достаточно робота на обычном компьютере. Для другого нужны распознавание документов, языковая модель и сервер с GPU. Даже при одинаковом числе часов разработки бюджеты будут различаться.

Разница становится еще заметнее после запуска. Робот требует доработки, когда меняется сайт. У решения с ИИ нужно разбирать ошибки на новых документах. Голосовой ассистент расходует минуты связи и ресурсы распознавания речи. Эти затраты стоит посчитать до подписания договора.

Поэтому разберем из чего складывается бюджет, на четырех реальных задачах из нашего опыта: автоматизация закупок, работа с документами, корпоративный ассистент и запись пациентов по телефону.

Читать далее

Компьютерное зрение на микроконтроллере за $2: SIMD на ESP32-S3 ускорил FAST в 2,2 раза

Время на прочтение4 мин
Охват и читатели11K

У ESP32-S3 есть 128-битные SIMD-инструкции, но примеров кода под них почти нет: автор нашёл всего три источника. Он написал на них детектор углов FAST и упёрся в два ограничения набора инструкций. Невыровненные блоки пикселей напрямую не читаются, а сравнивать можно только знаковые байты, причём вся арифметика с насыщением, так что вычесть 128 из беззнакового пикселя обычным вычитанием нельзя. Первое обошла инструкция, которая вырезает кусок из двух склеенных регистров, второе — XOR с 0x80. Итог в тестах автора — 11,2 мегапикселя в секунду вместо 5,1: этого хватает на поток VGA при 30 кадрах в секунду.

Читать далее

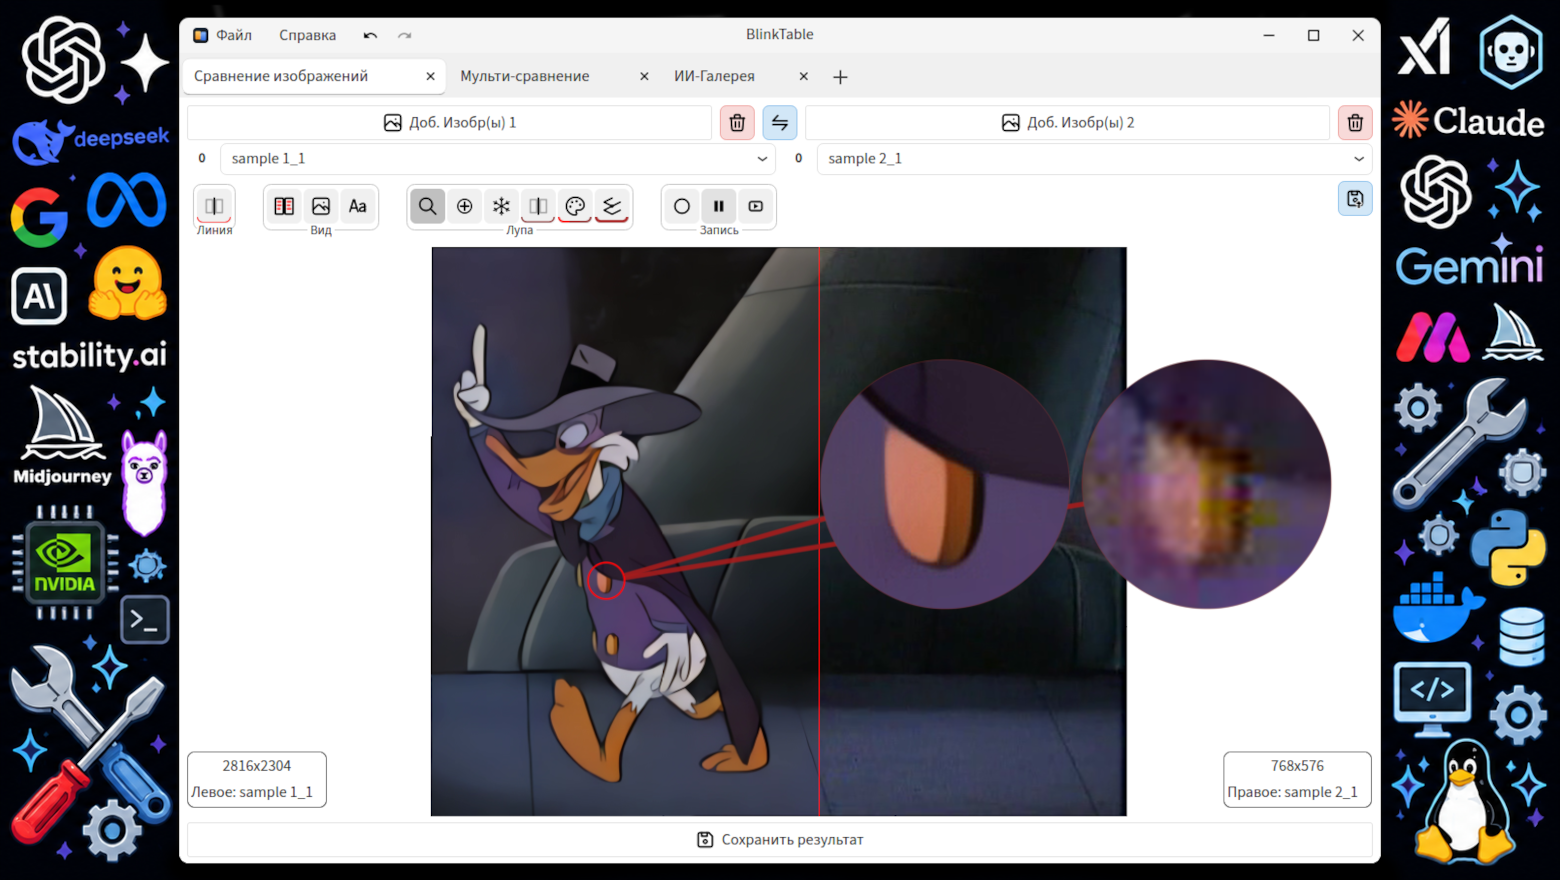
Как я 2,5 года никому не нужный софт вайбкодил

Уровень сложностиСредний
Время на прочтение11 мин
Охват и читатели20K

По моим прошлым статьям «Искусство цифрового мазохизма: как я потратил сотни часов на обложки для сериалов, которые даже не смотрю» и «Как я сделал ремастер «Том и Джерри» в 4K за два года» многим стало очевидно, что я умею находить себе самые нерациональные и специфичные занятия на пару месяцев, а то и лет.

И в этот раз я захотел сделать программу, чтобы ускорить процесс и просто сравнивать изображения апскейлинга бок о бок, но всё быстро вышло из-под контроля, превратившись в новое бессмысленное хобби с ворочанием армии ИИ-агентов.

Читать далее

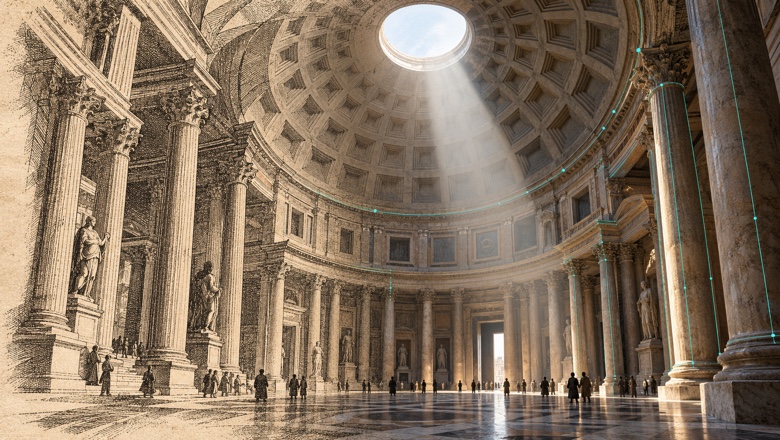
Пиранези против ИИ: фотография или гравюра?

Уровень сложностиПростой
Время на прочтение8 мин
Охват и читатели6.9K

На маленьком экране виды Рима у Пиранези легко принять за фотографии. При увеличении проступают штрихи. Можно ли по самому изображению понять, что было перед художником: натура, проекция камеры-обскуры или фотографический образец?

Я проверил 20 его работ и сравнил их с современными снимками. Нейросеть назвала все работы гравюрами. После обработки тот же ответ получили 16 из 24 фотографий. Затем я измерил изгибы линий и попробовал восстановить параметры камеры. Рассказываю, что показали эти опыты и почему получить ответ оказалось сложнее, чем казалось.

Что показал эксперимент

Нарезка Twitch-VOD по киллам: читаем игровой текст с кадра через Tesseract и собираем вертикальные клипы на ffmpeg

Уровень сложностиСредний
Время на прочтение12 мин
Охват и читатели5K

Один стример, который играет в PUBG, попросил делать из его записей короткие вертикальные ролики для Shorts, Reels и TikTok. Согласие на то, чтобы рассказать об этом, он дал, но имя я не называю: в статье он просто «стример». Сначала я нарезал клипы по речи и по расшифровке Whisper, и ему они не зашли: он написал, что я резал вообще не игровые моменты. Ему нужны моменты, где он сбил противника с ног или убил. Дальше пришлось учить скрипт находить такие моменты в записи на несколько часов.

Готового сигнала в записи Twitch нет: нет логов игры и нет доступа к данным матча, есть только картинка и звук. Зато сама игра пишет в нижней части экрана «Игрок (ВЫ) УБИВАЕТ игрока (ник), используя оружие» и показывает красный счётчик «1 УБИТО». Я читаю эту надпись как текст и по ней нахожу секунды событий. Ниже описано, как это сделано, где я ошибался и что до сих пор работает не идеально. Код взят из рабочих скриптов, лишнее убрано.

Читать далее

Нейросеть против моментов Ху и алгоритма здравого смысла

Уровень сложностиСредний
Время на прочтение4 мин
Охват и читатели6K

В одной из прошлых статей я переписал простую нейронную сеть с Python’а на Java, что позволило мне начать подробнее изучать нейронные сети, а также ставить эксперименты с ними. Я решил попробовать нестандартный подход и алгоритмически решить задачу распознавания рукописных цифр из набора MNIST. Для этого сравнил образец со средним экземпляром класса, а также сравнил их моменты Ху. Полученные результаты сопоставил с решением на основе нейронной сети, и выбрал победителя. 

Читать далее

ProColpo: машинное обучение в анализе кольпоскопических изображений

Уровень сложностиСредний
Время на прочтение6 мин
Охват и читатели8.2K

ри кольпоскопии врачу необходимо определить расположение изменений и выбрать участки для прицельной биопсии. ProColpo использует машинное обучение для проверки качества снимков и выделения кольпоскопических признаков.

Программа создана на основе ML-модели, разработанной совместно с А. А. Безменко и его командой. В ходе проекта обработано более 15 000 изображений, более 12 000 аннотировано; создана собственная платформа разметки. Сейчас проводятся пилотные интеграции с российскими производителями кольпоскопов.

Как работает ProColpo

Как я искал боровики и дошёл до спутниковой классификации леса

Уровень сложностиСредний
Время на прочтение20 мин
Охват и читатели13K

Хотел просто набрать грибов на выходных, а в итоге натравил машинное обучение на тайгу и сжег 15 часов облачных серверов, уперся в трехметровые заборы непростых объектов и собрали карту боровиковых мест всей Ленобласти. Очередная история о том, как пет-проект зашел слишком далеко.

Читать далее

Ближайшие события

Есть ли свет в конце тоннеля? Проверяем путь по данным лидара

Уровень сложностиСредний
Время на прочтение26 мин
Охват и читатели7.4K

Как понять, что предмет в облаке точек действительно мешает поезду? Разбираю геометрическую часть нашего решения: поиск рельсов, продолжение пути по контактному профилю, восстановление габарита и подтверждение препятствий. На одном эпизоде пройдём весь путь от облака точек до обнаружения квадрата почти в ста метрах. С формулами, промежуточными результатами и отдельным примером с проводом над путём.

Читать далее

Компьютерное зрение всего на одном ядре CPU: 8,6–15,8 мс на кадр и 4,2 МБ в локальной поставке

Время на прочтение6 мин
Охват и читатели10K

Мы подготовили модель TAPe+ML к локальному исполнению внутри процессорного ядра. Модель помещается во внутренней памяти процессора и после первоначальной загрузки работает там. Для работы самой модели не требуется постоянно переносить ее параметры из оперативной памяти в процессор.

Текущая локальная поставка занимает около 4,2 МБ, а на протестированных CPU обработка кадра занимает от 8,6 до 15,8 мс.

У YOLO – в 22-58 раз больше.

Боже мой они опять это сделали

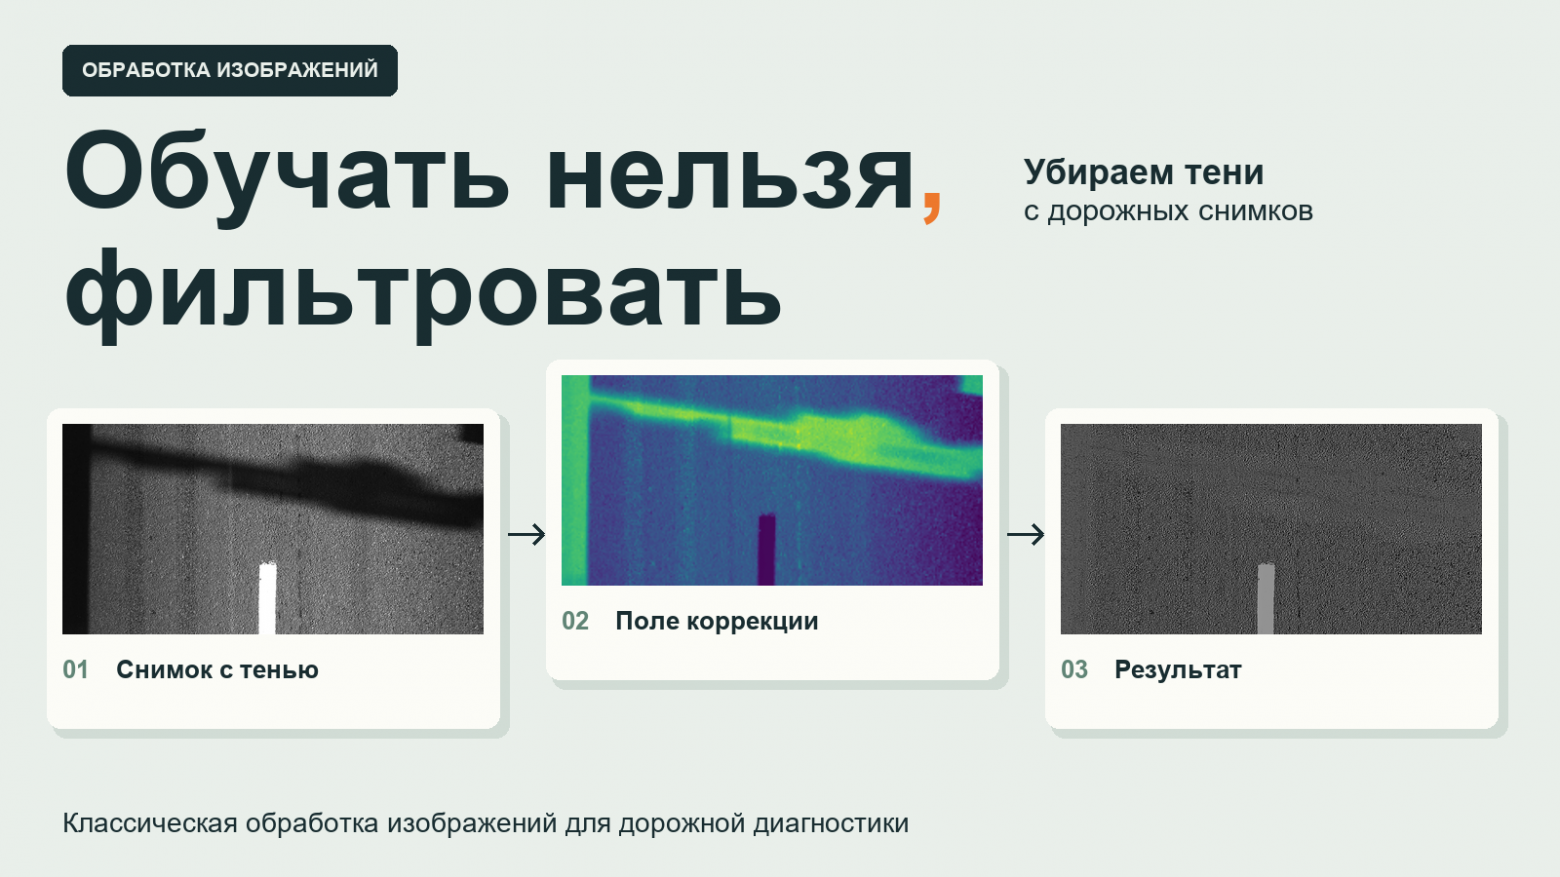
Обучать нельзя фильтровать: убираем тени с дороги без нейросетей

Уровень сложностиСредний
Время на прочтение22 мин
Охват и читатели6.8K

Тень на асфальте скрывает трещины, а её граница сама может выглядеть как дефект. Просто поднять яркость? Вместе с ней вылезет шум. Добавить контраст? Граница тени станет ещё заметнее.

Рассказываю, как подошёл к этой задаче с фильтрами, локальной статистикой и морфологией. Проведём один реальный снимок через шесть преобразований и посмотрим, что каждое из них делает с тенью, фактурой и дорожной разметкой. Внутри формулы, промежуточные изображения и интерактивное сравнение.

Читать далее

Почему нейросеть ломает перспективу: FLUX 2024 года обошёл Nano Banana 2.1 и GPT Image 2.5

Время на прочтение13 мин
Охват и читатели10K

Нейросеть искажает перспективу, потому что её не учили сводить линии в одну точку: исследователи Sony в 2023 году прямо писали, что точность перспективы при обучении диффузионных моделей не требуется. Я проверил, изменилось ли это, на 7 моделях и 3 сценах.

Читать далее

mAP50 = 0,99 за 22 минуты на CPU. Жаль, что цифра ничего не значит

Уровень сложностиСредний
Время на прочтение9 мин
Охват и читатели4.8K

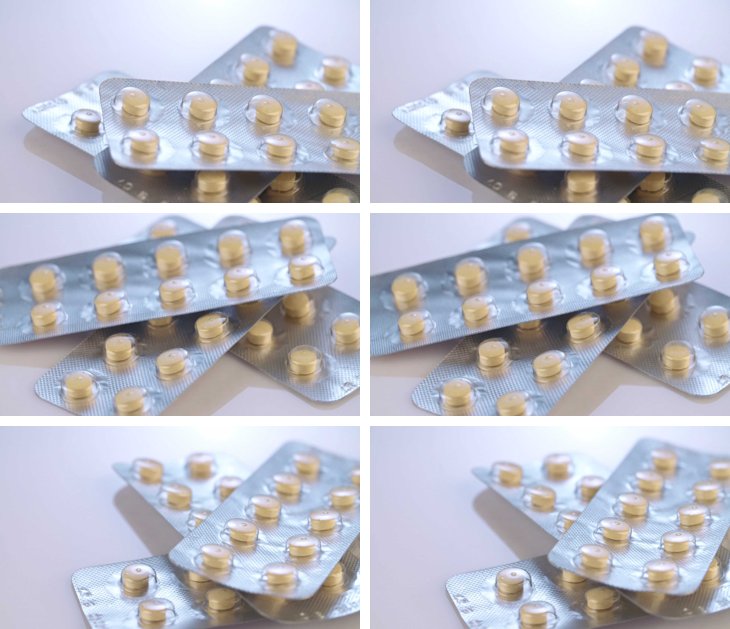
Я дообучил YOLO11n на датасете medical-pills из документации Ultralytics: 60 эпох, 22 минуты на ноутбучном Ryzen 7, mAP50 = 0,991 на валидации. По всем признакам — успех: можно делать скриншот и рассказывать, как легко сегодня учить детекторы.

Потом я прогнал тот же датасет через dataset-doctor — свою проверялку датасетов — и узнал, что у каждого из 23 валидационных кадров есть почти точная копия в train. Валидация измеряла не «как модель справится с новыми таблетками», а «как хорошо модель помнит то, что уже видела».

Под катом: что именно нашлось, почему метрика при этом не врёт в прямом смысле, но и не говорит ничего полезного, как ловить такую утечку за два десятка строк на Python (dHash плюс корзины) и как делить данные, чтобы её не было.

Читать далее

Читаем DataMatrix с конвейера: открытое сравнение четырёх библиотек на 1368 синтетических кадрах

Уровень сложностиСредний
Время на прочтение9 мин
Охват и читатели7.2K

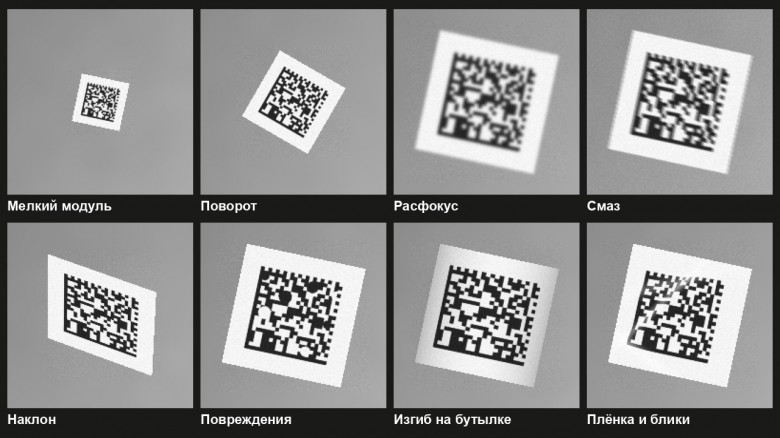
На производстве код «Честного знака» читает камера над лентой, и символ на кадре мелкий — 2–3 пикселя на модуль, повёрнутый, смазанный, на изогнутом боку бутылки. Мы сравнили, как с такими кадрами справляются ZXing, zxing-cpp, libdmtx и наша библиотека dmr. Кадры, ожидаемые строки и скрипты замера выложены — любую цифру можно проверить.

Коротко: — на 1368 синтетических кадрах dmr прочитал 82 %, zxing-cpp — 70 %, libdmtx — 65 %, ZXing (Java) — 3 %; — ложных чтений — ноль у всех четырёх библиотек; — dmr надёжно читает от 1,4 пикселя на модуль и при любом угле поворота; — zxing-cpp примерно в 2,5 раза быстрее; — есть условия, где соперники читают больше dmr, — разбираем их в статье.

Таблицы, графики и данные

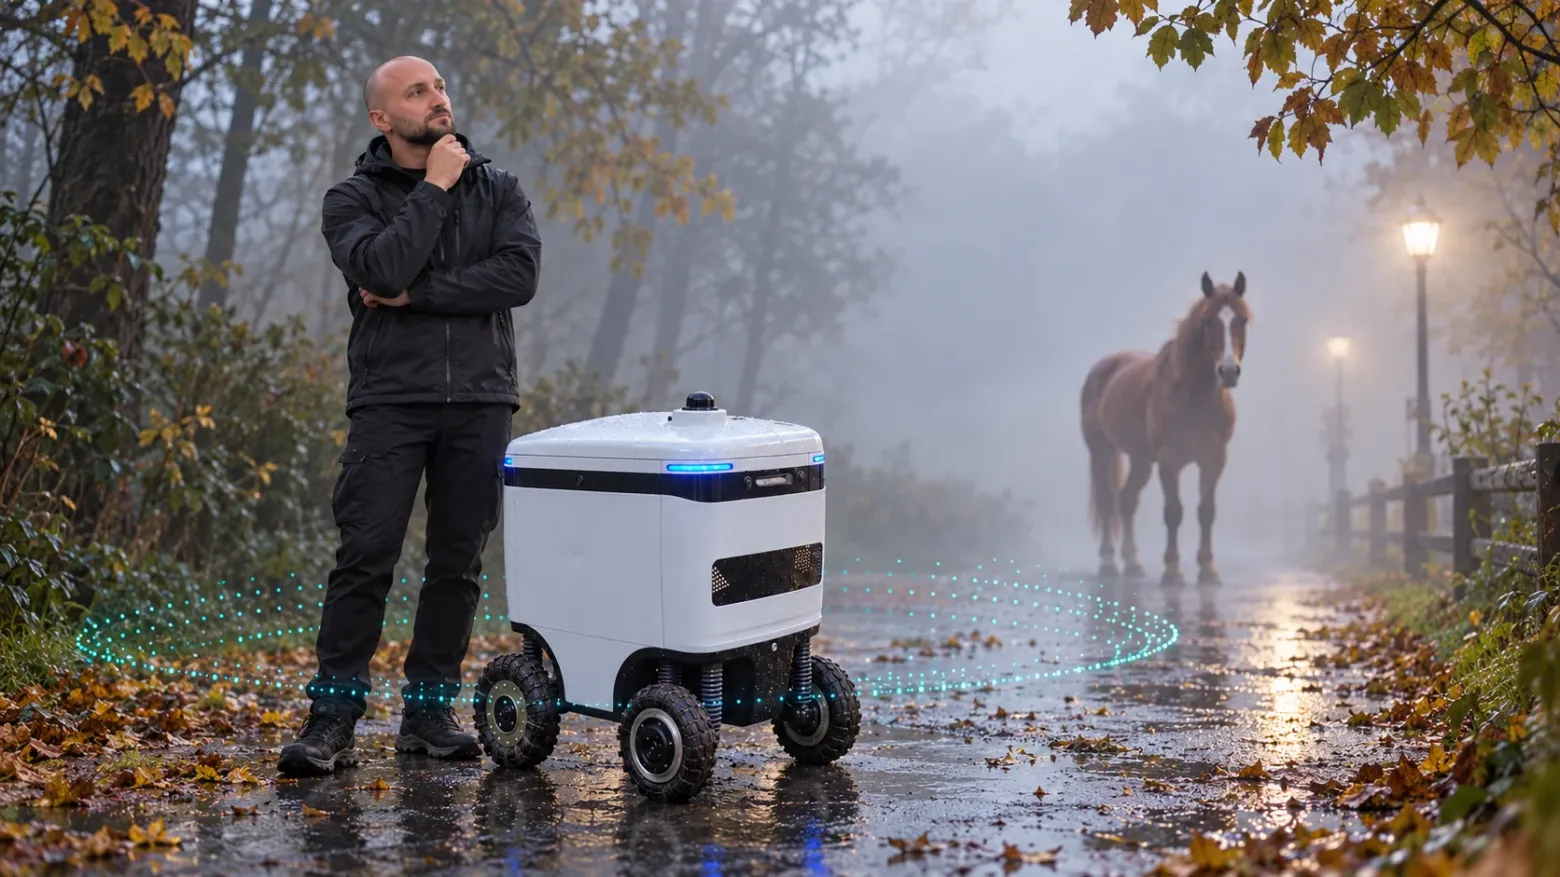
Робот в тумане: лошадь оставить, туман удалить

Уровень сложностиСредний
Время на прочтение6 мин
Охват и читатели11K

Airy Lite создавал кольцо препятствий на пустой дорожке. Проследили точки до сырых измерений и встроили геометрический фильтр в ARM64-классификатор. Разбор алгоритма, C-код, параметры и проверки на записях с тонкими препятствиями.

Читать далее
1
23 ...