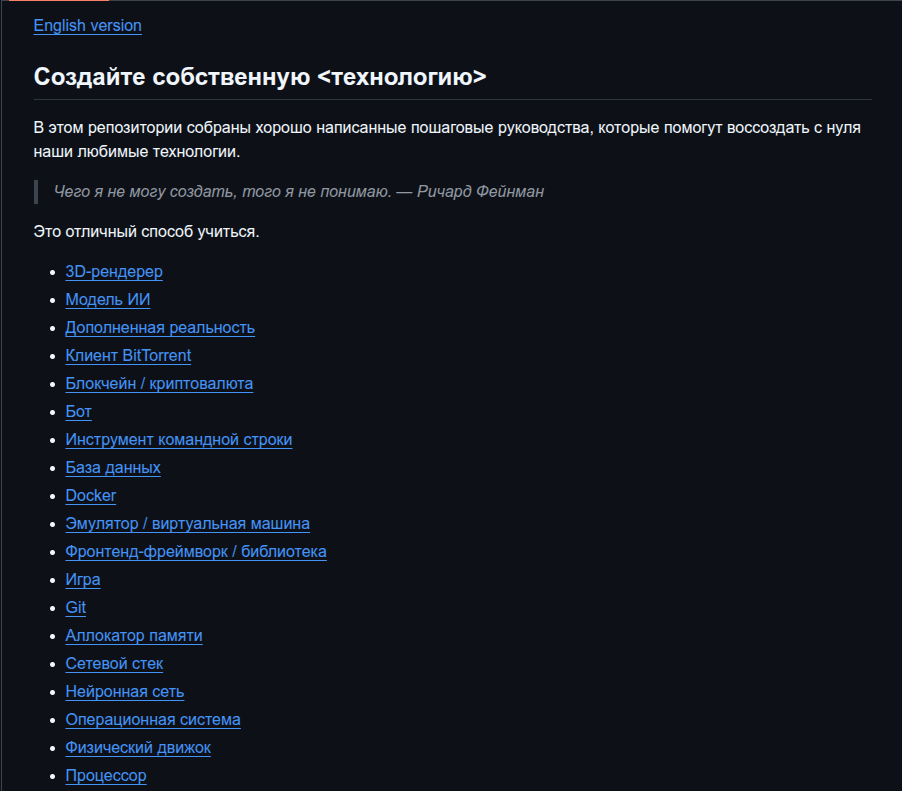
Вайбкодите? Бог вам судья, конечно. Но если переживаете за разжижение серого вещества в черепной коробке, вот отличный инструмент, чтобы повысить, и укрепить свои компетенции.
Один из самых популярных репозиториев на GitHub, в котором собраны хорошо написанные пошаговые инструкции, как самому собрать браузер, базу данных, нейросеть и другие популярные технологии.
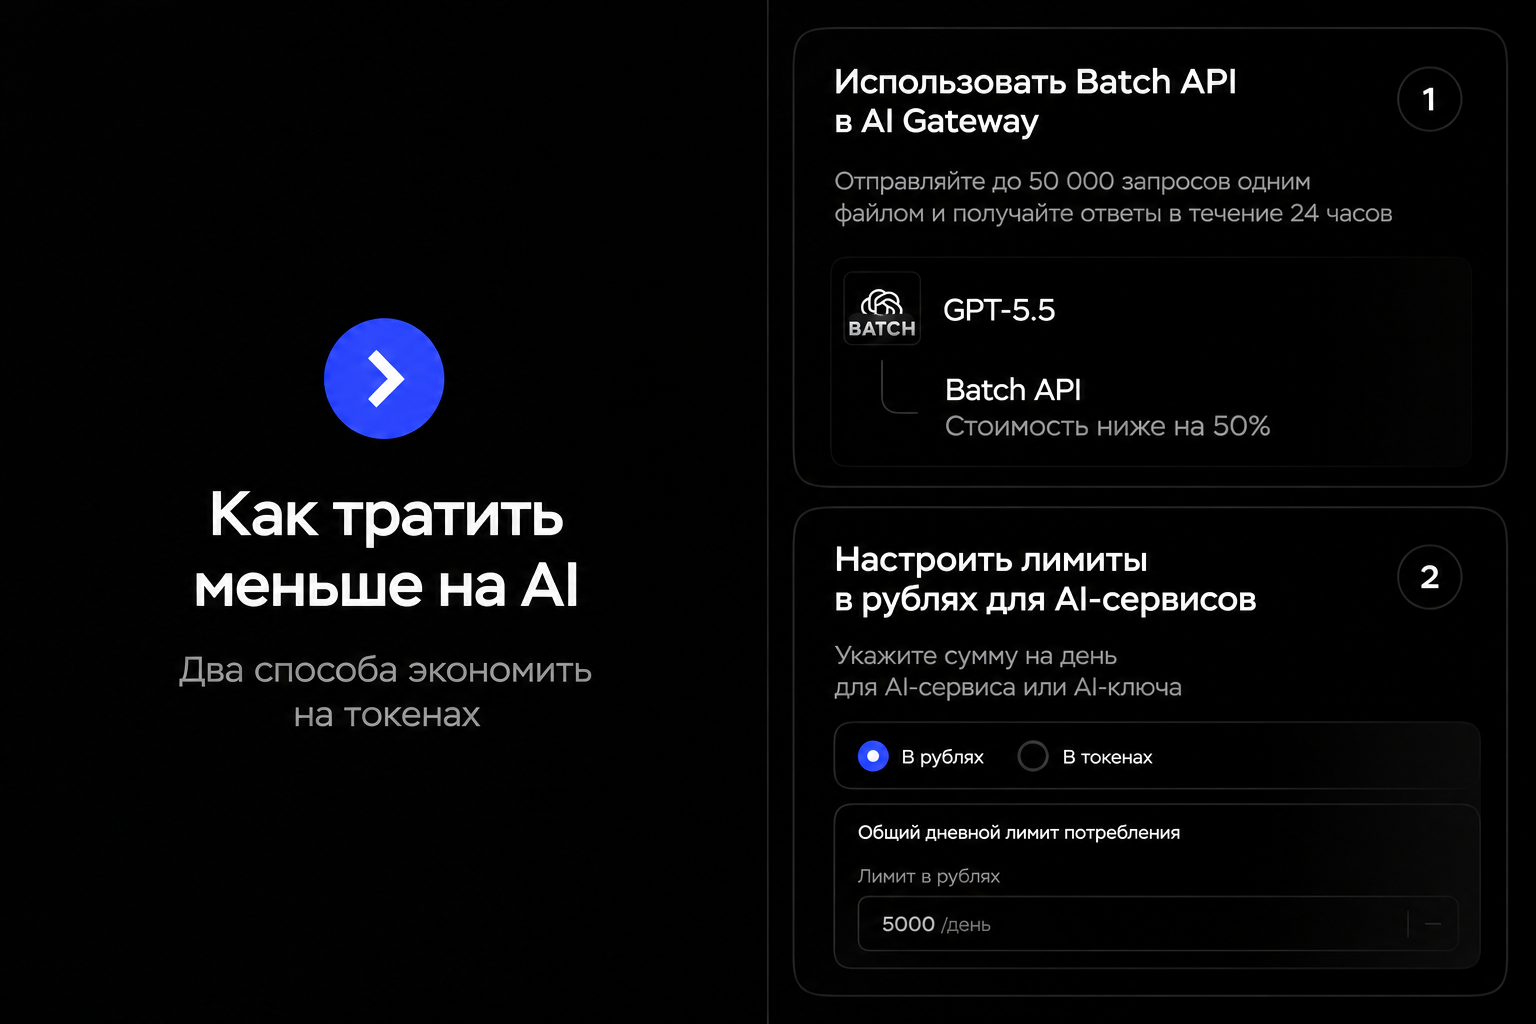
Выкатили два обновления в AI-сервисах, чтобы вы могли платить меньше за запросы и заранее определять бюджет:
1️⃣ Batch API — запросыза полцены
Если ответ не нужен сразу — отправляйте запросы единым пакетом через Batch API в AI Gateway. Входные и исходящие токены обойдутся вдвое дешевле, чем при обычном обращении.
Как использовать: соберите до 50 000 запросов в файл, отправьте через API и получите файл с ответами в течение 24 часов.
Привет, Хабр! На связи команда Рег.облака. В личном кабинете Рег.облака много изменений. Собрали главное в одном посте: что появилось, где найти и как этим пользоваться.
Услуги виртуального дата-центра на базе VMware
В личном кабинете теперь отображаются услуги виртуального дата-центра на базе VMware. Перенесли возможности, которые раньше были доступны в кабинете Рег.ру, и добавили улучшения: можно посмотреть параметры услуги, перейти в vCloud Director и отправить запрос на изменение конфигурации или удаление услуги.
В личном кабинете стал доступен список тенантов. Если у вас их несколько, можно выбрать нужный и открыть карточку услуги. В ней собрали:
данные для доступа к тенанту;
текущую конфигурацию;
выделенные сети.
Так вы быстро поймете, как подключиться к нужному тенанту, что в нем уже настроено и какие сети ему выделены без переключения между разделами.
Запрос на удаление услуги
Если виртуальный дата-центр больше не нужен, запросить его удаление теперь можно в личном кабинете. По нажатию на кнопку открывается боковая панель — в ней мы просим указать причину отказа от услуги.
Ресурсы не удаляются мгновенно: сначала мы получаем запрос и обрабатываем его.
Отключение выделенных серверов и дополнительных услуг
Аналогичную возможность добавили для выделенных серверов и всех дополнительных услуг к ним. Кнопка отказа от услуги открывает боковую панель, где можно указать причину и отправить запрос на отключение.
Все обновления уже доступны в личном кабинете Рег.облака. Продолжим делать управление услугами удобнее — следите за обновлениями и делитесь в комментариях, каких возможностей вам не хватает.
Завтра будет облачно, не забудьте заглянуть на GoCloud Tech 2026 ☁️
Синоптики предрекают облачность 15 октября. Не уверены, что это совпадение — все-таки наша конференция.
Завтра в Loft #8 на Волочаевской соберутся те, кто двигает технологии в эпоху искусственного интеллекта. Три трека, два десятка докладов, шесть воркшопов и море профессионального переопыления. Регистрация на очное посещение события закроется сегодня в 12:00 мск. Если не успели, можно будет принять участие в онлайн-формате, главное не забудьте зарегистрироваться до 9:00 мск четверга. 👉 Регистрация
Что взять на площадку: ноутбук для воркшопов, зонт на случай осадков в виде технологий, пауэрбанк, чтобы не упустить ничего важного, и список каверзных вопросов для спикеров.
Что будет: доклады про инфраструктуру, разработку и данные. Технозоны, где можно поговорить с инженерами продуктов напрямую. Лаборатория решений с доступом к сервисам, которые еще не вышли.
Afterparty: после официальной части вы сможете пообщаться с разработчиками сервисов и коллегами из других компаний в неформальной атмосфере. Отличный шанс задать вопросы, на которые не решились публично, и просто отдохнуть после целого дня инсайтов.
📅 15 октября, 10:00–18:00 мск.
📍 Loft #8, ул. Волочаевская, 48, стр. 1 (м. Площадь Ильича).
Коллеги, партнеры, друзья! Ситуация в ИТ отрасли драматическая. Многие столкнулись с проблемами. Мы рядом и готовы вам помочь.
Оперативно развернем вашу инфраструктуру.У нас все работает штатно. Разместите у нас ваши приложения, критичные сервисы или бэкап всей инфраструктуры. Мы можем быть как основной площадкой, так и резервным плечом.
Готовы принять вас в следующих локациях:
Москва, Санкт-Петербург, Екатеринбург Ташкент, Алматы
До GoCloud Tech 2026 осталась неделя: успейте зарегистрироваться
15 октября в Москве и онлайн пройдет ежегодная конференция GoCloud Tech 2026. Если вы еще не выбрали доклады и не прошли регистрацию — сейчас самое время.
Что вас ждет:
🎤 3 трека. Инфраструктура, Разработка, Данные и ML. 👨💻 Воркшопы. Практические сессии с ноутбуками — от Spark Connect до Guardrails Filter. 🧪 Лаборатория решений. Уютный сеттинг компьютерного клуба, где можно эксклюзивно протестировать сервисы, которые еще не вышли, и поделиться впечатлениями. ⚙️ Технозоны. Пространство для живого общения с командами коллег по цеху и каверзных вопросов напрямую инженерам, создающими сервисы. 💡 Доска инженерных решений. Место, куда приходят с проблемой, а уходят с карточкой готового решения. 🚀 Лаборатория карьеры. Пункт бесплатной прокачки резюме, знакомства с культурой и ценностями Cloud.ru и ИТ-профессиями будущего.
По вашим запросам добавили 47 конфигураций выделенных серверов с видеокартой. Теперь в Москве и Санкт-Петербурге — от RTX A2000 и RTX 4090 до RTX PRO 6000, H100 и H200, включая сборки с несколькими GPU.
Подходят под AI и ML-задачи, рендеринг и другие проекты, которым нужны вычисления на GPU.
А если готовой конфигурации мало — запустили конфигуратор выделенных серверов. Выбираете нужные компоненты, а мы готовим сервер, все просто.
Почему стандартные CNI не справляются с балансировкой на масштабе? Расскажем на GoCloud Tech 2026
Доставка трафика в балансировщик и оттуда в пользовательский бэкенд — задача, которая на масштабе часто разбивается о стандартные CNI. Решение обрастает слоями NAT, пулы IP-адресов тают, а сложность отладки растет в геометрической прогрессии.
На докладе разберем архитектуру балансировщиков нагрузки и покажем, почему мы разработали собственный CNI. Заглянем под капот Linux-серверов, разберем изоляцию через VRF и netns, покажем, как сервис интегрирован в BGP EVPN VXLAN-фабрику. На реальных примерах продемонстрируем, как избежать стандартных проблем и сохранить управляемость инфраструктуры при росте нагрузки.
Спикер: Дмитрий Радчук — менеджер продукта, Cloud.ru.
1 октября Google запустила ракетой SpaceX Falcon 9 на орбиту сервер с четырьмя TPU — практически это космический GPU-сервер. На фоне планов самой SpaceX отправить на орбиту целую стойку Nvidia NVL 72 планы кажутся скромными — в чём же важность этого запуска?
Как отмечают эксперты, отправка GPU на орбиту — уже не новость: более половины запускаемых ДЗЗ-спутников имеют вычислительные возможности уровня Nvidia Jetson Orin. SpaceX планирует ещё выше поднять уровень вычислительных мощностей на орбите. На этом фоне показательно, что ИТ-гигант Google проводит скромный эксперимент — её космический аппарат был одним из 130 в запуске.
Google начнёт с азов — в первую очередь проверит функционирование серийных TPU в условиях космической радиации, протестирует систему рассеивания энергии с помощью радиаторов, а также проверит возможности инженеров по созданию инфраструктуры для сложных решений космоса.
Компания иллюстрирует трудности работы в космосе так: стандартные радиаторы рассеивают 300 Вт с каждого квадратного метра, а для TPU нужно отдавать 100 000 Вт — в 300 раз больше! Поэтому даже использование серийных решений требует нестандартной обвязки.
В случае успешного тестирования Google планирует в 2027 году вывести на орбиту пару космических аппаратов и протестировать на них межспутниковую лазерную связь.
Безусловно, SpaceX лидирует по количеству аппаратов на орбите. Китайские спутники содержат вычислительные мощности, которые, пожалуй, превышают доступные на МКС. Но Google показывает пример — кто не хочет зависеть от конкурентов, должен развивать свои решения. Так как в космической сфере почти нет готовых решений, то многое приходится исследовать самим с нуля.
Это совпадает с подходом RUVDS. Часть бюджета на исследования и разработки мы тратим на запуск спутников-серверов серии RUVDSSat для испытания ЦОД в экстремальных условиях. Даём доступ к нашим решениям всем инженерам-энтузиастам. Верим в то, что опыт в космических дата-центрах позволит построить свою инфраструктуру, не зависящую от геополитических изменений.
Чуваки, я не знаю как вы, но я задолбался от этого бессмысленного бега в колесе.
Снова и снова одна и та же проблема: инфраструктура, сборка и доставка приложений везде устроены по-разному. Каждая команда городит свой набор скриптов, пайплайнов и правил. Знания остаются в головах, процессы не масштабируются, а разработчики тратят время не на продукт, а на очередное изобретение собственного DevOps.
Поэтому я пилю MyTinyIDP — Internal Developer Platform на основе CNCF-подхода, Kubernetes и GitOps.
Идея простая: через единый портал разработчик — и его старший брат его менеджер продукта — создаёт проект или сервис, а платформа сама подготавливает репозиторий, окружение, доступы, инфраструктуру и доставку приложения.
Сервис собирается без ручного написания Dockerfile: Cloud Native Buildpacks определяют стек, собирают OCI-образ и публикуют его в registry, после чего Argo CD доставляет приложение в Kubernetes.
Под капотом — Backstage, Argo CD, Argo Workflows, Argo Events, Crossplane. Открытые компоненты, декларативная модель и минимум привязки к конкретному облаку.
Рабочий прототип уже есть.
Ну, «рабочий» — ну так :) Пока вопросов там больше, чем ответов. Но оно уже живёт, что-то создаёт, что-то деплоит...
Так что если в этом чатике есть люди, которым близки Platform Engineering, CNCF, GitOps и нормальный Developer Experience, и которые тоже считают, что пора перестать в каждой компании заново изобретать собственный DevOps — давайте пилить вместе.
Что будет с монетизацией — пока не знаю.
Зато свой golden path устроим. То есть вдруг есть энтузиасты, пишите, расшарю репо и тд. :)
З.Ы. Может показаться что это чатик написал, но нет. У меня реальная попаболь от всего происходящего и я хочу поменять правила игры.
После ухода SAP и Oracle компании надеялись, что западные вендоры вернутся. По наблюдению Алексея Телкова, генерального директора «Галактики», сегодня ждать перестали точно все и некоторые перешли на модель «сами напишем». На вайб-коде и за год. Касается это любого корпоративного ПО, которое не хочется менять на продукт российского вендора.
Звучит почти бесплатно. Потом в смету приходят видеокарты последнего поколения, подписки на модели, свои серверы и команда из 50 с лишним человек. Которая, как предполагается, тоже ничего не стоит.
Сам Алексей против ИИ ничего не имеет, в «Галактике» уже год пишут код с его помощью. Но ИИ есть и у вендоров, а экономика корпоративного софта от него не меняется. Ценность кода появляется, когда его переиспользуют. Готовая система, которую внедрили в десяти компаниях, в пересчете на одного заказчика обходится дешевле собственной разработки, даже с учетом прибыли вендора.
Как правильно считать TCO своей разработки и что будет с рынком интеграторов, в пятом выпуске подкаста «IT-фронтир».
Свежее обещание от Илона Маска — спутники связи будут поддерживать скорости в 10 Тбит с увеличением до 100+ Тбит, вычислительная система будет основана на Nvidia Vera Rubin NVL72 с энергопотреблением 250 кВт. Какие спутники связи делает Илон Маск, мы знаем — Starlink, а теперь складывается пазл: они будут, собственно, первыми прототипами космических дата-центров, которые мы прогнозировали как центральную тему 2026 года. Насколько эти планы реальны?
Пост Маска в очередной раз поднимает вопрос о реальности космических дата-центров. Сейчас типичные скорости связи — до 100 Гбит по лазерному межспутниковому каналу, масса спутников — порядка полутонны. Мощность быстро найти не удалось, но примерно это 25 кВт (что тоже немало: у Международной космической станции, на которой работают 7 человек, — около 100 кВт).
Следующее поколение спутников Starlink v3 уже было протестировано в суборбитальном полёте SpaceX. Серийно их планируется запускать на ракете Starship, которую уже 5-й год Илон Маск пытается довести до выпуска в прод. Если ему это удастся, то она будет запускать спутники v3 массой около 2—2,5 тонны и вырабатывающие уже около 50 кВт. В этом поколении планируется достичь терабитных скоростей.
По отдельности все эти характеристики звучат фантастично, но пока в области спутникостроения SpaceX показывает последовательное увеличение размеров своих космических аппаратов, что позволяет им увеличивать энергетические характеристики и в итоге — скорость связи.
Полагаем, что в сентябрьском твите Илон Маск говорил не о v3, а, как всегда, строил планы на будущее. Но если компании удастся массово запускать на орбиту Starlink v3, то планы не кажутся такими уж несбыточными. В ноде Nvidia Vera Rubin NVL72 — 18 серверов общей массой примерно 2 тонны, объёмом примерно 2 куба. По сравнению с v3 не кажется уже проблемой вывода. Главный вопрос — как нарастить доступную для потребления компонентам КА энергию ещё на порядок.
Тема космических дата-центров завязана на мощные ракеты (для ввода многотонных спутников), их энергетические характеристики и охлаждение. Эти вопросы по-прежнему сложны, но уже не кажутся нерешаемыми. По крайней мере, облачным провайдерам стоит проработать вопрос, не окажутся ли выгодными космические дата-центры, чтобы не получилось, как с возвращаемыми ступенями ракет. Пока весь мир говорил «невыгодно» — Илон Маск сделал.
Когда точечные интеграции перестают работать: как выбрать ESB и собрать команду
Интеграции редко проектируют сразу как отдельный слой. Обычно сначала появляется несколько обменов между системами, потом еще несколько — и постепенно всё превращается в сложный контур, который трудно развивать и поддерживать.
29 сентября вместе с EvApps проведем вебинар о двух связанных задачах:
когда компании уже нужна ESB, а когда точечных интеграций достаточно;
как собрать команду, которая сможет внедрить и дальше сопровождать интеграционный слой.
Разберем:
место ESB в корпоративной архитектуре и связь с MDM и КХД;
российский рынок интеграционных платформ;
подрядчика, аутстафф, внутреннюю и смешанную команду;
типовые точки, где проект начинает буксовать по ресурсам;
что делать с поддержкой после запуска.
Спикеры — Сергей Скирдин, технический директор «Белого Кода», и Альфред Столяров, директор EvApps.
Участники получат обзор российских шин, опросный лист для выбора ESB и чек-лист проверки подрядчика.
Подоспела новость: MONT и Avanpost договорились о партнёрстве.
На первый взгляд - обычная дистрибьюторская новость. Но для компаний, которые работают с MONT и рассматривают миграцию с Microsoft AD на Linux-каталог, появляется интересный вариант службы каталога — Avanpost DS. Сейчас многие возразят: на рынке же полно российских решений-аналогов MS Active Directory — ALD Pro, РЕД АДМ, Роса Dynamic Directory, Альт Домен и другие. Зачем нам ещё один? Копнём поглубже, чтобы понять, а действительно нужен ли нам этот "ещё один".
Российские Linux-каталоги собраны по-разному: одни вокруг FreeIPA, другие на Samba DC. Вместе с каталогом заказчик выбирает его архитектуру, зависимости и инструменты администрирования. Поэтому два продукта с одной задачей в эксплуатации ведут себя по-разному.
Avanpost пошёл другим путём
Ядро Avanpost DS — LDAP-сервер и Kerberos — написано на Go с нуля, без использования open-source-компонентов. По заявлению вендора, их служба каталога протестирована под нагрузкой до 30 млн объектов.
Что это даёт?
Типичный Linux-каталог собран из нескольких компонентов. Каждый зрелый и проверенный, но со своей архитектурой и зависимостями. Вендору приходится развивать свой продукт и одновременно считаться с чужим кодом.
Своя собственная разработка даёт больше контроля над ключевыми компонентами. Их можно менять, искать узкие места и оптимизировать под нагрузку, а не подстраиваться под архитектурные решения, которые принимали без тебя. Avanpost среди плюсов своего подхода называет производительность и масштабируемость.
Но производительность важна не только в штатном режиме
Проблема начинается, когда нужно быстро исправить ошибку в каталоге. Неудачный скрипт, сбой интеграции или массовое изменение могут затронуть множество объектов. Контроллеры при этом доступны, пользователи аутентифицируются, мониторинг зелёный – но у части сотрудников уже изменены атрибуты, членство в группах или права доступа. Формально всё работает, а данные внутри — уже нет.
Мало обслуживать миллионы объектов в штатном режиме. Нужно ещё быстро понять, что именно сломалось, и исправить это, не откатывая миллионы корректных данных вместе с ошибочными.
При больших объёмах узким местом может стать уже сам каталог. В компании, где я работаю (другой ИТ-вендор), был похожий опыт при нагрузочном тестировании одного из Linux-каталогов, построенных на open-source-компонентах: массовые операции на сотнях тысяч объектов выполнялись критически медленно, а удаление нескольких тысяч учётных записей заняло несколько дней. Во время нагрузки возникали ошибки, а репликация между контроллерами некоторое время не восстанавливалась.
Поэтому производительность каталога при больших объёмах – это не вопрос комфорта администратора. От неё напрямую зависит, сколько времени займёт исправление массовой ошибки.
И здесь у Avanpost есть ещё одна полезная связка
С августа Avanpost DS Pro совместим с Granulex Recovery. Granulex сравнивает текущее состояние каталога с резервной копией, показывает, что изменилось не туда, и позволяет выборочно вернуть нужные объекты и атрибуты — без полного отката каталога.
Так что при выборе замены Microsoft AD важен не только список функций. Сколько объектов реально выдерживает каталог? Как ведёт себя под нагрузкой? И насколько быстро можно найти и исправить ошибку, если она затронула тысячу объектов из миллиона?
Когда от каталога зависят доступы всей компании, это уже не мелочи.
Как управлять разработкой, если процессы и данные распределены по разным системам?
Руководителям становится сложнее видеть общую картину: оценивать стоимость инициатив, контролировать соблюдение единых требований и понимать, где процессы теряют эффективность. Разработчики при этом зависят от DevOps-инженеров в типовых задачах и ждут предоставления окружений и ресурсов.
2 октября в 12:00 на вебинаре представим новый этап развития Deckhouse Development Portal.
Покажем, как Development Portal встраивается в разнородный ИТ-ландшафт и объединяет управление разработкой. Руководители получают больше прозрачности и инструментов контроля, а команды — портал самообслуживания для работы с инфраструктурными сервисами, инструментами и данными.
Разберём:
расчёт стоимости инфраструктуры разработки отдельных бизнес-инициатив;
стандартизацию процессов и требований безопасности;
упаковку согласованного стека в готовые шаблоны;
заказ окружений и баз данных по кнопке без ручной обработки заявок;
адаптацию портала к процессам компании и интеграцию с используемыми системами.
Бонус: для участников вебинара проведём чекап процесса SDLC вашей команды.
Почему мониторинг, SRE и автотесты перестали работать по отдельности?
Digital Immune System (DIS) или Цифровой Иммунитет — это способность инфраструктуры почувствовать, что с ней что-то не так, и починить себя раньше, чем это заметит пользователь.
В новом выпуске «В SREду на кухне» Андрей Волхонский, Андрей Колесников и Василий Осипенко разбирается что такое DIS, из чего он состоит и почему это не просто модное словосочетание, а способ пересобрать подход к надёжности.
Гость выпуска: Михаил Савин, руководитель отдела SRE в H3LLO CLOUD
Как снизить стоимость хранения данных с помощью комбинаторики и линейной алгебры? Узнаете на GoCloud Tech 2026
При проектировании систем хранения приходится искать баланс между тремя параметрами: производительностью, надежностью и стоимостью инфраструктуры. На практике улучшение одного показателя нередко требует пожертвовать другим. Разберемся, из чего складывается стоимость хранения данных и как снизить ее с помощью продвинутых алгоритмов отказоустойчивого кодирования. Поговорим о математике нового кодировщика, принципах его работы и сложностях production-ready реализации. А еще покажем на графиках, как решение влияет на скорость работы и потребление ресурсов. Доклад поможет архитекторам, инженерам и системным администраторам подобрать оптимальный баланс между производительностью, надежностью системы и затратами на инфраструктуру.
Спикер: Сергей Баширов — ведущий разработчик R&D, Cloud.ru.
Добавили редактор политик для пользователей S3. Теперь в панели можно как выдать готовую роль, так и настроить собственную политику — редактируете ее в интерфейсе или загружаете готовый JSON.
Когда пригодится:
1️⃣ Открыть разработчику только чтение логов — без возможности изменить или удалить данные.
2️⃣ Выдать клиенту доступ к нужной папке в бакете — остальные объекты останутся недоступны.
3️⃣ Разрешить скрипту бэкапов запись без права удаления — старые копии останутся целы.
Права можно задать как для новых пользователей при создании, так и для уже существующих в S3 → «Пользователи». Еще политика доступна в настройках конкретного бакета.
В ряде образцов злоумышленники использовали артефакт, созвучный с Чубаккой
В конце июня команда нашего экспертного центра безопасности (PT ESC) в ходе расследования инцидентов обнаружила новую группу, нацеленную как минимум на нефтегазовые компании и финансовый сектор.
В ходе атак злоумышленники преследуют деструктивные цели, при этом достаточно долго сохраняют присутствие в скомпрометированной инфраструктуре.
При перемещении в инфраструктуре используются преимущественно WinRM (как правило, в сочетании с WinRb) и SSH.
Для закрепления в инфраструктуре используются в основном серверные машины с большим аптаймом (Windows\Linux), закрепление осуществляется посредством сервисов в обоих случаях. В качестве полезных нагрузок используется широкий набор инструментов:
Бэкдор GoRinet. Использует шифрование конфига с ключом, формируемым на базе физического адреса сетевого адаптера.
Для совершения деструктивных действий используется разнообразное ПО, в том числе по ряду признаков разработанное с использованием ИИ.
Вайпер T-Riper для сетевых устройств производства Cisco/Huawei — удаление образов, сброс конфигурации устройства, ребут. Используются в сочетании с bash-скриптами для запуска по удаленным целям.
Кастомный вайпер для удаленного удаления данных QNAP.
Для шифрования данных на машинах под управлением ОС Windows используется комплекс ВПО, состоящий из оркестратора (с возможностью отправки отчета о прогрессе шифрования на удаленный C2). Порождение вайперов осуществляется многопоточно, причем отдельные исполняемые файлы создаются с добавлением «мусора» в оверлей для уклонения от обнаружения. Для автоматизированного распространения по сети используются файлы конфигов с указанием известных кредов ранее скомпрометированных УЗ и целевых подсетей.
Также отмечено использование уязвимости CVE-2026-31431 (CopyFail) для повышения привилегий, кастомного инструмента CredsReseter для сброса паролей УЗ Linux-подобных систем и Windows-скриптов для дампа кредов сторонних сервисов.
Рекомендации:
Осуществить поиск и мониторинг индикаторов компрометации.