Обновить
256K+

Python *

Высокоуровневый язык программирования

379,1
Рейтинг
Сначала показывать
Порог рейтинга
Уровень сложности
Формат публикации

Три месяца я задавал нейросетям одни и те же 61 вопрос: доля ответов со ссылкой на мои статьи выросла с 3 до 51%
Уровень сложностиСредний
Время на прочтение9 мин
Охват и читатели3.1K

С середины лета я раз в несколько недель задаю нейросетям с веб-поиском одни и те же вопросы про франшизы и производство одежды и записываю, на какие страницы они ссылаются. Вопросы такие, какие задаёт человек перед покупкой: «за сколько окупается франшиза производства мерча», «как проверить франшизу, чтобы не нарваться на развод», «какой DTF-принтер выбрать для старта». Параллельно все эти месяцы я писал статьи о нашем производстве на открытые площадки, где публикуются сторонние авторы, и вёл блог компании.

На постоянной выборке из 61 вопроса, в которых наша компания не названа, доля ответов, где процитирована хотя бы одна наша страница, выросла за три месяца с 3 до 51 %. Сейчас это называют GEO-оптимизацией, то есть работой на то, чтобы попадать в ответы генеративного поиска, и я хотел проверить, работает ли она вообще, на своих данных. Ниже код замера, таблицы из прогона 13 ноября 2026 года и четыре места, где замер врёт или врал раньше. Без них эти 51 % ничего не стоят.

Читать далее

Делаю аналог codespell для русского языка

Время на прочтение1 мин
Охват и читатели4.4K

Всем привет! Я начал делать аналог codespell, только для русского языка!

Если кратко: codespell помогает находить опечатки в коде и файлах разных форматов, а мне такая потребность пригодилась при чтении и переводе оригинальной документации Python на русский. Проект называется sanya.

Идея простая: загружаем словарь возможных опечаток, проходимся по словам в проверяемых файлах и смотрим, есть ли слово в этом словаре. Пока что поддерживаются не все форматы файлов (только .po файлы) но главная проблема не в этом.

Сейчас в словарике около 4 тысяч слов, но для русского языка это мелочи. Например, у codespell в словаре около 65 тысяч слов. Поэтому проекту нужны активные контрибьюторы.

Словарь лежит здесь

Если хотите дополнить словарик, отправляйте пулл‑реквесты: достаточно предложить слово, в котором может быть допущена ошибка. Это отличная возможность поучаствовать в проекте с открытым исходным кодом, даже если вы не программист, то можно просто предложить слово, в котором часто допускают ошибку:‑)

Кстати, не забудьте поставить звёздочку на GitHub

Читать далее

[46.2026] Обзор новых правил безопасности в пакетных индексах и менеджерах

Уровень сложностиСредний
Время на прочтение3 мин
Охват и читатели5K

Пакетный менеджер Hex открыл публикацию из GitHub Actions без постоянных ключей и добавил ручное одобрение релизов. PyPI начал показывать предупреждения об изменениях происхождения файлов. Pixi разрешил точечные исключения из периода ожидания новых пакетов для проверенных обновлений.

Читать далее

Сметчик завода считал КП целый рабочий день. Мы свели это к 30 секундам: почему ChatGPT тут бесполезен

Уровень сложностиПростой
Время на прочтение9 мин
Охват и читатели5.7K

Снабженец строительного объекта отправляет ведомость металлопроката одновременно в 4-5 заводов и заказывает у того, кто первым прислал точный расчет. На производстве инженер-сметчик тратит от 4 до 8 часов на ручной перенос номенклатуры и сверку коэффициентов по бумажным справочникам ГОСТ.

Популярная идея «скормить скан ведомости в ChatGPT» на реальном заказе ведет к прямому кассовому разрыву: при расчете партии швеллера 16П модель ошиблась в массе на 41% в минус, что дает 126 720 рублей чистого убытка на одной строке.

В статье разбираем трехслойную архитектуру решения: как подружить нечеткий семантический парсинг сканов (OpenCV + Vision API) с детерминированным расчетным ядром на Python

Читать далее

Значимый A/B‑тест завышает рост. Считаем, во сколько раз

Уровень сложностиСредний
Время на прочтение11 мин
Охват и читатели5K

A/B‑тест показал +6% к конверсии при p‑value 0,03, и команда закладывает результат в бизнес‑прогноз. Но при низкой мощности эксперимента случайный шум может существенно завышать оценку эффекта. В статье разбираем, как работает проклятие победителя, насколько сильно оно искажает результаты и какие методы помогают получить более реалистичную оценку.

Разбираем A/B-тесты

Когда ИИ-агенту нужен MCP, а когда достаточно обычного API

Время на прочтение2 мин
Охват и читатели5.9K

Допустим, вы разрабатываете ИИ-агента, который проверяет статусы заказов. Для этого ему нужно обратиться к учетной системе, найти заказ по номеру и вернуть пользователю результат.

Можно подключить агента напрямую через API. А можно создать MCP-сервер, который предоставит ту же операцию в виде инструмента. Какой вариант выбрать?

Читать далее

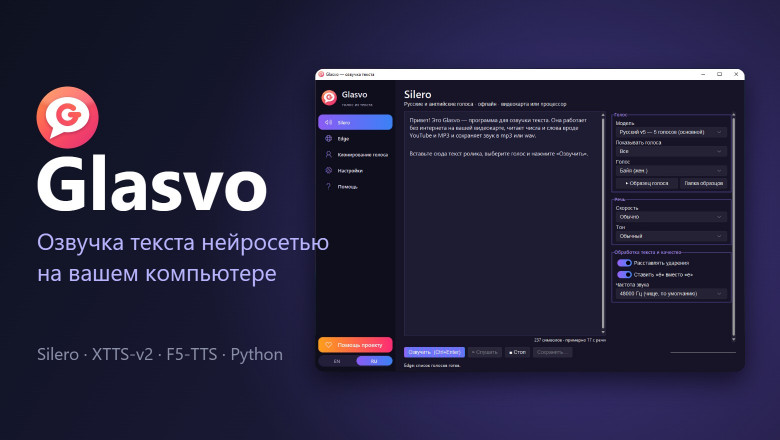
Локальная озвучка на Python: Silero, XTTS‑v2 и F5-TTS в одном окне, и всё, на чём я споткнулся

Время на прочтение6 мин
Охват и читатели4.7K

Мне регулярно нужно озвучивать русский текст, а онлайн-сервисы с бесплатным лимитом знаков и подпиской после него надоели. Нейросетевой синтез речи давно спокойно крутится на домашней видеокарте, поэтому я собрал вокруг него оболочку: окно на tkinter, в котором есть три движка, Silero, голоса Microsoft Edge и клонирование голоса (XTTS-v2 и F5-TTS). Назвал Glasvo. Код открыт, MIT: https://github.com/OlegChe77/glasvo .

Читать далее

Как мы собираем рекламные шортсы прямо из движка игры: Godot, Python и ffmpeg

Уровень сложностиСредний
Время на прочтение4 мин
Охват и читатели6.5K

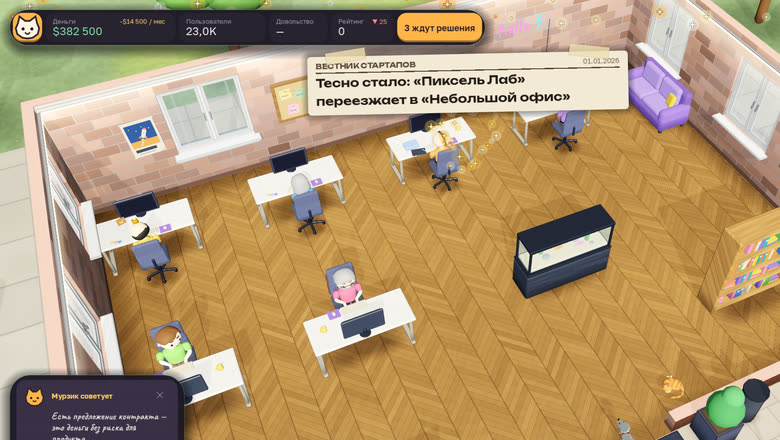
Мы небольшая студия, делаем экономическую стратегию про IT-компанию на Godot 4. Для соцсетей нужно много коротких вертикальных роликов, а монтировать каждый руками долго и скучно. В итоге собрали конвейер: игра сама разыгрывает сцену и пишет видео, а скрипт на Python монтирует из этого шортс с подписями, голосом, музыкой и обложкой. Один ролик собирается примерно за минуту, сейчас их 64. Расскажу, как это устроено и на какие грабли наступили.

Читать далее

Почему AI‑агент забывает правила проекта между сессиями и как это исправить с помощью AGENTS.md

Уровень сложностиСредний
Время на прочтение12 мин
Охват и читатели5.8K

Вы объяснили Codex архитектурные правила проекта, но в следующей сессии он снова кладёт SQL в сервисный слой и нарушает договорённости. Чтобы этого избежать, нужно правильно организовать инструкции в AGENTS.md и skills, а затем проверить, что агент действительно их соблюдает. На примере 18 сессий Codex разберём, какие правила стоит фиксировать и как автоматизировать их проверку.

Изучить гайд

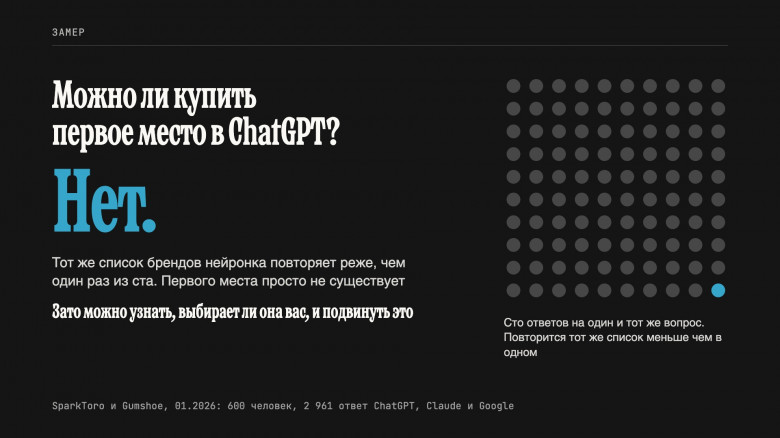
Как я каждый месяц проверяю, называет ли меня ChatGPT, и что из советов по GEO на деле не работает

Уровень сложностиСредний
Время на прочтение8 мин
Охват и читатели4.7K

С августа у меня работает скрипт, который задает нейронке вопросы так, как их задал бы мой клиент, и считает, называет ли она меня. Сейчас он делает это раз в месяц. Рассказываю, как это устроено, что показали замеры и почему популярные советы вроде llms.txt почти ничего не дают.

5 ноября я читал лекцию «Бренд, который выбирает нейронка» на площадке МосХаб.Сколково, в цикле экспертных вебинаров РАСО и НИУ ВШЭ для студентов рекламы и PR. Там была маркетинговая часть. Здесь техническая: как устроен замер и что пришлось в нем переделать по дороге.

Читать далее

Спекулятивный декодинг в проде: сравнение методов в ИИ-ассистенте покупателя на Wildberries

Уровень сложностиСложный
Время на прочтение21 мин
Охват и читатели5.3K

ИИ-ассистент покупателя на Wildberries работает на модели из нашего собственного семейства языковых моделей BerryLM, дообученной под сценарии ассистента. На одно сообщение пользователя он делает много вызовов LLM, в нашем тестовом наборе в среднем около 26: разбирает контекст, извлекает предпочтения, генерирует поисковые запросы, подбирает фильтры, пишет ответ. Часть вызовов идёт параллельно. А пользователь всё это время ждёт, так что от скорости генерации напрямую зависит, как быстро ответит ассистент.

Мы перевели ассистента на спекулятивный декодинг. Но сначала прогнали на одном стенде, одной нагрузке и одних данных семь методов: от n-gram без обучения до свежих DFlash 2 и DSpark. Это рассказ о том, что из этого вышло, какие грабли нашлись по дороге и почему в проде в итоге DFlash 2.

Читать далее

Я собрал конвейер из семи ИИ-агентов. В цеху задачу разбирает один

Уровень сложностиСредний
Время на прочтение8 мин
Охват и читатели5.4K

Для своего производства я собрал семь ИИ-агентов. Пять из них разбирают каждое входящее сообщение: от нормализатора до проверяющего, который сам ходит в базу. Первый полный прогон занял 22,7 секунды и стоил 11 центов, а в проверяющем по очереди всплыли четыре бага. Для кнопки «Разобрать с ИИ» в телефоне я в итоге сделал одного агента, в десятки раз дешевле. Рассказываю, почему так и где семь всё-таки нужны.

Читать далее

Я протестировал 10 голосовых ИИ, или насколько мы близки к революции фанатского ИИ-дубляжа?

Уровень сложностиПростой
Время на прочтение17 мин
Охват и читатели9.3K

Полноценный дубляж стоит дорого. Очень и очень дорого. Особенно это заметно в аниме. Чтобы у каждого героя был свой голос, а реплики попадали в движение губ, нужен переводчик, который перепишет текст под длину каждой фразы, режиссер, студия и отдельный актер на каждую роль, который вытянет то, что озвучил сэйю (так называют актеров дубляжа аниме). Фанатским командам такое и не снилось. Почему? Как я и сказал, все упирается в деньги, поэтому фанатская озвучка обычно закадровая: один-три человека читают за всех героев поверх приглушенного японского оригинала, перевод уже сделали энтузиасты и выложили субтитры, а зритель, в итоге, слышит обе дорожки сразу.

Но сейчас же есть нейросети, и они продавали (и продолжают продавать) идею мира, в котором языковой барьер сломан. ElevenLabs продает дубляж как услугу, YouTube уже переводит голос в роликах части каналов автоматически, а открытые модели клонируют голос по нескольким секундам звука и запускаются на домашней видеокарте. Для фанатов это выглядит как мечта: взять голос актера дубляжа прямо из серии, заставить его говорить по-русски и уложить слова в губы. Трудностей у такой мечты четыре, давайте по порядку. 

Читать далее

Ближайшие события

feature_importances_ дал случайному шуму столько же веса, сколько скидке. Почему график важности признаков врёт

Уровень сложностиСредний
Время на прочтение6 мин
Охват и читатели5.5K

График feature_importances_ может убедительно показать, что случайный шум важнее реального бизнес‑фактора, а коррелированные признаки — оказаться бесполезными по отдельности, хотя вместе они определяют качество модели. Разберём на синтетических данных, почему MDI, Permutation Importance и SHAP дают искажённую картину, как выявлять шумовые признаки и учитывать корреляции, чтобы не принимать решения об отборе признаков на основании обманчивого графика.

Разобраться в теме

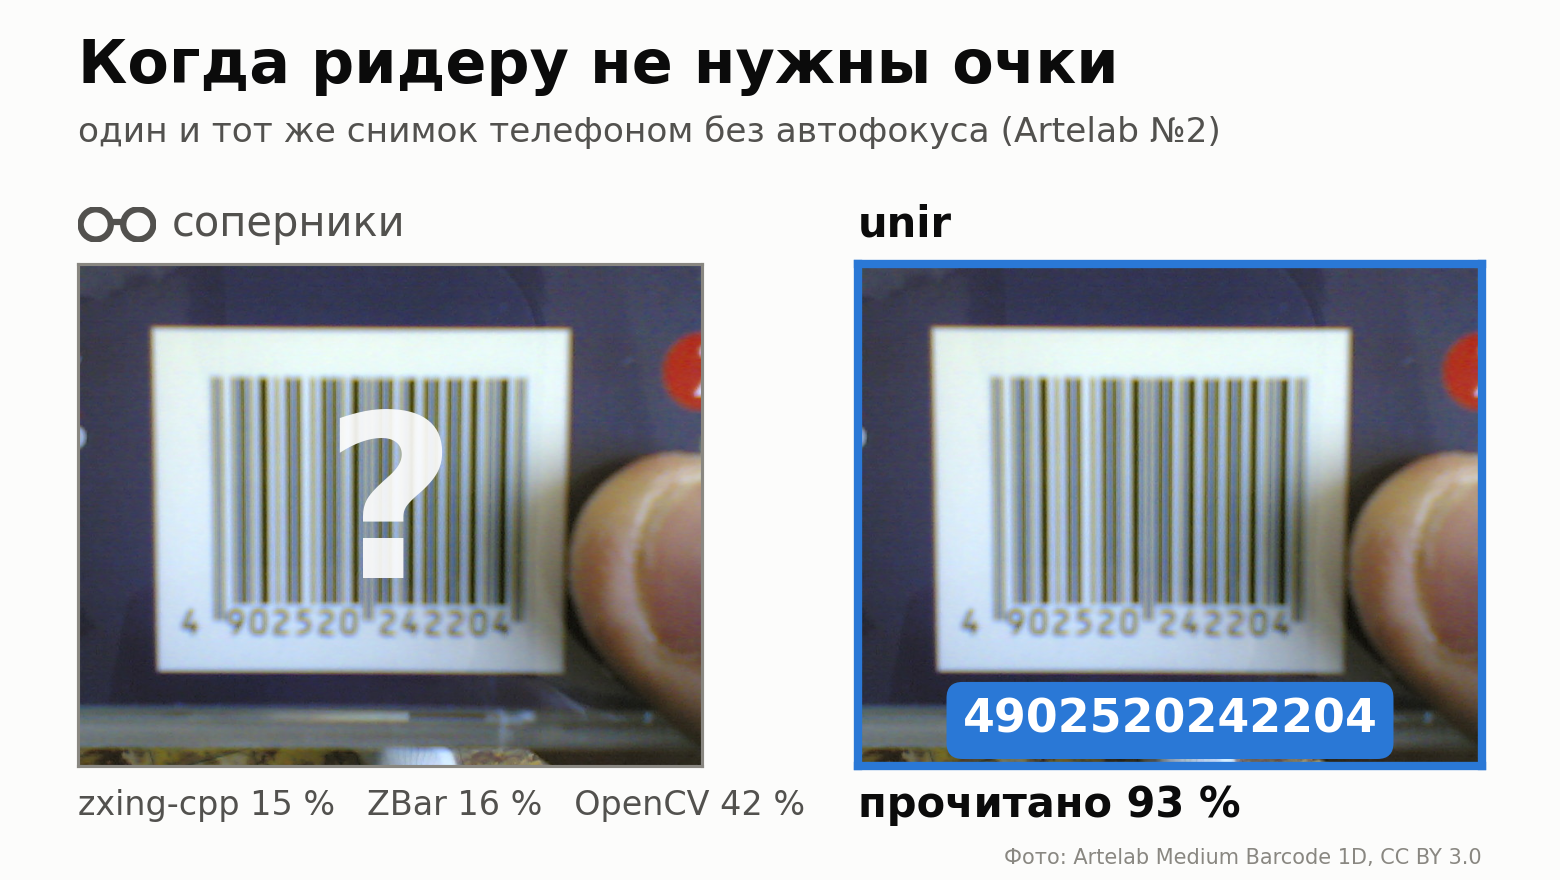
Универсальный ридер кодов libscanner‑unir против zxing‑cpp, ZBar и OpenCV на 6900 снимках из открытых наборов

Уровень сложностиСредний
Время на прочтение22 мин
Охват и читатели11K

EAN-13 на пачке, сфотографированной телефоном без автофокуса. Code 128 на коробке под углом, SSCC на паллетной этикетке, которая проезжает под камерой конвейера. Мы сравнили, как такие снимки читают zxing-cpp, ZBar, OpenCV и движок линейных штрихкодов нашего универсального ридера кодов (unir). Снимки — из открытых наборов с чужой разметкой, их может скачать любой, и любую цифру можно проверить.

Коротко:

Всего прочитано: unir — 72 % из 6899 штрихкодов, ZBar — 56 %, zxing-cpp — 54 %, OpenCV — 42 %.

Главная разница — на размытых снимках. На наборе Artelab-2 unir читает 93 %, соперники — от 15 до 42 %.

Ложных чтений нет у unir, zxing-cpp и ZBar на 4231 снимке без кода; у OpenCV — 7.

По скорости ридеры почти равны: на обычном снимке у всех, кроме ZBar, 10–20 мс. Если на кадр дано 60 мс, чёткие коды все читают почти одинаково, а трудные — только unir.

Слабое место unir: на снимке, который он не может прочитать, он долго перебирает варианты. И часть кодов соперники читают, а он нет — о них ниже.

Читать далее

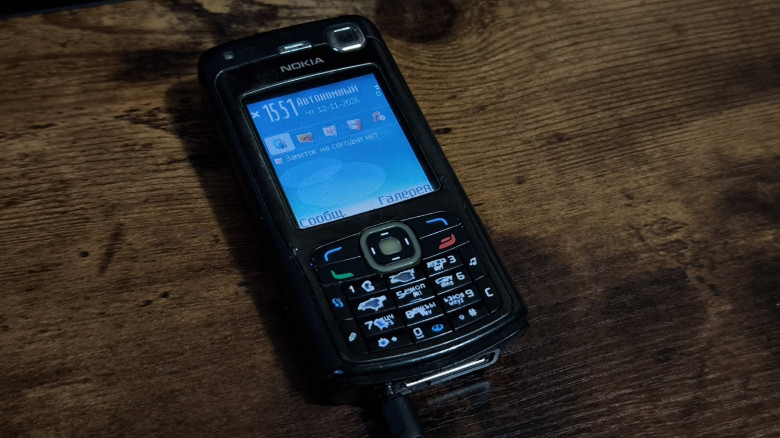
Nokia N70: пишем софт на Symbian в 2026

Уровень сложностиСредний
Время на прочтение15 мин
Охват и читатели13K

Как писать софт на современном ПК для SDK которой больше 20 лет?

У Nokia N70 снова есть непрочитанные. Как я сделал Telegram-пейджер для Symbian 8.1.

Читать далее

Как я разрабатываю систему, которая не верит ИИ‑агенту на слово

Уровень сложностиСложный
Время на прочтение10 мин
Охват и читатели11K

ИИ-агент может самостоятельно разобраться в устройстве сайта, найти ошибку и предложить вполне разумное исправление. Но что, если решение технически правильное, а пользователь разрешал совсем другое? Кто должен проверять действия агента, прежде чем они превратятся в реальные изменения?

В первой статье я рассказывал, как дал ИИ-агенту доступ к MODX через MCP, а во второй — как мы организовали его самостоятельную работу с боевыми сайтами. К тому моменту вокруг MCP уже появилась приличная инфраструктура: файловые операции, блокировки, резервное копирование, история изменений и браузерные проверки.

Читать третью часть

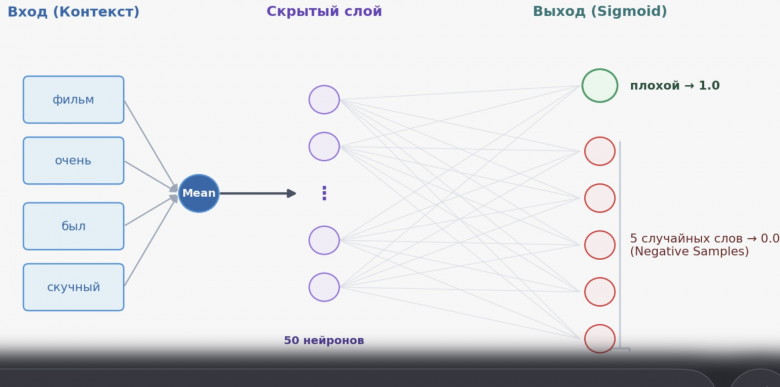
Основы глубокого обучения. Часть 4

Уровень сложностиПростой
Время на прочтение12 мин
Охват и читатели11K

Всем привет! Эта статья является четвёртой в серии статей про основы глубокого обучения. В прошлых трёх частях я рассказал много интересного и полезного новичкам, так что рекомендую перечитать.

В этой части мы продолжим работу с нейронной сетью обработки естественного языка (NLP) и реализуем новую сеть, которая будет определять пропущенное слово по остатку фразы.

Читать далее

1 674 813 токенов в одном запросе: как я чистил контекст OpenWebUI, а потом вынес агента наружу

Время на прочтение9 мин
Охват и читатели6.9K

Input tokens exceed 922,000 tokens. Your messages resulted in 1,674,813 tokens — с этой ошибки началась история, которая растянулась на полгода. У нас self-hosted OpenWebUI, на нём внутренний ассистент для небольшой команды: файлы, документы, мелкие инженерные задачи. Сначала я писал фильтр, который вычищает из истории результаты инструментов. Потом понял, что латаю не то место, и вынес исполнение агента в отдельный сервис на OpenAI Agents SDK и Codex SDK. По дороге ещё споткнулся о потоковый Responses API.

Читать далее

Гвидо ван Россум: памяти Тима Питерса (1952–2026)

Время на прочтение2 мин
Охват и читатели6.9K

Создатель языка программирования Python Гвидо ван Россум с глубокой печалью сообщил, что 15 июля этого года скончался Тим Питерс. «Трудно переоценить вклад Тима в развитие Python. Вероятно, больше всего он известен как автор Zen of Python (PEP 20), но для меня он был наставником и соавтором языка задолго до этого», — написал ван Россум.

Читать далее
1
23 ...