Обновить
4
Константин@coldwind

Пользователь

0,1
Рейтинг
1
Подписчики
Отправить сообщение

MacOS Monterey на Linux — быстро и просто?

Уровень сложностиПростой
Время на прочтение3 мин
Охват и читатели64K
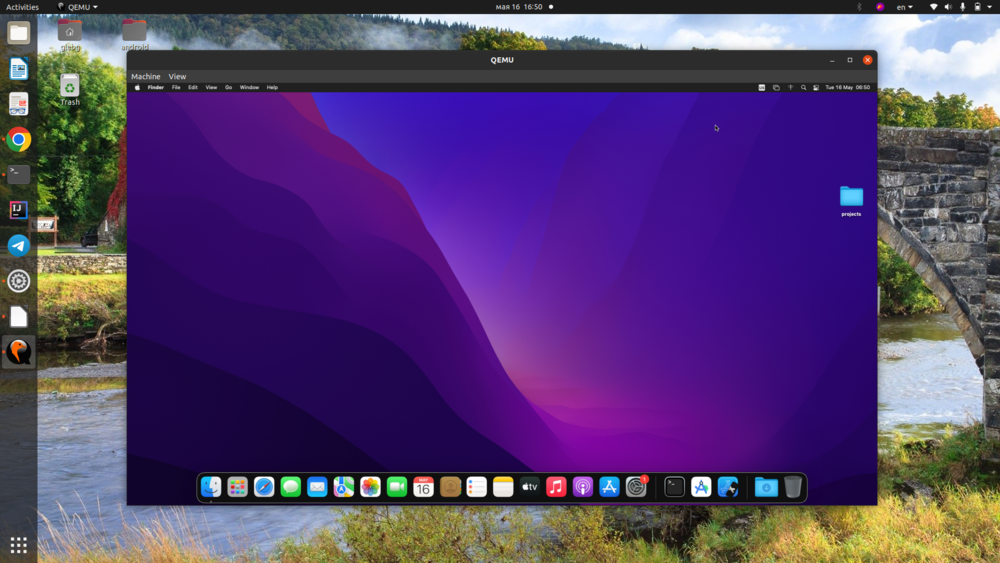
Что делать, если у вас возникло желание или необходимость заняться разработкой под MacOS или iOS, но под рукой нет макбука, а покупать его только чтобы открыть Xcode кажется делом сомнительным? Недавно я столкнулся с такой проблемой в одном из своих пет-проектов и решил ее достаточно просто и быстро. После выполнения нескольких достаточно примитивных шагов, мне удалось запустить MacOS Monterey как на скриншоте ниже.
image

Никакого Virtualbox, никакого Virtual Machine Manager. Из требований — только 100 Гб свободного места на диске и хотя бы 16 Гб оперативной памяти. В рунете я встречал описание похожих путей установки, вроде Docker-OSX или Sosumi. Но я бы хотел поделиться способом, который позволяет использовать актуальную версию MacOS (Sosumi — сразу минус) и не потратить уйму свободного времени на возню с конфигами и терминалом. Поехали.
Читать дальше →

Большие данные мертвы. Это нужно принять

Уровень сложностиСредний
Время на прочтение17 мин
Охват и читатели78K

Уже более десяти лет тот факт, что люди с трудом извлекают из своих данных полезную информацию, сбрасывают на чересчур большой размер этих данных. «Объем собираемой информации слишком велик для ваших хилых систем», — такой нам ставили диагноз. А лекарство, соответственно, заключалось в том, чтобы купить какую‑нибудь новую причудливую технологию, которая сможет работать в больших масштабах. Конечно, после того, как целевая группа по Big Data покупала новые инструменты и мигрировала с устаревших систем, компании снова обнаруживали, что у них по‑прежнему возникают проблемы с пониманием своих данных.

В результате постепенно некоторые начинали понимать, что размер данных вообще не был проблемой.

Мир в 2023 году выглядит иначе, чем когда зазвенели первые тревожные звоночки по поводу Big Data. Катаклизм обработки информации, который все предсказывали, не состоялся. Объемы данных, возможно, немного возросли, но возможности аппаратного обеспечения росли еще быстрее. Поставщики услуг все еще продвигают свои возможности масштабирования, но люди, которые сталкиваются с ними на практике, начинают задаваться вопросом, как они вообще связаны с их реальными проблемами.

А дальше будет и того интереснее.

Читать далее

Не лечите меня, доктор

Время на прочтение13 мин
Охват и читатели44K
Когда собирали доклады на голосование для участия в одной специализированной конференции, я хотел рассказать такую тему – как подсидеть директора по качеству. Это был бы конъюнктурный доклад про карьерный рост для программиста или ИТ-директора.

С одной стороны, рост в сторону директора по качеству кажется странным – это вроде совсем другая область. Но, как мы все уже знаем, из программиста может вырасти дофига чего интересного. Это не только я говорю – такая мысль звучит все чаще. Например, на той же конференции другого года был доклад на эту тему — как на западе ИТ-директора уходят в операционный менеджмент, не связанный с ИТ.

Тема управления качеством лично мне кажется невероятно, просто ужасно интересной и безумно полезной. Не потому, что управление качеством – как новый сезон Шерлока или тряхнувшего стариной Джека Бауэра. Просто управление качеством в нашей стране – это пример исключительно наглого, циничного, элементарного, тупейшего, и оттого удивительно эффективного шарлатанства.

Я не знаю ни одной другой отрасли знаний, в которой трудилось бы такое же количество людей, ничего не понимающих в своей профессии. Это не шутка, не гипербола. Я наблюдаю за этими ребятами больше 15 лет — еще с тех пор, когда сертификат ISO еще был престижной редкостью. Я работал с директорами по качеству и специалистами, консультантами и аудиторами, преподавателями ВУЗов и президентами ассоциаций, студентами и аспирантами. Сколько из них, по-вашему, знают и понимают, что такое управление качеством и как его осуществлять? А, вы же знаете, я выше написал – ноль. Ладно, пусть будет 1 % — наверняка где-то, случайно, или волею небес, есть люди, которые что-то понимают. Ну и вы, если внимательно и без предубеждения отнесетесь к управлению качеством, тоже будете понимать. Так, может, и до 2% дотянем.
Читать дальше →

Телеметрия и программное обеспечение

Время на прочтение6 мин
Охват и читатели31K


Около 6 лет назад я участвовал в проекте по изготовлению железа и софта для одной крупной Североамериканской медицинской компании. Стоя возле тестовой стойки, в которой под нагрузкой было несколько устройств, я задал себе вопрос: «Если что-то пойдет не так, как нам ускорить поиск и исправление ошибки?»

С момента возникновения этого вопроса и до сегодняшнего дня было сделано очень много, и я хотел бы поделиться с вами тем как сбор и анализ телеметрии в софте и железе помог значительно снизить время обнаружения и исправления ошибок в целом спектре проектов, в которых я участвовал.
Читать дальше →

«Паттерны» функционального программирования

Время на прочтение10 мин
Охват и читатели76K

Многие люди представляют функциональное программирование как нечто очень сложное и «наукоемкое», а представителей ФП-сообщества – эстетствующими философами, живущими в башне из слоновой кости.

До недавнего времени такой взгляд на вещи действительно был недалек от истины: говорим ФП, подразумеваем Хаскель и теорию категорий. В последнее время ситуация изменилась и функциональная парадигма набирает обороты в web-разработке, не без помощи F#, Scala и React. Попробуем взглянуть на «паттерны» функционального программирования, полезные для решения повседневных задач с точки зрения ООП – парадигмы.

ООП широко распространено в разработке прикладного ПО не одно десятилетие. Все мы знакомы с SOLID и GOF. Что будет их функциональным эквивалентом?.. Функции! Функциональное программирование просто «другое» и предлагает другие решения.


Читать дальше →

Методы обхода защитных средств веб-приложений при эксплуатации XSS-векторов

Время на прочтение8 мин
Охват и читатели44K
image

 
Несмотря на большое количество рекомендаций по защите веб-приложения от клиент-сайд атак, таких как XSS (cross site scripting) многие разработчики ими пренебрегают, либо выполняют эти требования не полностью. В статье будут рассмотрены способы обхода средств фильтрации и при эксплуатации xss-векторов.

Читать дальше →

OpenSSL, ssl_ciphers и nginx: прокачиваем на 100%

Время на прочтение11 мин
Охват и читатели104K


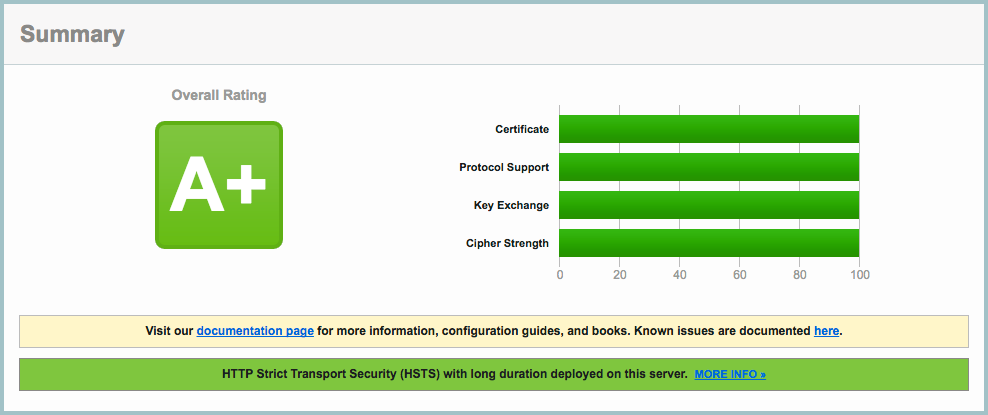
Много где написано о том, как получить 100% и A+ по тесту от Qualys. При всём при том практически везде директивы ssl_ciphers и подобные даются как эдакие магические строки, которые нужно просто вставить, и надеяться, что автор не подводит вас под монастырь. Эта статья призвана исправить это недоразумение. По прочтению этой статьи директива ssl_ciphers потеряет для вас всякую магию, а ECDHE и AES будут как друзья да братья.


Также вы узнаете почему 100% по тестам — не всегда хорошо в реальности.

Читать дальше →

Профилирование и оптимизация программ на Go

Время на прочтение25 мин
Охват и читатели117K

Введение


В этой статье я расскажу, как профилировать и оптимизировать приложения на языке Go с использованием встроенных и общих инструментов, доступных в ОС Linux.

Что такое профайлинг и оптимизация? Если ваша программа работает недостаточно быстро, использует слишком много памяти, неоптимально использует процессор, вы хотите понять, в чем дело, и исправить — это и есть профайлинг и оптимизация.

Я привел такое определение, чтобы сразу отсечь вопросы некорректной работы приложения. В этой статье мы не будем говорить о проблемах мультитредового программирования, о дата-рейсах (англ. data race), о поиске ошибок (англ. debugging). Для всего этого в Go есть свои утилиты и подходы, но оставим эту тему на будущее.


Читать дальше →

Лучшие практики Go, шесть лет в деле

Время на прочтение18 мин
Охват и читатели62K
В 2014 году я выступил на открытии конференции GopherCon с докладом под названием «Go: Best Practices for Production Environments». В SoundCloud мы были одними из первых пользователей Go и к тому времени уже два года писали на нём и поддерживали Go в бою в той или иной форме. За это время мы кое-чему научились, и я попытался поделиться частью этого опыта.

С тех пор я продолжал программировать на Go в течение всего рабочего дня, сначала в командах SoundCloud, отвечающих за операционную деятельность и инфраструктуру, а теперь работаю в компании Weaveworks над Weave Scope и Weave Mesh. Также я усердно трудился над Go kit, набором инструментов для микросервисов с открытым исходным кодом. И всё это время я принимал активное участие в развитии сообщества Go-программистов, встречался со многими разработчиками на митапах и конференциях по всей Европе и в США, коллекционируя их истории успехов и провалов.

В ноябре 2015-го, на шестую годовщину релиза Go, я вспоминал то своё первое выступление. Какие из лучших практик прошли проверку временем? Какие из них устарели или стали неэффективными? Появились ли какие-то новые методики? В марте мне представилась возможность выступить на конференции QCon London, где я рассказал о лучших практиках 2014 года и дальнейшем развитии Go до 2016 года. В этом посте представлена выжимка из моего выступления.

Ключевые положения я выделил в тексте в виде Top Tips — лучших советов.

А вот и cодержание:

  1. Среда разработки
  2. Структура репозитория
  3. Форматирование и стиль
  4. Конфигурация
  5. Разработка программы
  6. Логирование и метрики
  7. Тестирование
  8. Управление зависимостями
  9. Сборка и развёртывание
  10. Заключение
Читать дальше →

Подборка: Более 70 источников по машинному обучению для начинающих

Время на прочтение5 мин
Охват и читатели104K


Индикатор кулачкового аналогового компьютера / Wiki

В нашем блоге мы уже рассказывали о разработке системы квантовой связи и о том, как из простых студентов готовят продвинутых программистов. Сегодня мы решили вернуться к теме машинного обучения и привести адаптированную (источник) подборку полезных материалов.
Читать дальше →

Коллекция практических советов и заметок по вёрстке

Время на прочтение32 мин
Охват и читатели194K

CSS Refresher


Это большая коллекция практических советов и заметок по вёрстке. Своеобразная памятка для тех, кто каждодневно использует CSS. Освещаются самые разные темы, от деталей поведения плавающих элементов до использования SVG и спрайтов. Проект постоянно обновляется, активное сообщество github также принимает в нем участие, там добавляются интересные замечания, о которых, возможно, вы и не слышали.

От переводчика


Приветствую всех, меня зовут Максим Иванов, и сегодня я подготовил для вас перевод заметок разработчика из Сан-Франциско Васанта Кришнамурти (Vasanth Krishnamoorthy) «CSS Refresher». Web-программирование одна из самых быстро развивающихся отраслей в наше время. Казалось бы, возьми какой-нибудь видеокурс на tuts+ и освой html-верстку, однако, как говорил разработчик Opera Software Вадим Макеев, выступая на конференции CodeFest, они все равно это делают плохо. Но давайте посмотрим, может мы итак все это знаем.

Содержание


  1. Позиционирование (position)
  2. Отображение элемента в документе (display)
  3. Плавающие элементы (float)
  4. CSS селекторы
  5. Эффективные селекторы
  6. Переотрисовка и перерасчет
  7. CSS3 свойства
  8. CSS3 медиа-запросы
  9. Адаптивный web-дизайн
  10. CSS3 переходы
  11. CSS3 анимации
  12. Масштабируемая векторная графика (SVG)
  13. CSS спрайты
  14. Вертикальное выравнивание
  15. Известные проблемы

Читать дальше →

Внедрение компонентого подхода в вебе: обзор веб-компонентов

Время на прочтение18 мин
Охват и читатели32K


Четыре из пяти самых запрашиваемых новых платформенных возможностей Edge на User Voice (Shadow DOM, Template, Custom Elements, HTML Imports) относятся к семейству API, называемых веб-компонентами (Web Components). В этой статье мы хотим рассказать о веб-компонентах и нашем взгляде на них, некоторой внутренней кухне, для тех, кто еще с ними не знаком, а также порассуждать на тему того, куда все это может эволюционировать в будущем. Это довольно-таки длинный рассказ, поэтому откиньтесь назад, возьмите кофе (или не кофеиновый напиток) и начинайте читать.

Содержание:
  • Внедрение компонентов: старая практика проектирования, ставшая новой для веба
  • Как разбивать на компоненты
  • Это все не в первый раз: предыдущие подходы к внедрению компонентов
  • Современные веб-компоненты
  • Веб-компоненты: следующее поколение

Читать дальше →

Пишем maintainable код

Время на прочтение8 мин
Охват и читатели48K
У нас сотни программных проектов на поддержке, некоторые из них поддерживаются нами почти десять лет. Нетрудно догадаться, что понятие maintainable кода (переведу это понятие как код, легкий в поддержке) является у нас одним из основных. По счастливому стечению обстоятельств легкий в поддержке код также является и легким для (unit-)тестирования, легким для освоения новыми членами команды и т.д. Скорее всего, это связано с тем, что для создания maintainable кода приходится озаботиться хорошей архитектурой проекта и завести несколько хороших привычек.
В этой статье и поговорим о таких привычках, благодаря которым часто хорошая архитектура получается сама собой. Постараюсь также иллюстрировать все хорошими примерами.

Читать дальше →

Всё (или почти всё) о пробеле

Время на прочтение13 мин
Охват и читатели150K
Как следует из заголовка, речь в статье пойдёт о неотъемлемой части любого русскоязычного (и не только) текста — о пробеле. Мы затронем историю пробела, виды пробелов, вопросы употребления пробела в веб-типографике.

Вообще говоря, пробел — это любое пустое место в рукописном, печатном или отображаемом на любом другом носителе тексте. Так что пробелы бывают разные:
  • спусковые (большие вертикальные пропуски в первой полосе издания) и концевые пробелы полосы,
  • абзацные отступы и концевые пробелы абзаца,
  • межстрочные пробелы (между строками текста),
  • межсловные пробелы (между словами в одной строке),
  • межбуквенные пробелы (между буквами в слове).
Далее речь пойдёт о межсловных пробелах, разделяющих слова, и функционально принадлежащих к знакам препинания.
Читать дальше →

Как правильно мерять производительность диска

Время на прочтение14 мин
Охват и читатели369K
abstract: разница между текущей производительностью и производительностью теоретической; latency и IOPS, понятие независимости дисковой нагрузки; подготовка тестирования; типовые параметры тестирования; практическое copypaste howto.

Предупреждение: много букв, долго читать.

Лирика


Очень частой проблемой, является попытка понять «насколько быстрый сервер?» Среди всех тестов наиболее жалко выглядят попытки оценить производительность дисковой подсистемы. Вот ужасы, которые я видел в своей жизни:
  • научная публикация, в которой скорость кластерной FS оценивали с помощью dd (и включенным файловым кешем, то есть без опции direct)
  • использование bonnie++
  • использование iozone
  • использование пачки cp с измерениема времени выполнения
  • использование iometer с dynamo на 64-битных системах


Это всё совершенно ошибочные методы. Дальше я разберу более тонкие ошибки измерения, но в отношении этих тестов могу сказать только одно — выкиньте и не используйте.

Как мерять правильно

Новые аттачи в Яндекс.Почте

Время на прочтение8 мин
Охват и читатели33K
Мы стремимся к тому, чтобы все части Яндекс.Почты одинаково хорошо работали у всех пользователей. Сегодня мы расскажем вам о том, как и зачем полностью переписали блок добавления аттачей. В этой статье — про отказ от флеша, поддержку возможностей современных браузеров и, как результат, увеличение скорости и надёжности загрузки файлов.

Проблема

Раньше всю аудиторию Яндекс.Почты мы разделяли на пользователей с флешем и без.

С первыми всё было просто: пользователи с установленным флешем прикрепляли файлы к письму через флеш-загрузчик. Он позволял загрузить сразу несколько файлов, определял их размер и контролировал процесс загрузки.

А вот с пользователями без флеша (8-10% от дневной аудитории) было сложнее. Мы предлагали им загружать файлы через обычную форму с />. Файлы из неё отправлялись через iframe вместе с содержимым самого письма, и это занимало много времени. Нажав кнопку «Отправить», пользователь долго ждал, пока загрузятся файлы.
Читать дальше →

Вам не страшно открывать редактор?

Время на прочтение13 мин
Охват и читатели3.3K
В какой-то момент я стал замечать, что пишу более качественный: оптимальный, логичный и читаемый код, но пишу его медленно. По крайней мере, куда медленнее, чем лет 15 назад. Да, на старый код без слёз не взглянешь: всё можно сделать оптимальнее и, по крайней мере, читабельнее. Но код был написан быстро.

Проблема в контроле. Я стал жестче и глубже контролировать код и… стал тратить на этот контроль слишком много ресурсов.

Основной принцип прост. Если контролю подлежит 10-20% случаев, то на контроль надо тратить… 0% ресурсов. Баги и переписывания всё равно будут. Но лучше разделить кодирование и отладку и на время кодирования об ошибках вообще забыть.
Читать дальше →

37signals: почему в нашей компании нет менеджеров

Время на прочтение5 мин
Охват и читатели26K
Перевод статьи Джейсона Фрида (Jason Fried) "Why I Run a Flat Company". Джейсон — один из основателей компании 37signals и соавтор книг "Getting Real" и "Rework".

Несколько месяцев назад в компании 37signals, которую я возглавляю, случилось необыкновенное событие: мы расстались с одним из наших сотрудников. Казалось бы, что в этом необычного? Но дело в том, что в нашей компании подобное происходит крайне редко. За 11 лет работы мы потеряли всего лишь пять человек, причем один из них вернулся к нам семь лет спустя.

Удивителен даже не сам факт того, что мы расстались с нашим сотрудником. Удивительна причина нашего расставания: нас не устраивал уровень его карьерных амбиций. Причем проблема была вовсе не в их отсутствии: напротив, он хотел гораздо больше, чем мы могли ему дать.

Читать дальше →

Clustered index в InnoDB и оптимизация запросов

Время на прочтение7 мин
Охват и читатели19K
В последнее время в сети часто пишут про clustered index в InnoDB и таблицах MySQL, но, несмотря на это, на практике используют довольно редко.
В данной статье мы покажем на двух реальных примерах, как мы оптимизировали достаточно сложные системы Badoo, основываясь на понимании принципов работы clustered index.

Clustered index – форма организации таблицы в файле. В InnoDB данные хранятся в дереве, в таком же, в котором лежат обычные B-TREE ключи. Таблица InnoDB сама по себе уже является большим B-TREE. В качестве значений ключа используется clustered index. Согласно документации, в качестве clustered index выбирается PRIMARY KEY. Если PRIMARY KEY отсутствует – выбирается первый UNIQUE KEY. Если и такого нет, то используется внутренний 6-тибайтный код.

Что же вытекает из такой организации данных на диске?
Читать дальше →

Тестирование параллельных потоков

Время на прочтение5 мин
Охват и читатели8.4K
В дебагере можно без проблем поймать поток исполнения в правильной точке, а затем, после проведения анализа, перезапустить его. В автоматических тестах эти операции выглядят безумно сложными.

А зачем вообще это нужно?

Читать дальше →
1

Информация

В рейтинге
3 306-й
Откуда
Санкт-Петербург, Санкт-Петербург и область, Россия
Дата рождения
Зарегистрирован
Активность