Обновить
128K+

Обработка изображений *

Работаем с фото и видео

101,42
Рейтинг
Сначала показывать
Порог рейтинга
Уровень сложности

Используем данные на практике

Время на прочтение7 мин
Охват и читатели3.3K
Между идеальным алгоритмом машинного обучения в вакууме и его применением на реальных данных часто лежит пропасть. Вроде бы берешь статью: алгоритм есть, сходимость для данных такого-то типа есть — бери и применяй. Но почему-то оказывается, что твоих данных недостаточно для обучения, да и отличаются они от модельных из статьи, потому что настоящие, не синтетические.

Обычное дело в обосновании алгоритма ввести допущения о чистоте данных и их распределении, которых в реальной жизни не найдёшь. Например, автор статьи экспериментирует на фотографиях взрослых знаменитостей, и все у него замечательно распознается и классифицируется, а в нашем реальном примере попадаются еще и дети, и мультяшные персонажи, и на них всё внезапно ломается. Но есть люди, которые умеют с этим справляться, да так, что пропасть между теорией и практикой перестает казаться неприступной, и, стоит показать как, сразу находятся и другие желающие ее преодолеть.

Читать дальше →

Распознавание дороги посредством семантической сегментации

Время на прочтение4 мин
Охват и читатели11K
В предыдущей серии я проводил эксперимент с автономным движением своего домашнего танка. Дорога распознавалась с помощью цветового фильтра, а полученная маска шла на вход специально обученной нейросети-классификатору, которая выбирала ехать вправо, влево или прямо.

Слабым местом было распознавание самого дорожного полотна из-за переменчивости цветовых оттенков, из-за чего нейросеть, принимающая решения, выдавала странные результаты. В комментариях к той статье рекомендовали обратить внимание на семантическую сегментацию. Тема оказалась перспективной и применение сегментирующей нейросети принесло свои плюсы, но и минусы, куда же без них.

Но обо всем по порядку и для начала немного матчасти.
Читать дальше →

OpenCV на STM32F7-Discovery

Время на прочтение7 мин
Охват и читатели16K

Я один из разработчиков операционной системы Embox, и в этой статье я расскажу про то, как у меня получилось запустить OpenCV на плате STM32746G.


Если вбить в поисковик что-то вроде "OpenCV on STM32 board", можно найти довольно много тех, кто интересуется использованием этой библиотеки на платах STM32 или других микроконтроллерах.
Есть несколько видео, которые, судя по названию, должны демонстрировать то, что нужно, но обычно (во всех видео, которые я видел) на плате STM32 производилось только получение картинки с камеры и вывод результата на экран, а сама обработка изображения делалась либо на обычном компьютере, либо на платах помощнее (например, Raspberry Pi).

Читать дальше →

Где находился Ваш дом миллионы лет назад

Время на прочтение2 мин
Охват и читатели65K


Виртуальный геохронологический глобус, на котором можно увидеть, как выглядела поверхность нашей планеты в разные эры (Нео-протерозой, Палеозой, Мезозой, Кайнозой), начиная от временного промежутка в 750 миллионов лет назад.
Читать дальше →

Лопнул ли пузырь машинного обучения, или начало новой зари

Время на прочтение10 мин
Охват и читатели112K
Недавно вышла статья, которая неплохо показывает тенденцию в машинном обучении последних лет. Если коротко: число стартапов в области машинного обучения в последние два года резко упало.

image

Ну что. Разберём «лопнул ли пузырь», «как дальше жить» и поговорим откуда вообще такая загогулина.

Data Science и конференция в тропиках

Время на прочтение5 мин
Охват и читатели8.5K
Статьи про компьютерное зрение, интерпретируемость, NLP – мы побывали на конференции AISTATS в Японии и хотим поделиться обзором статей. Это крупная конференция по статистике и машинному обучению, и в этом году она проходит на Окинаве – острове недалеко от Тайваня. В этом посте Юлия Антохина (Yulia_chan) подготовила описание ярких статей из основной секции, в следующем вместе с Анной Папета расскажет про доклады приглашенных лекторов и теоретические исследования. Немного расскажем и про то, как проходила сама конференция и про “неяпонскую” Японию.

image
Читать дальше →

Отличаем символы от мусора: как построить устойчивые нейросетевые модели в задачах OCR

Время на прочтение8 мин
Охват и читатели8.2K
В последнее время мы в группе распознавания компании ABBYY всё больше применяем нейронные сети в различных задачах. Очень хорошо они зарекомендовали себя в первую очередь для сложных видов письменности. В прошлых постах мы рассказывали о том, как мы используем нейронные сети для распознавания японской, китайской и корейской письменности.

image Пост про распознавания японских и китайских иероглифов
image Пост про распознавание корейских символов

В обоих случаях мы использовали нейронные сети с целью полной замены метода классификации отдельного символа. Во всех подходах фигурировало множество различных сетей, и в задачи некоторых из них входила необходимость адекватно работать на изображениях, которые не являются символами. Модель в этих ситуациях должна как-то сигнализировать о том, что перед нами не символ. Сегодня мы как раз расскажем о том, зачем это в принципе может быть нужно, и о подходах, с помощью которых можно добиться желаемого эффекта.

Мотивация


А в чём вообще проблема? Зачем нужно работать на изображениях, которые не являются отдельными символами? Казалось бы, можно разделить фрагмент строки на символы, классифицировать их все и собрать из этого результат, как, например, на картинке ниже.


Да, конкретно в данном случае так действительно можно сделать. Но, увы, реальный мир устроен куда более сложно, и на практике при распознавании приходится иметь дело с геометрическими искажениями, смазом, пятнами кофе и прочими трудностями.
Читать дальше →

Как устроен формат JPEG

Время на прочтение13 мин
Охват и читатели122K

Изображения формата JPEG встречаются повсюду в нашей цифровой жизни, но за этим покровом осведомлённости скрываются алгоритмы, устраняющие детали, не воспринимаемые человеческим глазом. В итоге получается высочайшее визуальное качество при наименьшем размере файла – но как конкретно всё это работает? Давайте посмотрим, чего именно не видят наши глаза!


Легко принять, как само собой разумеющееся, возможность отправить фотку другу, и не волноваться по поводу того, какое устройство, браузер или операционную систему он использует – однако так было не всегда. К началу 1980-х компьютеры умели хранить и показывать цифровые изображения, однако по поводу наилучшего способа для этого существовало множество конкурирующих идей. Нельзя было просто отправить изображение с одного компьютера на другой и надеяться, что всё заработает.
Читать дальше →

Samsung открывает бесплатный онлайн-курс по нейросетям в задачах компьютерного зрения

Время на прочтение4 мин
Охват и читатели25K
Вы пока не разбираетесь, почему ReLU лучше сигмоиды, чем отличается Rprop от RMSprop, зачем нормализировать сигналы и что такое skip connection? Зачем нейронной сети нужен граф, и какую он совершил ошибку, что она распространяется обратно? У вас есть проект с компьютерным зрением или, может быть, делаете межгалактического робота для борьбы с грязными тарелками, и хотите, чтобы он мог сам решать, отмывать или и так сойдет?

Мы запускаем открытый курс «Нейронные сети и компьютерное зрение», который адресован тем, кто в этой области делает первые шаги. Курс разработан экспертами Samsung Research Russia: Исследовательского центра Samsung и Центра искусственного интеллекта Samsung в Москве. Сильные стороны курса:

  • авторы курса знают, о чем говорят: это инженеры московского Центра искусственного интеллекта Samsung, Михаил Романов и Игорь Слинько;
  • есть как теория с задачками, так и практика на PyTorch
  • приступаем к практике сразу после освоения минимальных теоретических знаний.
  • лучшие студенты будут приглашены на собеседование в Samsung Research Russia!


Читать дальше →

Создание мозаичной картинки

Время на прочтение5 мин
Охват и читатели11K
Наверняка вы неоднократно видели в интернете такие картинки:

image

Я решил написать универсальный скрипт для создания подобных изображений.
Читать дальше →

Реставрируем фотографии с помощью нейросетей

Время на прочтение8 мин
Охват и читатели125K


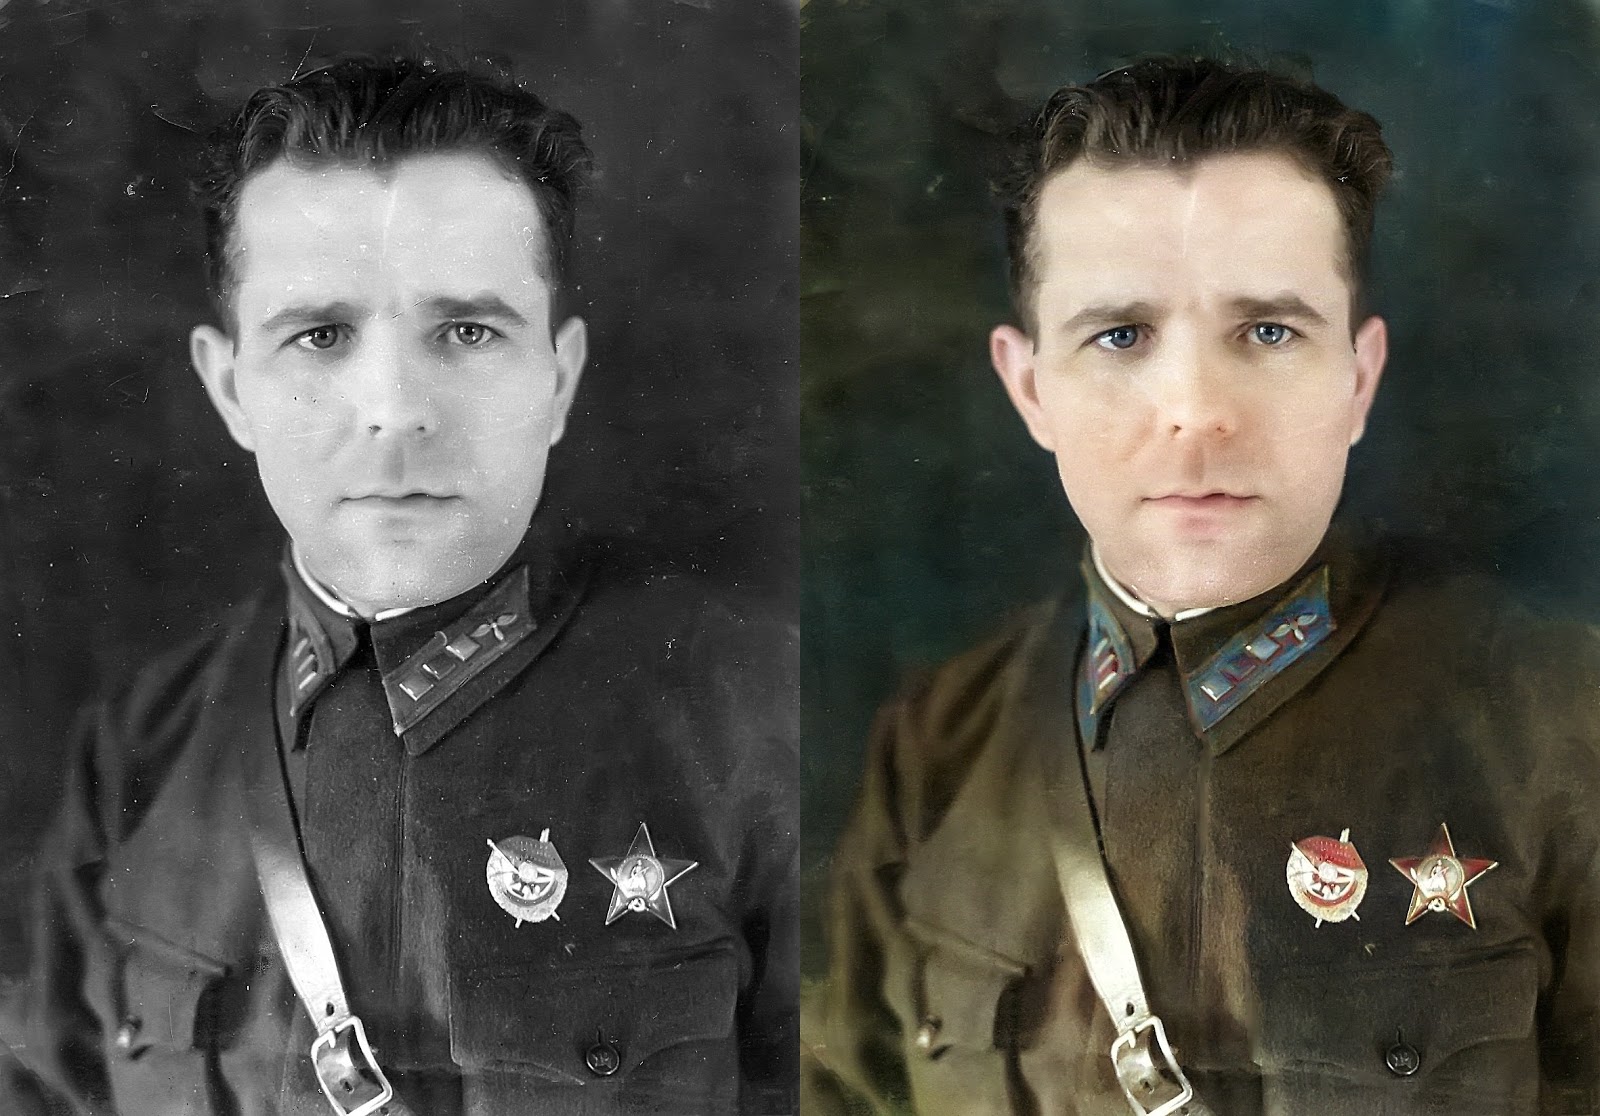
Всем привет, я работаю программистом-исследователем в команде компьютерного зрения Mail.ru Group. Ко Дню Победы в этом году мы решили сделать проект по реставрации военных фотографий. Что такое реставрация фотографий? Она состоит из трех этапов:

  • находим все дефекты изображения: надломы, потертости, дырки;
  • закрашиваем найденные дефекты, основываясь на значениях пикселей вокруг них;
  • раскрашиваем изображение.

В этой статье я детально пройдусь по каждому из этапов реставрации и расскажу, как и где мы брали данные, какие сети мы учили, что у нас получилось, на какие грабли мы наступили.
Читать дальше →

Нейронные сети предпочитают текстуры и как с этим бороться

Время на прочтение7 мин
Охват и читатели33K


В последнее время вышло несколько статей с критикой ImageNet, пожалуй самого известного набора изображений, использующегося для обучения нейронных сетей.


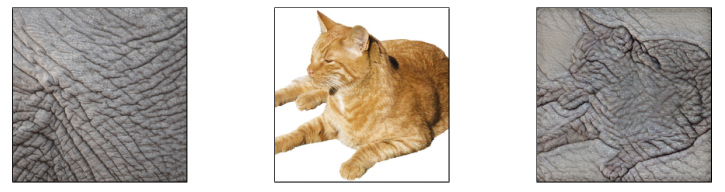
В первой статье Approximating CNNs with bag-of-local features models works surprisingly well on ImageNet авторы берут модель, похожую на bag-of-words, и в качестве "слов" используют фрагменты из изображения. Эти фрагменты могут быть вплоть до 9х9 пикселей. И при этом, на такой модели, где полностью отсутствует какая-либо информация о пространственном расположении этих фрагментов, авторы получают точность от 70 до 86% (для примера, точность обычной ResNet-50 составляет ~93%).


Во второй статье ImageNet-trained CNNs are biased towards texture авторы приходят к выводу, что виной всему сам набор данных ImageNet и то, как изображения воспринимают люди и нейронные сети, и предлагают использовать новый датасет – Stylized-ImageNet.


Более подробно о том, что на картинках видят люди, а что нейронные сети

Читать дальше →

Как увидеть реверберацию или передача видео звуком через воду — 2

Время на прочтение8 мин
Охват и читатели11K

Привет, глубокоуважаемые!


Сегодня мы опять будем передавать картинку ультразвуком через воду: буквально увидим реверберацию и эхо, и даже то, как они меняются в зависимости от условий. Все о чем я расскажу несложно, интересно повторить самостоятельно и под силу практически любому.

Если в вашей душе от этих слов что-то колыхнулось, добро пожаловать под кат, в темные воды нашего пруда!


Читать дальше →

Ближайшие события

Как eBay делал сканер штрих-кодов на WebAssembly

Время на прочтение8 мин
Охват и читатели7.9K
С момента своего анонса технология WebAssembly сразу привлекла внимание разработчиков фронтенда. Веб-сообщество с энтузиазмом восприняло идею запустить в браузере код, написанный на других языках, кроме JavaScript. Главное, что WebAssembly гарантирует скорость намного выше, чем JavaScript.

Наши инженеры внимательно следили за развитием стандарта. Как только поддержку WebAssembly 1.0 внедрили во всех основных браузерах, разработчики сразу захотели опробовать её.

Но тут возникла проблема. Хотя многие приложения выигрывают от WebAssembly, но область применения технологии в электронной коммерции всё ещё примитивна. Мы не смогли сразу найти правильный вариант её использования. Было несколько предложений, но во всех вариантах JavaScript подходил лучше. Когда мы в eBay оцениваем новые технологии, то первый вопрос: «Какова потенциальная выгода для наших клиентов?» Если здесь нет ясности, мы не переходим к следующему шагу. Очень легко увлечься новой модной технологией, даже если она не имеет никакого значения для клиентов и только усложняет существующий рабочий процесс. Пользовательский опыт всегда важнее опыта разработчика. Но с WebAssembly иначе. У этой технологии огромный потенциал, просто мы не могли найти правильный вариант использования. Впрочем, в итоге всё-таки нашли.
Читать дальше →

Марс — еще больше льда в районе северного полюса, но глубоко

Время на прочтение5 мин
Охват и читатели16K


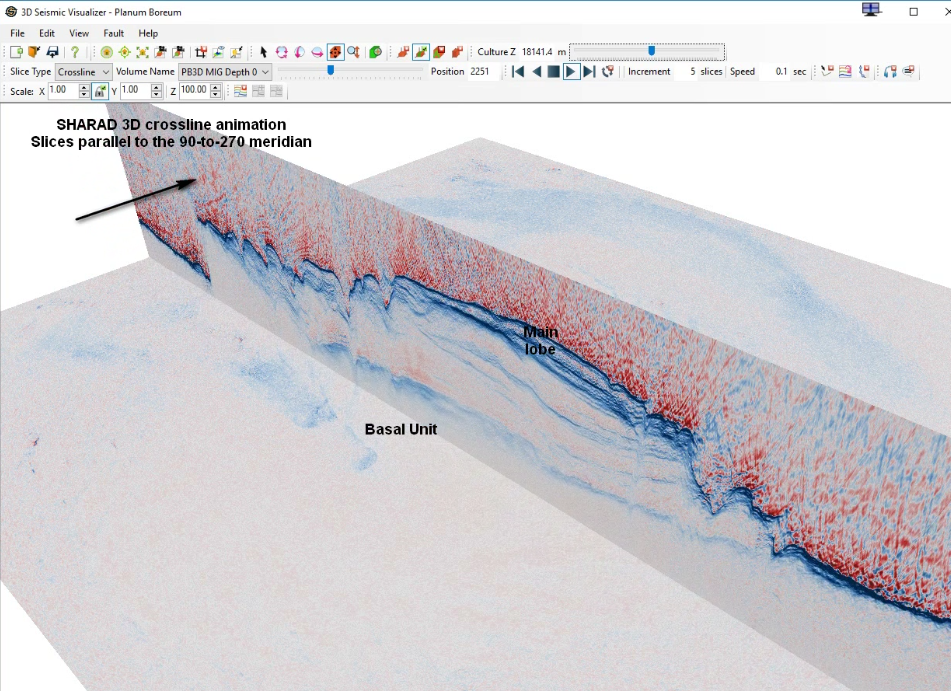
Новое исследование, основанное на анализе данных от радара SHARAD (установлен на аппарате MRO (Mars Reconnaissance Orbiter)), показало интересные результаты — обнаружены обширные слои льда и песка (содержащие до 90% воды) на глубине более полутора километров под поверхностью Марса в окрестностях северного полюса, причем их объема достаточно, чтобы покрыть всю красную планету слоем воды глубиной не менее 1,5 метра, сделав ее немного голубоватой.
Читать дальше →

Умный парсер числа, записанного прописью

Время на прочтение10 мин
Охват и читатели32K


Пролог


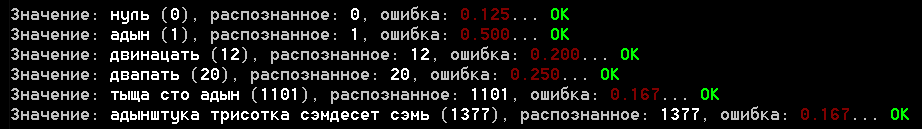
Добрый день, уважаемые читатели. В данной статье я расскажу о том, как распарсить число, записанное прописью на русском языке.


Умным данный парсер делает возможность извлечения чисел из текста с ошибками, допущенными в результате некорректного ввода или в результате оптического распознавания текста из изображения (OCR).


Для ленивых:
Ссылка на проект github: ссылка.


Читать дальше →

Приключения в отдельном потоке. Доклад Яндекса

Время на прочтение11 мин
Охват и читатели6.9K
Как работать с изображениями на клиенте, сохраняя плавность UI? Разработчик интерфейсов Павел Смирнов рассказал об этом на основе опыта разработки поиска по фотографиям на Маркете. Из доклада можно узнать, как правильно использовать Web Workers и OffscreenCanvas.


— На протяжении этого получаса мы поговорим о приключениях. Я расскажу о своем приключении и очень надеюсь, что мой доклад вдохновит вас и вы возьмете и сделаете то же самое у себя.

Читать дальше →

OpenCV 4.0 и 4.1 — что нового?

Время на прочтение3 мин
Охват и читатели13K


Мы возвращаемся к рассказу об open source библиотеке компьютерного зрения OpenCV. Проект живет и развивается, движимый командой разработчиков, работающих в компании Intel, а также неугасающей поддержкой community. В конце 2018 года увидел свет первый стабильный релиз из ветки 4.х, а буквально месяц назад вышло новое обновление — версия 4.1. Мы попросили авторов библиотеки перечислить кратко, что нового привнесли эти две версии в функционал OpenCV.
Читать дальше →

Долгожданный шаг в сторону сложно структурированных документов (+видео)

Время на прочтение3 мин
Охват и читатели6.5K

image


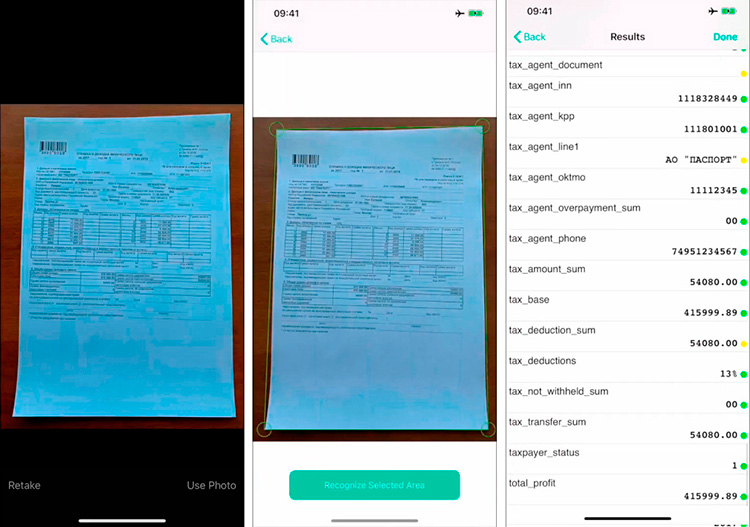
Этой статьей на Хабре мы с большим удовольствием анонсируем вам, друзья, что от шаблонных жестко структурированных документов мы перешли к распознаванию различных сложно структурированных. А это, поверьте, совсем другая песня! За деталями добро пожаловать под кат.

Вижу, значит существую: обзор Deep Learning в Computer Vision (часть 1)

Время на прочтение17 мин
Охват и читатели33K
Компьютерное зрение. Сейчас о нём много говорят, оно много где применяется и внедряется. И как-то давненько на Хабре не выходило обзорных статей по CV, с примерами архитектур и современными задачами. А ведь их очень много, и они правда крутые! Если вам интересно, что сейчас происходит в области Computer Vision не только с точки зрения исследований и статей, но и с точки зрения прикладных задач, то милости прошу под кат. Также статья может стать неплохим введением для тех, кто давно хотел начать разбираться во всём этом, но что-то мешало ;)

image
Читать дальше →