Обновить
256K+

Python *

Высокоуровневый язык программирования

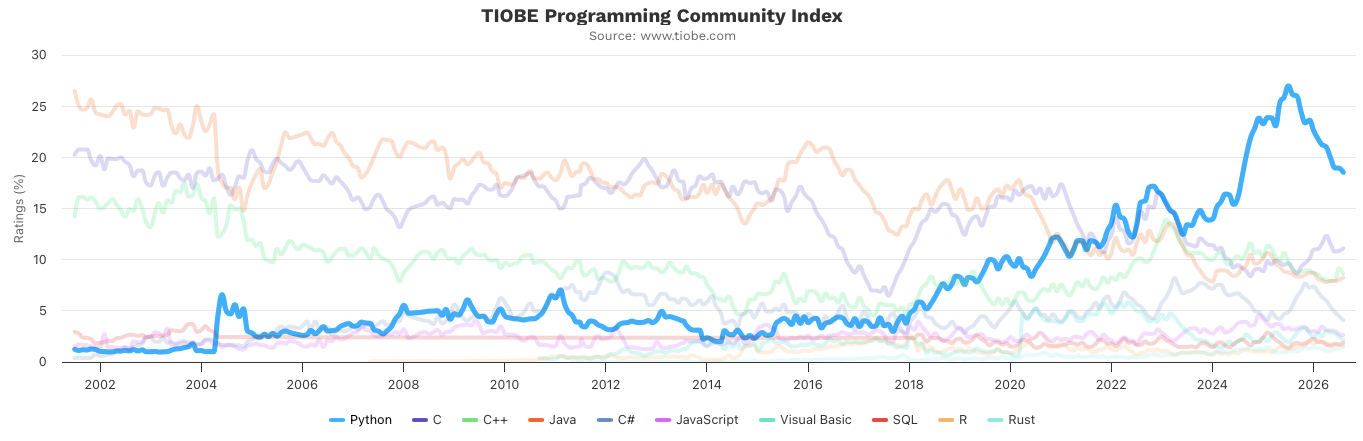
374,01
Рейтинг
Сначала показывать
Порог рейтинга
Уровень сложности
Формат публикации

Разработчик Денис Ширяев представил открытый скилл ex-USSR Kinship Research для Codex и Claude Code, который помогает...

Охват и читатели6.6K

Разработчик Денис Ширяев представил открытый скилл ex-USSR Kinship Research для Codex и Claude Code, который помогает исследовать семейную историю на территории бывшего СССР. Внутри — инструкции по работе с метрическими книгами, военными документами, делами о репрессиях и депортациях. ИИ-агент учитывает старые границы, переименования деревень и варианты фамилий на разных языках. Для каждой находки сохраняет источник, а однофамильцев проверяет по родственникам, датам и даже номерам домов.

Читать дальше →

TG — опенсорсный локальный парсер Телеграма

Уровень сложностиСложный
Время чтения15 мин
Охват и читатели10K

Telegram-parser (github) — это открытый некоммерческий local-first инструмент для выгрузки и аналитики комментариев Telegram-каналов в структурированный, пригодный для анализа датасет прямо на компьютере пользователя, без облачных посредников.

Большинство каналов в Telegram — это не только посты, но и оживлённая «параллельная» жизнь вокруг них в чатах тг-каналов, где агрегируются комментарии к постам, формируются ветки обсуждений с реакциями, стикерами, ответами, упоминаниями, ссылками и мультимедиа. Эта живая активность часто ценнее самого поста — это то, что делает каналы и коммьюнити в Телеграме по-настоящему живыми.

Проблема в том, что Telegram не даёт удобных инструментов, чтобы забрать эти данные одним куском и проанализировать их. Штатный экспорт чатов ограничен, привязан к ручным действиям и не масштабируется на десятки каналов.

Читать далее

Python перезапустил вики‑ресурсы на GitHub Pages

Время чтения2 мин
Охват и читатели6.5K

В феврале 2026 года Python Software Foundation (PSF) перевела вики‑ресурсы PSF, Python и Jython в режим «только для чтения» из‑за автоматизированного трафика и проблем с безопасностью. Теперь новые вики‑ресурсы перезапустили на платформе GitHub Pages.

Читать далее

Обновил файл, а читатель видит старое: сравнение cp, sed -i и os.replace

Время чтения3 мин
Охват и читатели7.3K

Путь к файлу тот же, текст обновился, но процесс с открытым дескриптором продолжает читать старую версию. На небольшом Linux-стенде сравнил cp, sed -i и замену через временный файл: права доступа, inode и поведение читателя.

Читать далее

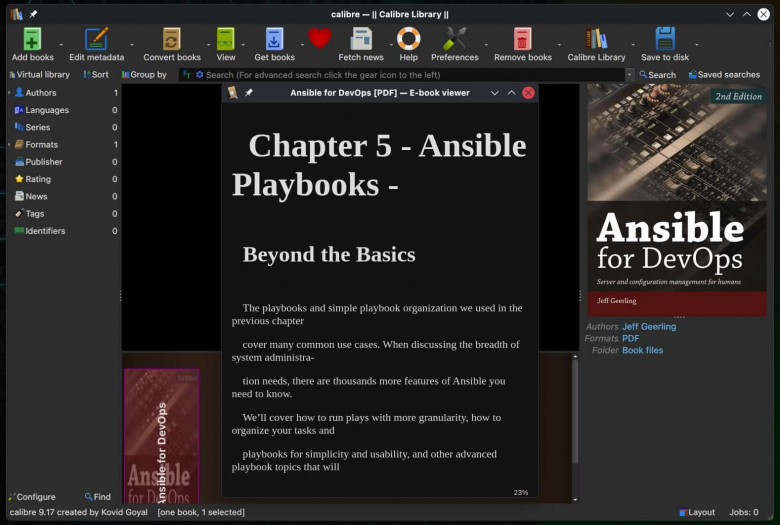
Выпуск обновления открытого проекта для создания и хранения в электронной библиотеке книг разного формата Calibre 9.17

Время чтения3 мин
Охват и читатели7K

23 октября 2026 года состоялся выпуск открытого мультиплатформенного проекта Calibre 9.17. Это программное решение для чтения, создания и хранения в электронной библиотеке электронных книг разного формата. Исходный код проекта написан на Python и C и опубликован на GitHub под лицензией GNU General Public License v3.0. Версия Calibre 7.0 вышла в ноябре 2023 года. Сборка Calibre 8.0 вышла в марте 2025 года. Выпуск Calibre 9.0 случился в конце января 2026 года. Проект находится в разработке более 11 лет.

Читать далее

Почему docker stop ждёт ровно 10 секунд и что при этом теряет Python‑воркер

Уровень сложностиСредний
Время чтения6 мин
Охват и читатели9.7K

Контейнер с Python-воркером останавливается не сразу, а ровно через десять секунд. Docker всё это время ждёт, пока процесс отреагирует на SIGTERM, а тот его не слышит. Разбираю, почему так выходит с PID 1 и shell-скриптом в ENTRYPOINT, чем помогает и чем не помогает init: true, и показываю короткий шаблон asyncio-воркера, который дописывает текущую пачку данных и выходит сам.

Читать далее

Сможет ли ИИ решить физику?

Уровень сложностиСредний
Время чтения5 мин
Охват и читатели12K

Физика написана плохо

Вы когда-нибудь смотрели на формулу и пытались понять, что там написано? Для меня, как для программиста, физическая формула - это полный набор антипаттернов.

Читать далее

Представлен открытый проект FacePlugin (Open Source Face Recognition SDK). который позволяет создать собственный Face...

Охват и читатели6.1K

Представлен открытый проект FacePlugin (Open Source Face Recognition SDK). который позволяет создать собственный Face ID и ставить систему распознавания лиц в своих проектах и приложениях:

Читать дальше →

RAG-бот по материалам эксперта: как я мерил качество поиска и почему гибрид оказался хуже чистого вектора

Уровень сложностиСредний
Время чтения15 мин
Охват и читатели6.1K

Эксперт попросил бота, который отвечает его голосом и только по его собственным материалам: курсам в PDF, расшифровкам видео и записям занятий. Если ответа в материалах нет, бот должен честно отправить человека к живому эксперту, а не придумывать. Я собрал такого бота на Python и Telegram, и больше всего времени ушло не на промпты, а на поиск: на первых же живых вопросах выяснилось, что бот просто не находит нужный материал.

В статье я расскажу, как устроен поиск в этом боте, как я построил стенд для замера (метрики recall@6 и MRR), почему гибридный поиск, который все советуют, у меня проиграл чистому векторному, и что пришлось поменять, когда упёрся в лимиты провайдера эмбеддингов. Заказчик согласился на публикацию только без имён, поэтому эксперт, его материалы и тема здесь не названы, а примеры вопросов в статье придуманы мной и к его текстам отношения не имеют. Код ниже взят из рабочих файлов, лишнее я убрал.

Читать далее

ИИ-помощник для КТ головы

Уровень сложностиПростой
Время чтения8 мин
Охват и читатели8.9K

Исследовательский прототип на бесплатной Tesla T4 в Google Colab. Не медицинское изделие.

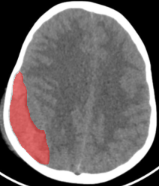
Я обучил нейросеть искать кровоизлияния на КТ головы в бесплатном Google Colab. На первом фолде получил AUC 0.963 и обрадовался. После полной проверки осталось 0.931. А потом выяснилось, что модель, которая видит только костное окно, где мозга почти не видно, всё равно даёт AUC 0.86. В статье разбираю, откуда берутся такие цифры, что показывают маски врачей.

Читать далее

Senpy или зачем визуальной новелле семантический линтер, если в Ren’Py уже есть встроенная проверка?

Уровень сложностиСредний
Время чтения19 мин
Охват и читатели5.5K

Как попытка пофиксить русификатор для мода к DDLC вылилась в разработку собственного семантического анализатора для Ren'Py со скоростью 77 000 строк за 3.8 секунды, собственным ScopeStack, AST-парсером и LSP-сервером для VS Code.

Рассказываю, почему встроенный renpy lint бесполезен на CI, как неочевидные предиктивные рендеры экранов воруют золото у игроков, почему переменные без default гарантированно убивают сохранения после релизных патчей и как защититься от RCE при распаковке чужих .rpa архивов.

Читать далее

Как я собрал русскоязычную GPT на 112 млн параметров с нуля на PyTorch: претрейн, SFT, Telegram-бот

Уровень сложностиСредний
Время чтения9 мин
Охват и читатели9.9K

Когда смотришь на современную LLM, легко решить, что всё сводится к вызову API. Но многие разработчики, которые часто используют LLM в работе или в своих проектах, рано или поздно хотят действительно разобраться, как они работают. К тому же - кто не смотрел «Железного человека»? По сути самый лучший способ реально разобраться это сделать что-то свое. Чаще всего возможности позволяют сделать что-то маленькое, зато свое и работающее.

Так появился jarvis - компактный decoder-only transformer для русского текста и диалогов. В проекте нет готового AutoModelForCausalLM: я сам реализовал архитектуру, обучил токенизатор, собрал пайплайн подготовки данных, добавил претрейн и SFT, KV-cache для генерации, консольный чат, Telegram-бота и простой бенчмарк. Готовый SFT-checkpoint и соответствующий токенизатор опубликованы на Hugging Face.

Читать далее

Свёрточные сети в финансовом анализе: от компьютерного зрения к прогнозированию рынков

Уровень сложностиСложный
Время чтения10 мин
Охват и читатели5.3K

Свёрточные нейросети умеют находить закономерности в данных, но на финансовых рынках легко принять особенности волатильности за сигнал и получить модель, которая хорошо работает только на исторических котировках. Разберём, как применять CNN к временным рядам и данным ордербука, избегать утечки будущего и проверять качество прогнозов, чтобы понять, когда свёрточные архитектуры действительно полезны в финансовом анализе.

Изучить метод

Ближайшие события

HabrExporter: сохраняем статьи и целые блоги Хабра в офлайн

Уровень сложностиПростой
Время чтения12 мин
Охват и читатели7.7K

Салют, Хабр!

Не так давно мне захотелось сохранить себе подборку статей одного автора: несколько десятков публикаций вместе с комментариями (которые зачастую не менее ценны, чем сами статьи). Конечно, будь статья одна, я, не задумываясь, нажал бы Ctrl+S или Ctrl+P. Но жать их полсотни раз — удовольствие сомнительное. Готовые решения нашлись, но меня ни одно не устроило (о них ниже). Поэтому я, как истинный программист, озадачился написанием собственного инструмента. А как истинный ленивый программист — поручил часть этой задачи Claude Code.

Так появился HabrExporter — приложение с графическим интерфейсом и CLI, которое сохраняет статьи, блоги авторов и закладки Хабра в PDF, EPUB, Markdown и ещё нескольких форматах. PDF при этом выглядит точь‑в‑точь как на сайте, вместе с деревом комментариев, а данные программа берёт не парсингом HTML, а из внутреннего API Хабра.

О том, как это устроено, что умеет программа, я и расскажу.

Save as...

Как строить сканирование активов в MaxPatrol VM. Ч.5 — Автоматизация по API. Ч.1 — IP-план, задачи сканирования

Уровень сложностиСредний
Время чтения12 мин
Охват и читатели5.3K

Добрый день, дорогие читатели!

Мы переходим к использованию API MaxPatrol VM по-взрослому.

В прошлой статье мы успешно авторизовались в MPVM, получили нужные для любого API-запроса headers.

Сегодня мы загрузим в MPVM IP-план Организации, создадим задачи по сканированию Пентестом и затронем задачи по Аудиту.

Примеры будут также на Python.

Читать далее

Обзор новых правил безопасности в пакетных индексах и менеджерах за 19–23 октября 2026 года

Время чтения2 мин
Охват и читатели5.1K

pnpm закрыл обход правил запуска сборочных скриптов, uv, Hex и rustup обновили доверенные сертификаты после инцидента eMudhra, а GitHub представил прокси для проверки npm-пакетов до загрузки.

Читать далее

От первого мотора до робота, который учится по демонстрациям: открытая дорожная карта по робототехнике на русском. ...

Охват и читатели3.5K

От первого мотора до робота, который учится по демонстрациям: открытая дорожная карта по робототехнике на русском.

Читать дальше →

Python-разработчик в 2026 году: что учить, чтобы не застрять на одном грейде

Время чтения12 мин
Охват и читатели8.5K

Python знают миллионы разработчиков. Но что сегодня отличает Junior+ от Middle, а Middle от Senior, кроме количества лет в резюме? Собрали актуальную матрицу компетенций для питонистов: от объектной модели и pytest до высоконагруженных систем, Big Data и промышленных решений с LLM.

Читать далее

Книга по Python для школьников и студентов

Уровень сложностиПростой
Время чтения7 мин
Охват и читатели5.4K

В образовании я уже второй десяток и все мои учебные программы создаются самостоятельно. Каждый год я обновляю их новыми алгоритмами, идеями занятий согласно возрастным особенностям учащихся и требований по стандартам как государственным, так и бизнеса. Обучаю математике, программированию и робототехнике, как в рамках школьного и дополнительного образования, затрагивая вузовскую программу, так и в рамках индивидуальных занятий для приобретения человеком тех или иных навыков и знаний в профессиональной деятельности.

Поэтому всегда изучаю вышедшие книги, обновления софта и так далее. Одной из сложных задач является составления интересных учебных программ для школьников, так чтобы они отвечали и ФГОС, и подходу STEAM. Дети лучше понимают академический материал на наглядных примерах, которые дают им либо новый опыт познания мира, либо служат хорошим прикладным инструментом для решения насущных задач.

Книг такого характера можно пересчитать по пальцам, у которых действительно есть связь со школьной программой, условно, от 3 до 11 класса по определённым предметам. В моём случае — это математика, информатика и физика. И вот относительно недавно у меня появилась новая книга, отвечающая заданным критериям, под названием «Азбука Python. Подробный самоучитель для школьников и студентов».

Читать далее

Помнит ли ИИ-агент вчерашний разговор? Проверил: 0 из 10 без памяти, 10 из 10 с ней — и три бага по дороге

Уровень сложностиСредний
Время чтения6 мин
Охват и читатели4.8K

«У нас есть память между окнами» — это мы писали в README и на Хабре. Но ни разу не проверяли, что агент в новом окне действительно вспоминает вчерашнее. Проверил на своей рабочей базе. В новом окне агент без памяти вспомнил 0 фактов из 10, со skillmem — 10 из 10. А пока я добывал цифру для README, нашлись три бага: треть заметок не попадала в базу, пересказы сессий забивали поиск, и агент не доверял правилам, которые я сам ему продиктовал.

Читать далее