Комментарии 2474
'кусочками' научно называется memory mapped files :)
А что значит «но в память приложения данные придётся копировать»?
Upd.: А, всё, я кажется, понял. При read происходит перенос данных в уже выделенную пользователем память. При этом эта память уже контроллируется приложением, т.е. оптимизировать это каким-то ре'map'ингом страниц (или как там ОС это делать может) не выйдет.
И вот это AST во первых весит больше исходника…Кстати, необязательно. Это AST может:
- во-первых, не содержать в себе сами строки, а лишь ссылаться на позиции в исходном файле;
- во-вторых, быть не полностью детализированным (т.е. условно говоря, мы распарсим первую функцию в файле-исходнике полностью на всю глубину, но если она выше екрана, то тут же забудем результат парсинга за исключением её собственно начала и конца (т.е. удалим все узлы глубже узла самой функции), а если она снова попадёт в экран — распарсим заново (т.е. детализируем этот кусочек дерева)).
Memory mapped files — это просто немного удобства для программиста. Под CP/M-80 (в которой ещё не было не то что mmf — банальных file handles) текстовый редактор wordstar спокойно правил файл больше размера оперативки.
Вообще по опыту там дико тормозит подсветка кода, и такая беда не только там.
Я тоже отказался от него в больше части предыдущих операций и перешёл на AkelPad. Он оказался лучше Notepad++.
Для перевода делаю копию файлов. А им нужно иногда конвертирование между форматами (из Unix в Win) и изменение кодировки (последнее можно автоматизировать).
После покупки автором оригинала — огрызкобука, часть файлов он стал сохранять в формате Unix. Изредка он заменяет много файлов, бывают сбои синхронизации и резервного копирования. На самом деле такое редко нужно, но всё же бывало, такое приходилось делать массово.
Да, можно написать конвертер и я писал один (но только для смены кодировки), но он тоже не универсален, тем более учитывая, что иногда файлы для работы нельзя выделить из всей пачки :(.
А ещё, помимо самого скрипта, мне внезапно(!) понадобится интерпретатор — сам perl. Офигенный «скрипт», угу.
А ещё, он делает только одно, довольно редко нужное действие, но не делает второе, самое важное конвертирование — смену кодировки.
А ещё, он делает только одно, довольно редко нужное действие, но не делает второе, самое важное конвертирование — смену кодировки.Смену кодировки делает iconv.
А ещё, помимо самого скрипта, мне внезапно(!) понадобится интерпретатор — сам perl.На любой современной Unix-системе он есть. А откуда у вас возьмутся файлы в Unix-кодировке если у вас нету Unix'а — для меня загадка.
В любом случае если такое происходит не один раз в жизни, то проще поставить CygWin, чем забивать гвозди микроскопом, если один раз — можно и потерпеть пока редактор эти файлы откроет…
В любом случае если такое происходит не один раз в жизни, то проще поставить CygWin, чем забивать гвозди микроскопом
Забивание гвоздей микроскопом — это как раз куча мусора в системе в виде cygwin'ов, перлов и прочей ненужной гадости для решения одной задачи.
Вы второй раз не потрудились прочитать, видимо лозунг — «комментарий не читай, ответ строчи», вам весьма близок?
Ezhyg 24.09.18 в 00:41
После покупки автором оригинала — огрызкобука, часть файлов он стал сохранять в формате Unix
khim 24.09.18 в 04:30
А откуда у вас возьмутся файлы в Unix-кодировке если у вас нету Unix'а — для меня загадка.
Для меня загадка — диагноз, который можно поставить по этой цепочке комментариев.
Вдобавок даже в предыдущем комментарии вы, похоже, так же не потрудились прочитать комментарий на который решились ответить, с как бы «желанием» помочь.
Смену кодировки делает iconv.
Я рад за него, чесслово! Мало того, изредка, даже использую его помощь.
На любой современной Unix-системе он есть.
Не на любой. Но это и не важно, при чём тут юниксы ваще? EditPlus2 — Windows программа, как я могу работать в ней, при этом конвертировать что-то скриптом питона, а затем айконвом? (только не вздумайте мне рассказывать про вторую машину или виртуалки)
В любом случае если такое происходит не один раз в жизни, то проще поставить CygWin, чем забивать гвозди микроскопом, если один раз — можно и потерпеть пока редактор эти файлы откроет…
Да уж… тащить огромный пакетище для мелких разовых вещей — очень по красноглазиковски!
Здесь я согласен с Druu
Если уж вы решили комментировать, то будьте добры, потратьте своё, безусловно бесценное, время и прочитайте уже комментируемое!
Опять же, программисты наверное предполагают, что у вас есть возможность хоть на чем-то написать маленький скрипт. Наверняка, не пытаясь этим вас обидеть.
Ну а айконв, наверное, посоветовали, поскольку вы писали свой велосипед.
Никоим образом не пытаюсь оскорбить ваш разум. Может, я не совсем понял, что он писал и как думал, поэтому заранее прошу у него прощения.
Надеюсь, мой незаангажированый комментарий убедит вас, что вас не хотели обидеть.
Что до сотен файлов открытых в редакторе — то, очень интересное наблюдение. Прям как в том анекдоте, на любую бензопилу, найдется рельса которая её сломает. Интересно, сколько сотен или тысяч файлов повесят редактор окончательно.
Да, так и не понял каким именно вы пользуетесь.
долго пытался понять, автор какого именно оригинала купил огрызок, и почему он, автор, решил сохранять в Юникс-формате.
Автор оригинала (файлов), переводимого мной (слово перевод вам надеюсь понятно?)
Формат Юникс, потому что огрызкобук же, потому что там этот формат вообще-то по умолчанию в его редакторе. А не самого мак-а, потому что его редактор — *никсовый, а не яблочный.
Опять же, программисты наверное предполагают, что у вас есть возможность хоть на чем-то написать маленький скрипт. Наверняка, не пытаясь этим вас обидеть.
…
поскольку вы писали свой велосипед.
Так я и написал. Хотя это не скрипт и уж точно не велосипед! Нормальная команда запуска редактора без гуя (консольно), с параметрами конвертирования из одной кодировки в другую. И я сразу же объяснил, что конвертировать надо «два раза», но нет… начинается снова предложение вначале одного, на перле, потом второго на пхп, да и вообще не под ту ось. Это же клиника!
Что до сотен файлов открытых в редакторе — то, очень интересное наблюдение.
Я же говорю, это бывает нужно редко, ну какие буквы-то незнакомы? :(
Тем более, не важно — отдельно я сконвертирую или вместе, мне же всё равно эти файлы открывать и редактировать.
Всего файлов там около 3800, но ни разу ещё не было чтобы «испортилось» больше пары сотен.
И я описал почему я так же отказался, как и автор комментария, прокомментированного мной.
Раньше использовал EditPlus2 (не помню, почему отказался частично)
0xd34df00d в репах есть:
безазотистые вещества (6,5 %), азотистые вещества (1,1 %), жиры (0,2 %), минеральные соли (в нём очень большое содержание кальция), витамины (А — 0,04 мг, С — 8—20 мг, B1 — 0,08—0,11 мг), значительное количество сахаров и витамина PP. Богата янтарной кислотой.
Никаких dos2unix там нет! Это ген такой или вещество?
Какая разница какой фон под символом?
Красный, белый или зилёный?
Почему белый фон под символом рендерится за 10мс, а красный фон за 100мс?))) Цыфры условные.
Вы вообще понимаете, что разницы в принципе нет никакой? И не должно быть.
Разница получается в таких вот поделиях исключительно потому, что поделие сделано из говна и палок. Подсветку прикручивают не на том уровне абстракций. Всего навсего…
Вы еще скажите, что отрисовка процессором символа с фоном медленней, чем определение того какой под символом фон нужен.
У вас решение какое-то дичайшее.
Вы говорите что парсить строчьку дороже, чем символ с красным фоном рисовать.
ВЫ ОБЪЯСНИТЕСЬ ХОТЯ БЫ КАК-ТО??? Как такое может быть вообще?
Или вы что не понимаете, что вы люто бредите??
А вообще мне кажется, Вы с VolCh о разных вещах говорите. Вы — о времени выполнения, а он — о времени разработки.
У вас строка бывает длиной в несколько мегабайт? И зачем подсвечивать эту строчку длиной в мегабайт?
Вы про какой парсинг сейчас говорите?
Давайте разбираться. Парсинг всего документа целиком — это одно. И да, совершенно прав человек, когда пишет, что если начало комментария 900 строчками выше, то надо парсить весь документ. Так символ комментария может быть не только на 900 строк выше, а выше еще и на 1800-ой строке. Комментарий кто-то попытался сделать вложенным например. И не надо говорить что где-то это запрещено, а где-то разрешено, и где-то документ будет валидным, а где-то нет. Суть не в этом. Парсить ДОКУМЕНТ в любом случае нужно. Но я не про парсинг документа) Я про парсинг строки. Т.е. где в строке подсветить символы. Я про графику. И только. Т.е. есть строка, уже распарсенная. Так вот вам в этой строке нужно подсветить исходя из распарсенного — символы 10,11,12, 34,35,36 и т.д. Вот это и тормозит. А тормозить не должно никак. Имея именно распарсенный документ любой, т.е. абсолютно любой — тормозит именно подсветка символов. Это же увидеть абсолютно легко. Берете документ на 10кб и на 10мб — подсветка тормозит в обоих случаях. И тормозит именно определение того, где какой символ подкрасить, т.е. фон поменять. А фон меняют через лютые костыли зачем-то. Вот это и тормозит больше всего.
Выходит так, что тормозит не парсинг документа, а графика. Это как с курсором выжирающим ядро. Типа того.
Рисовать буквы одним цветом, цифры другим, прочие символы третьим — элементарно и почти ничего не стоит. Подсветка ключевых слов, строк, комментариев — уже зависит от синтаксиса языка. Выделить имена классов, элементы перечислений, парные скобки — нужен полноценный парсер. Неиспользуемые параметры? Неинициализированные переменные? Теперь рисование разноцветных символов требует транслятора с анализом dataflow…
Во втором случае понадобится всего несколько строчек кода, а в первом месяцы или даже годы работы (если делать в одиночку, придумать кучу всяких тем, поддержать 100 языков программирования, для каждого из которых нужен синтаксический анализатор, сделать всё оптимайзно, красиво в архитектурном плане и т. д.).
Так вот, Notepad++ решил пойти по странному пути. Потратить годы работы на подсветку синтаксиса — это ок, а потратить 5 минут времени на Tab indent space align — не ок, хотя эти две фичи одинаково важны.
Если отключить из редактора intellisence, подсветку синтаксиса, то вероятнее он откроется быстрее. Тот же sublime, если автоматом не поставит подсветку синтаксиса, то может открывать файлы в разы больше чем с подсветкой. Хотя Vim например и с подсветкой открывает достаточно шустро.
1. подсветка. У многих она тормозит. У некоторых — безбожно.
2. Весь файл в одну строку. Такая подстава многие редакторы ставит на колени. Как пример: PSPad с подсветкой справляется, а вот с однострочниками нет. Более того, там даже прокрутка будет безбожно тормозить (если вкл автоматический перенос)
- Написал бы, но я работаю с другими языками программирования.
- Это странно, для такой базовой функциональности писать плагин. Давайте ещё напишем плагин нажатия клавиши Enter, чтобы перенести курсор на следующую строку, предваритально создав её, потом напишем плагин для стрелок — а чё, хочешь перемещаться по коду, ставь плагин! и т. д.
- У notepad++ есть какие-то баги с плагинами — не сохраняются настройки.
- Но конечно же всегда можно сделать Pull Request! Но даже если бы я писал на этом языке, то не знаю, стал ли бы я делать. Потому что когда языки совпадали, я пулл реквестил аж в 5 проектов. В двух из них авторы до сих пор рассматривают их уже 2 года (хотя перед pull request'ом я с ними общался, они были не против изменений). Казалось бы, всё готово, им нужно только одну кнопку нажать и смержить изменения, но нет. В одном проекте исправил ошибку, но pull request тупо отклонили, сказав, что не хотим мы ваших исправлений. И только в двух проектах pull request'ы без проблем приняли.
Выяснять отношения и годами просить принять pull request поднадоедает. Хочется просто взять, реализовать фичу, и всё, а не заниматься не пойми чем. Хочется заниматься именно программированием.
- вы перемещаетесь по коду стрелочками
- «Выучить новый язык программирования» на уровне написания плагина непосильная задача
да практически герой статьи в топике.
И самое главное — ради чего? Ради того, чтобы следующий человек пришёл и сказал «А где tab indent space alignment?»? Ну да, наверное, найдёт плагин в гугле. По факту плагин уже есть давно. Но работает плохо. +В Notepad++ не сохраняются настройки плагинов.
Ну сделай ты подсветку синтаксиса отдельными потоком, чтобы не мешать пользователю пользоваться твоей программой.
Сперва разработчики для iOS догадались (ОК, их заставили) переносить тяжёлые и долгие операции в фоновые потоки.
За ними подтянулись разработчики для Android.
А на десктопах всё так же по старинке всё одним потоком, последовательно — если у пользователя комп тормозит, то пусть купит себе новый, ага.
За это мы их и любим.
Но очень многие разработчики ожидают, что их творения будут работать в идеальных условиях, на быстрых процессорах, с достаточным количеством памяти, с быстрой и всегда доступной сетью и т.п.
Первое еще можно понять — сисадмин по своей лени выдал разработчику полные права для изменения либ и прочего, вот последний так же ленится релогаться туда-обратно и пишет под админом. Ваше право, возьмите да укажите в требованиях к установке полные права. Нееет, мы умолчим о том, что разработка у нас через одно место, а юзер пусть грешит на себя — то ли комп глючит, то ли ОС криво встала… Из последнего — надстройка Overwolf для TeamSpeak3: под юзером запускалась, все рисовала, но не коннектилась к ей же запущенному TS3.
Порой доходит до абсурда — пользовался плагином EveryHTTPS, и на одном из сайтов сертификат был выдан на айпишник локалхоста, то есть у админа всё работало…
Чтобы делать что-то в отдельном потоке — нужны на порядок более квалифицированные разработчики. Без этого ловим глюки и тормоза (потоки ждут друг друга — не раз наблюдал, как в несколько потоков оказывается медленннее, чем в 1).
нужны на порядок более квалифицированные разработчики.
Что значит «на порядок более квалифицированные»? Человек, если вообще способен быть программистом, способен и освоить многопоточность. Многопоточность может потребовать больше внимательности и времени на проектирование, но для её использования не нужно какое-то профессиональное просветление. Это такой же обязательный навык для любого программиста (кроме тех, кто пожизненно связался с какой-то принципиально однопоточной платформой), как и умение делать циклы. Просто проходится на чуть более поздних лекциях.
Конечно, сейчас есть методы, позволяющие кардинально уменьшить сложность многопоточного кода (например, делать все данные либо локальными, либо immutable — вроде современные языки даже научились жёстко устанавливать это ограничение), но всё равно сложности хватает.
у синтаксиса своя копия отрисока с ней сверяется по необходимости и мы имеем примерно удвоенное потребление памяти.
С одной стороны, да. С другой стороны, я помню, как четверть века назад притормаживала подсветка синтаксиса в Turbo Pascal 7 на компьютере «Поиск 1.04». Было примерно как сейчас у меня в браузере при комментировании этой ветки. Лагало, неприятно было, но работать было можно.
Checkit показывал, что быстродействие того «Поиска» было на уровне 0,5 от IBM PC XT (там был 16-битный проц на 5МГц, 608К ОЗУ, и программная эмуляция видеоадаптера IBM CGA). И там подтормаживала подсветка синтаксиса. Блин, но я никак не могу понять, почему она в некоторых IDE подтормаживает сейчас, на восьми 64-битных суперскаляных ядрах по 4ГГц каждое.
любопытно за счет чего
Напомнило, как я в своё время всадил фееричную багу.
После нескольких часов работы программа начинала тормозить. Причина: в ней было отладочное окошко с текстбоксом лога, в который я при обработке очередного блока данных добавлял точку (что-то тип dbgForm.textboxLog.Text.Append(".") — дело было на дельфях). Что с каждой точкой оказывалось всё медленней...
Это драйвер, т.е. критичный к производительности код. Для мобильных устройств. От Qualcomm.
Да возможно все гораздо проще — исходно надо было сортировать небольшой массив или его часть, сделали пузырек, потом требования изменились и оказалось, что нужен только один элемент, а пузырек остался, т.к. не стали все переделывать.
Почему-то многие забывают, что код не всегда пишется оп и сразу, зачастую он не раз рефакторится, прежде чем дойти до продакшена.
То ли в 2014, то ли в 2015 у нас налоговая приняла законы, по которым XML-ины электронной отчётности по размеру стали допустимы до 10гб (вроде бы с изначального «копеечного» лимита 10-100мб), так все решения на DOM'ах очень красиво посыпались, когда пошли клиенты с громадными «контролируемыми сделками» и «книгами для ндс». Потому что DOM одной только памяти жрёт х10 от размера файла, и если раньше (100мб-1гб) на это закрывались глаза, то на 100гб глаза уже не закроешь, не говоря уже о платформе х86.
Делал в те времена в системе электронной отчётности проект по уходу с DOM (легаси было крепко на него завязано, XPath и прочие плюшки активно использовались) на SAX в один пробег, с «эмуляцией» плюшек или обоснованным отказом от них — веселья было много. Теперь в резюме указываю тег XML, а на собеседованиях периодически посмеиваются, мол, что там знать-то, древовидная структура, теги/атрибуты и всё. Так-то оно да, но, как и в физическом мире, когда масса объекта пересекает определённые границы, проявляется много интересных эффектов, о которых даже не думаешь, щупая маленькие объекты.
Парсер просто выдаёт ленивое дерево нод
А как парсер сможет выдать дерево нод (не важно лениво или нет), не зная структуры документа?
Вообще по такой логике можно любую задачу решить за О(1) — объявить что ф-я, которая делает то, что нужно, ленивая, и не запускается, т.к. оказывается не нужна.
В итоге можно мгновенно решать np-задачи.
Есть док, у которого в самом начале ссылка на картинку с обложкой, которая лежит в конце. Когда клиент захочет сразу же отобразить обложку (ну он же работает с dom и уверен, что она уже загружена) вы предлагаете:
1. загрузить весь документ до обложки и работать как с обычным dom?
2. дропнуть всё до обложки а потом начать парсить сначала, когда клиент продолжит читать документ с начала первой главы?
3. ???
Когда клиент захочет сразу же отобразить обложку (ну он же работает с dom и уверен, что она уже загружена)Даже если она уже загружена — поиск в нём долог и дорог. И да, сложить две строки — это тоже дорого и сложно. Как и выделить подстроку. И как изменить регистр. И как многое другое. Лучше всего про эту банальность (как и почти любую другую банальности) описал Джоел…
Если вы будете помнить, о том, что поиск в DOM — это дорого и долго, то у вас всё будет работать быстро и с DOM'ом и, чуть медленнее (но со значительной экономией памяти) — с «ленивым» DOM'ом. Если же вы будете считать, что складывать строки легко и быстро — то вам, извините, никакие абстракции не помогут. Скорее помешают.
У меня есть ощущение, что вина всему — то, что начинающие программисты больше не начинают с Бейсика на C64. Когда вы писали на языке, который был в 100-500 раз медленнее (не в 100500, а в 100-500 — это довольно точная оценка), чем тот же алгоритм в машинных кодах и при этом процессор у вас был частотой 1 (один) мегагерц… то увидеть, что операции со строками — таки медленные можно было почти что невооружённым глазом. А сейчас — сеньор-программисты об этом не подозревают… а абстракции… абстракции могут быть любыми — важно только не забывать, что все они — дырявые…
А если вы работаете проходами, то на кой чёрт вам dom, если всё равно алгоритм работы полностью меняется. IMHO ленивый dom имеет смысл только при простой последовательной обработке, когда очень лень эту обработку писать. Да и то по факту сильно проще там не станет.
Это всё хорошо, когда вы пишите редактор xml или сериализацию один-в-один. Но когда данные в памяти не соответствуют структуре файла (а обычно так и бывает) — их всё равно придётся преобразовывать. И когда это делать разницы нет. Хоть при обработке потока xml, хоть выгребая из дерева. Но первое быстрее и требует меньше памяти.
А вот работающие с dom такими вопросами обычно не заморачиваются, т.к. по идее всё дерево доступно полностью сразу.Никогда оно не бывает «доступно всё сразу». если всем известные числа вспомнить, то легко понять, что переход к следующему элементу — это что-то типа 0.5 нс (обращение к кешу L1), у куда-то «вдаль» — что-то типа 100 нс. Разница — два порядка. И да, это в полностью распарсенном и загруженном дереве.
Особенно с учётом того, что на загрузку там тратится на много порядков больше времени, чем на доступ.Ой ли? А если прикинуть? Если доступ к памяти занимает 100 наносекунд, то на 10Гбит/с канале вы за это время загрузите 120 байт. То есть «много порядков» у вас будет только если ссылки из одного места в другое случаются пару раз в файле на мегабайт. Иначе — эти величины очень даже могут быть сравнимы.
Собственно те самые числа «должен знать каждый» именно потому что часто вещи, которые «на много порядков больше времени» занимают вовсе не так много, как вам кажется — и соотвественно «очень простые и быстрые» вещи часто оказываются вовсе не такими «простыми и быстрыми»…
Ну не считая случаев, когда загрузка засрёт всю память и мы будем работать со свопом.А почему, собственно? Если у вас система на SSD, то обращение к своп-файлу вполне может происходить на скоростях в несколько гигабайт в секунду… а вот если нужен произвольный доступ — то там числа совсем-совсем другие, конечно…
Это к обработке уже не относится.А у чему это, я извиняюсь, относится? Если вам дадут XL-файл гиг на 10 — что вы ним будете делать?
100 наносекунд, то на 10Гбит/с канале вы за это время загрузите 120 байт.
Да нифига вы за это время не загрузите. На один TCP-handshake куда больше времени уйдет.
Иначе — эти величины очень даже могут быть сравнимы.В сферических условиях в вакууме всё может быть. В общем случае на больших файлах разница будет и приличная
А почему, собственно? Если у вас система на SSD, то обращение к своп-файлу вполне может происходить на скоростях в несколько гигабайт в секунду… а вот если нужен произвольный доступ — то там числа совсем-совсем другие, конечно…В основном потому, что изначально задача была в частности «не засрать всю память». А если это неизбежно — то не полагаться, что программа всегда будет работать на машине с топовым ссд неограниченного размера или как минимум с 128Гб оперативки.
Вот мы плавно и вернулись к началу этого разговора, когда вместо нормального проектирования разработчик полагается на то, что железо всё вытянет.
А у чему это, я извиняюсь, относится? Если вам дадут XL-файл гиг на 10 — что вы ним будете делать?Для начала я выясню, что, собственно с этим файлом требуется сделать. И если нет задачи написать клон excel — обычно требуется лишь загрузка из него значений, для чего пихать весь файл в память нет совершенно никакой необходимости.
Если вдруг имелся всё-таки XML файл, то тем более. SAX-парсеру размеры файла совершенно не важны.
Время есть время. Тот п#зд$ц, который мы тут наблюдаем в Хроме вот на этой самой странице с вероятностью 99% связан с тем, что кто-то исходил из логики: на загрузку там тратится на много порядков больше времени, чем на доступ… но применение этой логики достаточное число раз привело к тому, что… имеем то, что имеем то, что имеем: Chrome 54 — работает быстро, а «ускоренный» Chrome 69-70… вот так, как он работает…Если доступ к памяти занимает 100 наносекунд, то на 10Гбит/с канале вы за это время загрузите 120 байт.Это сравнение апельсинов с бегемотами. Сравнивать задержку доступа с устоявшейся скоростью передачи несколько странно.
А если произвольный доступ не нужен, то можно снова лениво стримить всё дерево в DFS-порядке, и мы вернулись в начало.Не совсем. На SSD «ленивое» построение дерева приведёт, скорее всего, к ускорению. В оперативке — вряд ли. Но в случае, если человек считает, что произвольный доступ не стоит ничего и не учитывает того, что он, в общем-то, не так далёк от скорости работы сети… не поможет ничего!
А зачем парсеру знать структуру? Парсер — это синтаксис, структура — это семантика конкретных элементов.
Парсер же возвращает АСТ (ну, условно, в общем АСТ может быть произвольным графом, а не деревом)? АСТ — это и есть структура документа, разве нет?
Внутренние ссылки, перекрёстные, циклические, рекурсивные и т. п. уже не относятся, как по мне, к синтаксическому разбору, это уже дальше этап разбора дерева.
В лиспе АСТ является произвольным графом.
Штука в том, что ридер-макросы не являются токенами, и в них вы можете производить произвольного вида вычисления. Например — взять кусок АСТ и замкнуть его самого на себя:
для
#1=(yoba . #1#)
получится бесконечный АСТ '(yoba yoba yoba yoba yoba ....)
можно сделать такой цикличный АСТ, отдать на евал и он повиснет, например, ну или построить граф любого вида.
С чего вы взяли что оно ему надо было?
Он же не полную реализацию стандарта заваял. Полная реализация вообще никому не нужна, никогда.
Человек отбросил лишнее, и алгоритмически оно у него полетело. При этом совместимость осталась.
В чем собственно проблема?
А проблема в том, что стремятся создать универсальную библиотеку, а это полная чушь. Потому что даже математически это невозможно. Если вы разгоняете что-то, то что-то просядет в другом месте.
В идеале же одна универсальная библиотека пусть будет, я не против, собрать проект не вдаваясь в подробности нужно быстро. Но для случаев кода дом не нужен полностью, должны быть другие реализации. И их должно быть много. Выбираете под себя вам нужную, т.е. ту которая максимально заточена под вашу конкретную задачу, а не ворох, а остальное там вообще не должно быть реализовано, ну потому что не нужно оно.
И кто так делает?) Никто. Потому что мозгов нет совершенно.
И поможет ли оно? Нет) Потому что нужно понимать из вороха узкозаточенных реализаций что они могут. А значит нужно все равно глубоко знать реализации. Так таких людей опять нет)
В итоге — вменяемых реализаций нет. Людей понимающих реализации тоже нет.
Что остается в сухом остатке, впрочем на самом деле в жидком? Правильно: только гавно.
Но для случаев кода дом не нужен полностью, должны быть другие реализации. И их должно быть много.
Так а почему вы их еще не написали? Идите и пишите, вместо того чтобы в комментах говно обсуждать.
Или снимаешь галочку отображения списка клиентов в виндовом DC клиенте и получаешь тот же результат. При количестве пользователей в десятки тысяч этот список все равно смысла не имеет. Это не местечковый хаб с чатиком из начала 2000х, не нужен там этот список, там большая часть не люди, а приставки к ТВ.
Я ещё и чат отключал. Запуск приложения и подключение к хабу — секунда, ну может две.
9x до самого своего упора, до ME, была допиленной 95 виндой на которую в 98 накатили IE4… да и закопали её потому что «переписывать» было себе дороже
Именно так. Лично мне пришлось пару лет назад купить новый телефон, потому, что полностью устраивающий меня galaxy s2 открывал сообщение в скайпе за 30 секунд. К слову, прямо сейчас при наборе этого сообщения и пришедший ему на смену s6 подтормаживает. Неужто разрабы хабра тоже вирусом поражены?
1. Нажмите на этой странице Ctrl+U
2. Нажмите Ctrl+A на открывшейся вкладке
3. Кликните по выделенному тексту правой кнопкой мыши в любом месте
4. <>
5. <>
6. <>
7. Снимайте процесс, если надоело ждать.
Прошло полгода — спустя минуту исходный код страницы так и не открылся...
Вивальди 2.5.1525.43 (64-bit)
Примерно так же. Единственно, исходник открывал почти минуту, зато открыл сразу полный текст.
Palemoon 28.5 x64
Конкретные лаги и фризы, до десяти секунд, на протяжении всех пяти минут проверки. Исходный код открыл очень быстро, секунд за десять, но догружал до полного все ту же минуту.
IE11 приятно поразил почти полным отсутствием лагов при прокрутке после загрузки страницы. Но дальше…
Дальше начались сначала фризы при вызове контекстного меню, потом попытку открыть исходный код после пятиминутного ожидания пришлось прерывать снятием задачи в таскменеджере, потом и окно браузера со страницей пришлось убивать через таскменеджер, поскольку никакой вменяемой реакции добиться уже не получалось.
Вердикт: за Palemoon обидно.
Страница
UPD. Отправился коммент мгновенно, а вот полное обновление заняло таки двадцать две секунды.
UPD2 — но лагов не было никаких. Десктоп, седьмая винда, 8 гигов оперативки и i5-2320.
Вот тот же Web. Да, если каждый раз с нуля переписывать все эти библиотеки и фреймворки, то конечно. Только нужны ли они на 99% сайтов? Веб — это информация, текст, таблицы, картинки. Для этого всего вообще не нужен ни js, ни всякие библиотеки/фреймворки. уберите бессмысленное и бесполезное украшательство — и веб начнет летать на самых убогих компьютерах.
А там, где они нужны, как правило, хватило бы ресурсов и для написания «с нуля». Но незачем, ибо пипл и так хавает.
По словам разработчиков, процесс ухода с jQuery занял годы.
Кто за это платит? По своему желанию переделываются только пет-проекты.
В случае больших проектов, переделать все это далеко не копейки.
Забавно, что даже при редактировании файла на Github.com страница весит
лишь 1.63 MB (а там ведь подсветка кода, AJAX-запросы, живой поиск, предпросмотр, и другие полезные функции).
«Вы ничего не понимаете, веб-программирование — это крайне очень супер сложно и вообще сперва добейся (закончи месячные курсы фулл-стека на пайтоне)».
Ну и конкретно на facebook большинство запросов это статика. Как прикажите картинки то грузить?
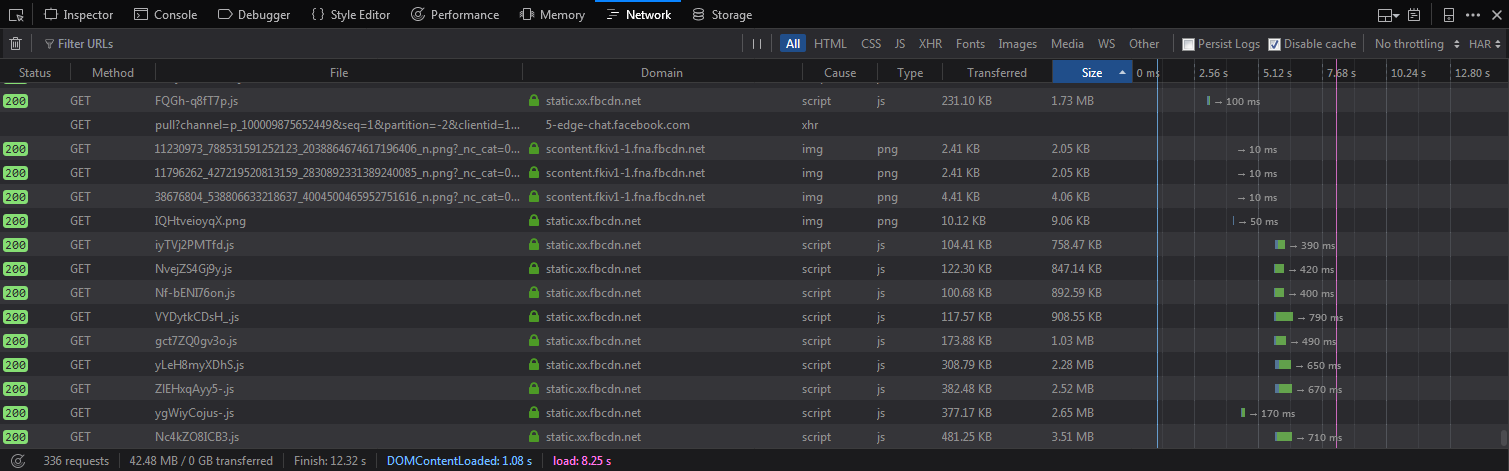
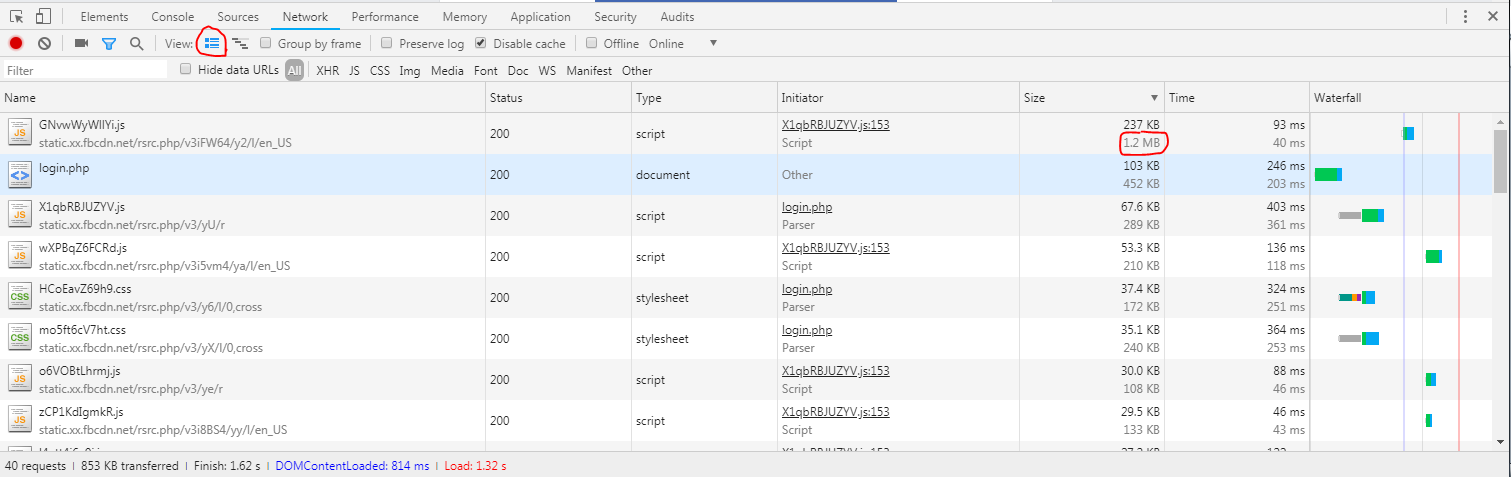
Насчёт аналитики — даже Google Analytics и Яндекс.Метрика с Вебвизором вместе взятых не занимают больше 250 KB. Тут проблема не в аналитике, а в том, что разработчики банально не используют условные загрузки. По моему мнению, незачем загружать стили/скрипты комментариев, чата, списка друзей, редактирование профиля и других функций недоступны неавторизованных пользователей. Но, возможно это лишь мои иллюзии, ведь я не работал в крупных корпорациях.

А то, что там после загрузки еще больше, ни о чем не говорит. Вполне вероятно, что на странице логика грузятся только те библиотеки, которые делают изначальное отображение интерфейса и общие для всех пользователей. А после авторизации уже происходит фактические наполнение данными, но пользователь сразу видит уже какой-то каркас интерфейса.
К сожалению, сам на мобильном интернете очень многих постов и картинок просто не увидел — тупо не дождался их загрузки, дольше 10 секунд загрузки — это уже бесполезная трата времени и вещь уходит куда-то далеко в бесконечную ленту событий, возврат к которой в будущем маловероятен.
Вы предполагаете, что разработчики заранее кэшируют данные, а я не думаю, что они отличаются от тех, кто подключают jQuery на всех страницах сайтах, когда данная библиотека будет использована только на странице контактов, и то, чтобы анимировать одну кнопку, если пользователь открыл страницу 29 февраля в полночь. Во-первых, если бы они заботились об активных пользователях, они бы использовали условные загрузки по крайне мере после авторизации. Во-вторых, они подключают мегабайтные скрипты на всех страницах. В-третьих, пару мегабайт до авторизации лишь «цветочки» по сравнению, с тем, что происходит после. Если бы Вы проверили Вашу «теорию» о кэшировании, то заметили бы, что после авторизации сайт совсем «не летает», даже если все скрипты загружаются из кэша. Он и не будет, ведь это не SPA, и мегабайтные скрипты выполняются каждый раз, когда пользователь переходит на другую страницу.
Facebook и Twitter лишь примеры, но они далеко не единственные кто не допускают, что пользователь не будет использовать даже 10% функционала. Посмотрите, сколько ненужных стилей, скриптов и медиа файлов загружаются на веб-сайтах; какие права требуют простые приложения; какие спецэффекты используются, дабы рассказать какие «мы современные»; сколько шрифтов подключаются лишь, чтобы «показать красивое название сайта». Практически все с каждым днём «улучшают» свои программы и сайты, но, к сожалению, это происходит только в пресс-релизах.
Напоследок, хотелось бы напомнить, что даже js-файл размером в 1 MB это довольно много для сайта, где пользователи пишут и читают обычные посты. И, тем не менее, Вы хотите оправдать разработчиков, которые подключают десятки мегабайт JavaScript. Боюсь, я не могу согласиться с Вами, поэтому, прошу Вас, не вздумайте переходить на сторону зла!
Еще напомню, что эта компания стоит сотни миллиардов и каждый день ее сервисом пользуется больше миллиарда человек и этого бы не было, если бы они разгильдяйски относились к таким важным элементам, как главная страница сайта.
С вашей стороны очень самонадеянно считать что вы знаете лучше, как надо делать и что решение сделать именно такой механизм работы страницы авторизации у Фейсбука продиктован ленью или некомпетентностью разработчиков.
У них есть огромное количество данных о том, что происходит на сервисе на каждом этапе его работы, данные о сотнях миллионах пользователей (если говорить о веб версии). Равно как и есть возможность протестировать и сравнить множество альтернативных вариантов.
Догрузить пару мегабайт библиотек в фоновом режиме, пока юзер вводит логин и пароль, чтобы после авторизации интерфейс с базовом виде прорисовался как можно быстрее — вполне здравое решение.
Единственный сценарий, при котором такой подход может навредить, это если посетитель не будет авторизироваться, а просто зайдет на страницу. В этом случае загрузятся лишние мегабайты.
Но сервис вполне логично ставит интересы таких посетителей ниже тех, кто авторизацию пройдет.
Еще напомню, что эта компания стоит сотни миллиардов и каждый день ее сервисом пользуется больше миллиарда человек и этого бы не было, если бы они разгильдяйски относились к таким важным элементам, как главная страница сайта.
Наивное утверждение. Сервис настолько огромен и популярен, что у существующих пользователей просто-напросто нет выбора (нет аналогов, куда перейти, ведь все друзья в сидят в фейсбуке). А с новыми пользователями то же самое — в мелкую соцсеть типа MySpace идти нет смысла, так как там почти никого нет.
А если вы почитаете, что люди пишут про скорость работы (что веб версии, что мобильного приложения в том же Google Play), то вы увидите, что негативных отзывов гораздо больше, чем позитивных (я правда читал только русскоязычные комментарии, но можно начать хотя бы с России как частного случая). Вы только вспомните: мобильное приложение фейсбука стало настолько тяжёлым, что из него выпилили мессенджер и выпустили отдельным приложением! А потом ещё выпустили Facebook Lite, к слову…
Действительно, сверхпопулярные компании могут позволить себе очень многое. И если они изначально работают над привлечением новых пользователей, то став популярными, чаще всего в первую очередь они думают, как извлечь максимальную прибыль. Как монополисты они уверены, что пользователи никуда не убегут, а значит, они могут творить любую дичь. Правда, некоторые из них (например, IE, ICQ, MySpace, Yahoo) поплатились за это.
Дорога ложка к обеду. Очень хороший пример тут — OS/2 и Windows. Когда в 1992м вышла OS/2, которая требовала 8MB, а на 4MB еле «шевелилась», то народ выбрал вышедшую тогда же Windows 3.1, которая сносно работала на 1MB, а на 2MB «летала». IBM вложила кучу ресурсов и в 1994м выпустил OS/2 Warp, которая более-менее работала на 2MB, а на 4MB — так вообще хорошо. Про неё начали потихоньку говорить, но через полгода — вышла Windows 95, которая требовала уже 4MB, а для приличной работы — 8MB… казалось бы должен был быть провал? Но нет: за 3 года ситуация с памятью изменилась и те 8MB, которые в 1992м казались чем-то запредельным в 1995м уже перешли в категорию «дорого, но терпимо»… а зато у Windows95 была куча программ, которых у OS/2 не было…
Я напомню, что Фейсбук непосредственно заинтересован, чтобы им пользовалось как можно больше людей и не будет специально делать так, чтобы ухудшить динамику регистраций или логинов.
Еще напомню, что эта компания стоит сотни миллиардов и каждый день ее сервисом пользуется больше миллиарда человек и этого бы не было, если бы они разгильдяйски относились к таким важным элементам, как главная страница сайта.
Я не встречал ни одного человека, который бы сказал что ему нравится дизайн и функциональность фейсбука. Ни в России, ни в Европе. Пользуются им все просто потому что им уже пользуются все и чтобы с него уйти нужно, во-первых, найти куда, а так как все пользуются ФБ, то адекватно развитого ничего и нет, во-вторых, переманить туда всех нужных знакомых, что тоже титанический труд, человеку проще ничего не менять и плеваться чем напрягать мозг и совершать какие-то действия, а в-третьих, нужно придумать что делать с новыми знакомыми и всякими группами которые тоже будут по умолчанию в ФБ. Так что пока этим поделием в принципе можно будет пользоваться — им будут пользоваться все. Это никак не говорит о том что они знают что делают. Более того я знаю больше одного человека, которые из-за всего этого бреда в ФБ отказались от него несмотря на все перечисленные пункты.


Это подмена понятий, ваш изначальный комментарий негодовал о:
почему, например, когда я открываю Facebook.com как неавторизованный пользователь, страница занимает 6.16 MB и браузер отправляет 65 запросов
Вам эти данные приходят в сжатом виде и весят никак не 6 с лишним мегов.
1МБ нa страничку, учитывая шрифты/иконки/картинки — это более менее.
Нa мобильной версии приходит около 300кб нa всю страницу.
Так что не сгущайте краски.
Цифра в 6 мегабайт не характеризует ничего, в отличие от сжатого размера, который реально передавался по каналу пользователю.
Это нет так. Реальную память занимает *результат* исполнения кода, а не исходный текст. Короткий код может легко занять много памяти, достаточно насоздавать много объектов в цикле.
Еще как сложно! Там могут быть оптимизации, ленивые вычисления, которые сэкономят память.
Гадать о производительности кода по его размеру — такое себе занятие. Именно поэтому размер сжатого кода еще имеет какое-то значение, то разжатого – цифра ни с чем ни связанная.
Вы думаете, что все пользователи получают данные в сжатом виде?
У 99% браузеры поддерживают сжатие.
Или, что сжатие даётся пользователям даром
Да, почти даром.
мегабайты хлама никак не влияют на производительность
Вот это ужe под вопросом. Возможно, как написали выше, они грузят что-то заранее, чтобы потом нe «лагало» и нe погружало ничего.
Например, у меня в телефоне браузер крашится, если веб-страница пытается съесть больше 12-13 мегабайт
Он крашится если вкладка загружает больше 13 мегабайт? Чего? Диска или памяти?
Одни фотки сейчас весят по 2-3, если не больше. Может вам надо обновить телефон?
Краш скорее всего был по оперативной памяти. Наверное, не на 15 мегабайтах, а на 40-50 (это вроде предел для одного приложения в Андроид 2.3), при доступных 150 мегебайтах всего на все приложения в сумме. Это число я написал по ошибке, перепутал с размером кэша после вылета.
Видимо, посчитали что лучше пусть у тех, кто просто открыл и не авторизировался, делались лишние запросы, чем заставлять дополнительно ждать загрузки тех, кто таки авторизировался с этой страницы.

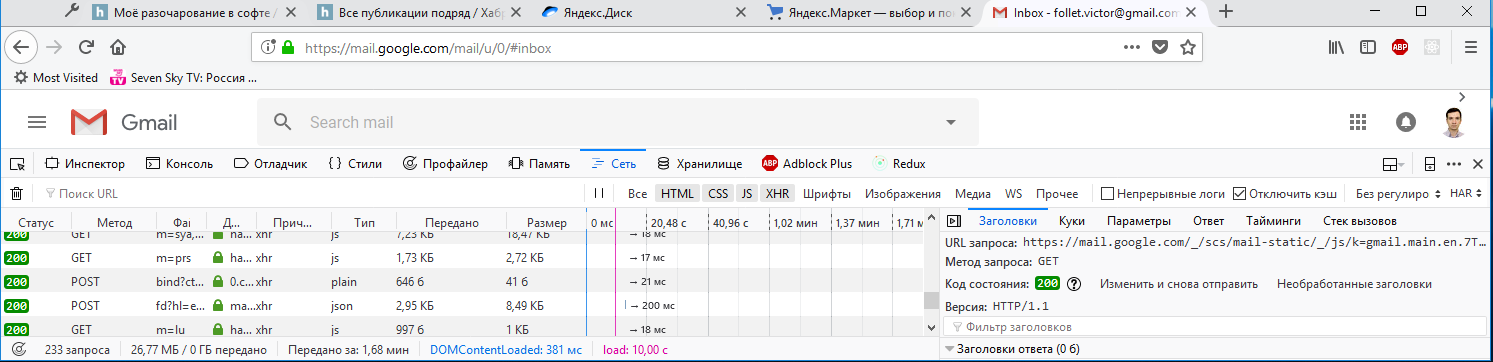
На пике первая загрузка гмейла в последней лисе.
То есть полифил на 20MiB(!).
Но ведь это не вина гугла, что в Firefox не реализовали ShadowDOM v0
Embrace, Extend, Extinguish нового поколения.
А разгадка проста — из-за сильной интеграции с другими сервисами гугла, в первую очередь с андроидом, гмейлом пользуются все и писать они могут практически любой говнокод. Сравните даже хотя бы с яндексовой почтой.
Почему это был не его изобретатель
Изобретатель чего, AJAX?
Расскажите, это всё очень интересно. Мне тогда и в самом деле было 10-15 лет, и разработкой я тогда ещё не занимался, только читал книжки (года так с 2005-2006).
на ряду с полным месивом в поддержке существующих
Имхо, не было там особого месива. У меня до сих пор стоит учебник по JavaScript 2004 года издания на полке. Так вот, 60-70 процентов вещей, которые там описаны — кроссбраузерны на сто процентов (да-да, тот самый ES3). Остальное — в двух вариантах, для IE и для Firefox. Opera же, заняв очень мудрую позицию, часто поддерживала оба варианта (окей, не оба, почти всегда вариант IE; но начиная с момента, когда появился Хром, а в Хроме и Firefox подходы были более близки к друг другу и к стандарту — ситуация поменялась, и Opera стала делать как Chrome и Firefox, а синтаксис IE иногда поддерживался в придачу, «для совместимости» — как пример, свойство document.all, которого кроме IE нигде больше не было, а в Opera до версии 11.50 оно всё ещё работало).
Месиво всё-таки было и именно благодаря ему обрели популярность Prototype, MooTools и jQuery. Они брали на себя большую часть боли по поддержке особенностей браузеров. Отдельной историей было ещё и месиво с реализациями CSS.
В лидеры Хром выбился благодаря монопольному положению Гугла на рынке поиска и агрессивному маркетингу.
И не надо про эти ваши «большие проекты». Реальность в том, что именно «большие проекты» в большинстве случаев нафиг не нужны, их лепят вместо простых сайтов с текстом и картинками потому что это «стильно, модно, молодежно», а не потому что необходимо.
а не потому что необходимо.
Если бы это не было необходимым, то простые сайты с текстом и картинками выигрывали бы в конкурентной борьбе, но мы наблюдаем обратную ситуацию — выигрывают те самые "большие проекты".
Так уж вышло, что в 2018 разница между десктопным приложением и сайтом в интернете стала бесконечна мала, можно сколько угодно по этому поводу плакаться, но фарш провернуть назад не удастся.
Можете себе свой гипертекстовый фидонет замутить и там делать свои страницы с простым текстом и картинками. В вебе поезд ушел.
Если бы это не было необходимым, то простые сайты с текстом и картинками выигрывали бы в конкурентной борьбе
Если бы были сайты с равноценным контентом, но в вариантах с рюшечками и без — то так бы и было. Но в погоне за модой сайты с хорошим контентом превратились в монстров. А одной скорости для выигрыша в борьбе мало.
И нет, разница между сайтами и приложениями никуда не делась.
Если бы были сайты с равноценным контентом, но в вариантах с рюшечками и без — то так бы и было.
Так этих сайтов нет, потому что они проиграли конкурентную борьбу.
А одной скорости для выигрыша в борьбе мало.
Ну вот видите, вы сами ответили. Производительность должна быть достаточной, прирост производительности выше чем нужно — уже не дает никакой пользы. И если клиента устраивает производительность на уровне 1% от возможной, то ПО работающее на уровне этого 1% будет иметь конкурентное преимущество над тем, что работает на уровне 90%. Потому что пользователю на эту разницу плевать, а вот затраты на разработку — возрастут.
Так этих сайтов нет, потому что они проиграли конкурентную борьбу.
Нет, они проиграли борьбу не потому что на них не было рюшечек, а потому что современные монстры раньше были нормальными легкими и быстрыми сайтами, их аудитория в значительной степени сформирована за много лет, а поведенческие факторы позволяют и сейчас удерживаться в топе поисковиков.
Ну вот видите, вы сами ответили.
Нет, просто вы меня поняли так, как хотели понять.
Дело не в том, что если сайт грузится за 10 секунд, то это нормально и быстрее не надо. Дело в том, что между сайтом за 10 секунд с хорошим контентом и сайтом за 1 секунду с плохим любой нормальный человек выберет первое. Зато между сайтами с хорошим контентом но загрузкой в 10 и 1 секунду — второе. Это не та разница, на которую можно наплевать.
И дело, кстати, не только в загрузке, но и в последующем скроллинге и т.п.
Зато между сайтами с хорошим контентом но загрузкой в 10 и 1 секунду — второе.
Если бы это было так — мы бы видели в топе сайты с хорошим контентом и загрузкой в секунду. Но это не так.
а потому что современные монстры раньше были нормальными легкими и быстрыми сайтами
Но их потом взяли и специально сделали ненормальными, тяжелыми и медленными? Зачем? Заговор рептилоидов?
Я серьезно спрашиваю. Как вы объясняете этот парадокс?
Избежать всего этого можно — если делать простые и не очень красивые сервисы с небольшим количеством функций. «Дёшево и сердито». Но на такое меньше спрос, людям это уже приелось, им чего-то нового хочется. А за новое порой приходится платить тормозами, увеличившимся трафиком, необходимостью обновлять браузер и даже ОС…
И не надо говорить, что «компании все просчитывают перед тем как сделать». Ярчайший пример эпик фейла — Кинопоиск 2.0. Просто если изменения не такие резкие, то пользователи просто потихоньку привыкают, но это вовсе не значит, что они в восторге от всего этого.
Тем, что модно и тем, что можно (в смысле «гляди, как мы могЁм»). Туда же и регулярные редизайны.
Модно и можно кому? Вы же понимаете, что решение принимается не программистами? Зачем бизнес в это деньги вкладывает, если это ничего не дает?
Потому что бизнесу кажется (ключевой момент), что так будет лучше («патамушта какнкуренты так сделали, давай и мы сделаем»). Но «кажется» и «будет» — разные вещи.
Почему-то успешным оказывается именно тот бизнес, которому так кажется. А которому не кажется — успешным не оказывается.
Видимо, "кажется" обоснованно, в итоге.
попытка ошибкой выжившего оправдать неверную логику?
При чем тут ошибка выжившего? И логика вполне верная.
Еще раз — у нас, фактически, нет успешного бизнеса, которому не кажется (или есть, но это какие-то единичные и малоизвестные случаи).
Если бы данный фактор не влиял на результат, то мы бы не наблюдали такую ситуацию.
Доказывайте.
Зачем? Это очевидное для любого пользователя интернетов в 2018 наблюдение. С-но, именно это наблюдение стало причиной появления обсуждаемой статьи. И 2к комментов к ней. Вы сейчас будете придуриваться и делать вид, что всего этого нет? Ну если нет — то и обсуждать нечего, сайты быстрые, весят мало.
А не те, которым не казалось, а когда достигли успеха — стало казаться.
А какая разница, стало или было? Это совершенно несущественный фактор.
Итак, если бизнес достиг не думая, сейчас сидя на достигнутом стал думать, то успех и думанье за — никак не связаны.
Так никто и не говорит, что успех связан. Речь не о том.
Речь о том, что либо те, кто занимается успешным бизнесом — умные люди, и, с-но, если они считают правильным вешать на сайты свистоперделки, а Am0ralist не считает, то это потому, что они знают что-то такое, чего не знает Am0ralist.
Есть второй вариант — на самом деле отбор отрицательный, с-но условный Ларри Пейдж — тупой. Именно потому что он тупой, он и стал миллиардером (и остальные тоже). Из-за своей тупости он любит свистоперделки. А вот Am0ralist — он умный. По-этому он свистоперделки не любит, он знает, что все это просто каргокульт. И по той же причине миллионов Am0ralist не заработал — для этого надо быть тупым. Как Ларри.
Ну и третий вариант — все это просто такое большое совпадение.
Вариант по душе выбирайте уже сами.
Зачем бизнес в это деньги вкладывает, если это ничего не дает?За 4 года Webmoney сделали редизайн, по-моему, 6 раз, или даже 7. Зачем — непонятно.
За 4 года Webmoney сделали редизайн, по-моему, 6 раз, или даже 7. Зачем — непонятно.Не только Webmoney, но и много крупных банков и магазинов часто меняют дизайн. ИМХО это сильно раздражает постоянных клиентов, которые привыкли к прежнему. ИМХО многие начальники, принимающие решения, просто не знают основ психологии, а исполнителям нужно показывать свою необходимость делая ненужную работу.
ИМХО многие начальники, принимающие решения, просто не знают основ психологииОни как раз либо знают, либо догадываются.
Просто у них нет задачи понравится всем и каждому. И если старые пользователи ворчат, но не уходят, а новых сколько-то появляется — то цель достигнута, можно получить бонус.
Я в курсе, что есть новые тренды. Но тут получается массовый «вирус» — 25-30 процентов сайтов делают редизайн (не обязательно самые крупные), они становятся «модными и современными», и остальным уже как-то неловко оставаться со старым — в частности, они боятся, что новые клиенты начнут не так охотно прибывать :)
Но новые появились бы и без смены дизайна, разве нет?Статьи на Хабре и в других издания, шумиха в разных соцсетях и прочем. Ну а дальше — работает правило «не важно что о тебе говорят, лишь бы фамилию правильно называли».
Конечно тут важет факт редизайна, а не его тормоза, но… тут уж как получается…
Но тут получается массовый «вирус» — 25-30 процентов сайтов делают редизайн (не обязательно самые крупные), они становятся «модными и современными», и остальным уже как-то неловко оставаться со старым — в частности, они боятся, что новые клиенты начнут не так охотно прибывать :)И они, к сожалению, правы. Мода тоже часто заставляет носить одежду, которая откровенно неудобно, а иногда и опасна для здоровья. Но ведь носят. Тоже самое и тут.
Но тут получается массовый «вирус» — 25-30 процентов сайтов делают редизайн (не обязательно самые крупные), они становятся «модными и современными», и остальным уже как-то неловко оставаться со старым — в частности, они боятся, что новые клиенты начнут не так охотно прибывать :)И они, к сожалению, правы. Мода тоже часто заставляет носить одежду, которая откровенно неудобна, а иногда и опасна для здоровья. Но ведь носят. Тоже самое и тут.
Причём как раз некоторый парадокс в том, что айтишникам это очень тяжело понять, так как очень многие их них скорее готовы прослыть «немодными», тем мучиться с неудобной одеждой… но ведь людей, «следящих за модой» — куда больше.
Мода тоже часто заставляет носить одежду, которая откровенно неудобна, а иногда и опасна для здоровья.ИМХО с модой сложнее см. Википедию:
Сегментами рынка модной индустрии являются категории, на которые подразделены различные марки и бренды, в зависимости от своих параметров — качества изделий, способа выпуска коллекций и ценовой политики производителяЕсть «Высокая мода», «Средний ценовой сегмент», «Массовые марки». В свою очередь в них есть под-сегменты.
Просто у них нет задачи понравится всем и каждому.Не всем и каждому, а удержать постоянных клиентов. Нпр., если клиенты массово забирают вклады из банка — он может рухнуть.
И если старые пользователи ворчат, но не уходят,Обычно уходят. В развитой экономике есть большой выбор. И внутри одной структуры часто бывает выбор. Нпр., операции по банковскому счету можно делать он-лайн, а можно в отделении. Если клиентам неудобно он-лайн, они будут использовать отделения банка загружая работников, а эффективность сайта упадет. Многие магазины торгуют не только по сети. Будет больше покупок вживую, больше заказов по телефону, а прибыль через сайт упадет.
1) решение «добавить вот эту рюшечку» обычно принимается не программистом, а каким-нибудь продажником или маркетологом (по крайней мере, в случае малого и среднего бизнеса, а не контор уровня Facebook), большинство из которых — это гуманитарии из тех, что называет процессором системный блок. Соответствено, о том, что это повлияет на скорость, они просто не думают.
2) у программиста, реализующего это решение, обычно не хватает либо квалификации (просто не знает, как сделать ту же асинхронную загрузку или догадаться повесить подгрузку скрипта на подходящее событие), либо времени (когда задача ставится в духе «это надо было сделать вчера, а ты тут собираешься еще два дня с оптимизацией возиться»), либо мотивации («зачем тратить усилия и оптимизировать, если все равно никто этого не оценит толком»).
3) выросло поколение пользователей, которое толком не знает, что такое по-настоящему быстрые сайты, и сложившуюся ситуацию воспринимает как норму (поэтому и не уходит к конкурентам, даже если они есть).
4) отношение к пользователю как к слепому и умственно отсталому существу, которое неспособно самостоятельно найти кнопку «подписаться» или «задать вопрос» и его необходимо потыкать мордой в баннер на полэкрана.
5) всеобщее убеждение, что программа или сайт должны постоянно обновляться вместо «хорошо сделанное и выполняющее свои задачи ПО в обновлениях не нуждается» (кроме разве что исправления уязвимостей в безопасности, если таковые будут найдены).
А те, кто без рюшечек — должны искать посетителей иначе. Своё ядро преданных пользователей, сарафанное радио. Я вот вспоминаю, многие паблики в вк вроде «Подслушано» в начале своего пути так развивались. А вовсе не через поиск, рекламу или оплаченные посты в других сообществах.
Гмейл выиграл не потому, что он свистит на компьютере пользователя.Как раз за счёт этого. В 2004м, когда он появился большая чем почты в браузере была на обычных формах и потому работала гораздо медленнее, чем AJAX-подобный GMail…
Конечно в современных реалиях быстрого интернета и многомегабайтных страниц GMail'а разница невелика — но тогда GMail был меньше, а «обычная почта» — тормознее.
И оно не свистело. Оно было удобно и по делу.Так всегда бывает. Вначале добавляются фичи, которые реально удобны (AJAX позволил резко снизить задержки), а потом, через несколько лет — получаем монстра.
Во многом и Chrome был рождён из-за того, чтобы GMail-подобные сайты можно было писать не опасаясь добавить пару строк JavaScript'а… ну а потом, как и везде — оптмизаторы V8 упёрлись в возможности железа, а астронавты продолжили решать несуществующие проблемы…
Только вспомнить, сколько всего редко используемого (и в целом опционального) было напихано: Flex, CSS Grid, WebSQL (на страницах MDN как-то осторожно пишут, что лучше этим не пользоваться, поскольку разработка стандарта была приостановлена на стадии драфта), SPDY/HTTP2, WebRTC, WebAudio с кучей фильтров, больше подходящих для работы со звуком в проф. аудиоредакторе типа Nuendo/Cubase, чем для применения на сайтах или в JS игрушках (который сначала добавили, потом убрали, потом снова добавили в сокращённом варианте, но только в Chrome, в Firefox не стали).
HTTP2 ускоряет загрузку
Тогда почему я так мало где его вижу?
CSS Grid был бы полезным
Он не то чтобы бесполезен. Он сложен в освоении. По крайней мере для тех, кто пос старинке верстал на блоках.
Flex позволяет наконец нормально верстать
Вот здесь поподробнее, плиз. Чем до этого было не нормально?
И кстати с корректностью отображения у этой технологии всё плохо. Я молчу про Оперы на Presto, которые не умеют Flex, потому что его ещё не было, и Хромы версий до какой-то там. Но ирония в том, что даже в Firefox дизайн, сделанный на Flex-ах, безбожно корёжится аж до версии 51 включительно (она вышла, на минутку, не так уж и давно). Если кто не верит — можно открыть Twitch с помощью сервиса-эмулятора, позволяющего просматривать сайты в разных версиях браузеров под разными ОС.
Как по мне, при такой вёрстке как минимум меньше контроля над происходящим (хотя всё ещё можно корректировать огрехи расположения с помощью position: relative, но получается, что эти корректировки ещё и должны быть browser specific).
Фейсбук выиграл не потому, что у него пердящая форма авторизации. Гмейл выиграл не потому, что он свистит на компьютере пользователя. Ну и так далее.
Возможно, но мы же наблюдаем четкую корреляцию. Если пердящие формы и свистящие гмейлы сами по себе не являются причиной победы, то этой причиной является, по крайней мере, нечто с ними связанное.
Если "простые и легкие" сайты заменяются на свистящие и пердящие — значит в этом есть какой-то смысл, ведь это все требует каких-то дополнительных телодвижений, согласитесь.
Веб — это информация, текст, таблицы, картинки.
Эм, нет. Веб — это добавление информации, текста, таблиц, картинок… А для этого нужен и js, и фреймворки, и на фронтенде, и на бэкенде. Предпросмотр нового коммента все-таки удобнее, чем перезагружать страницу отправкой формы и проверять как оно выглядит, не так ли?)
P.S. Никогда не люблю юзать сторонние решение, особенно если они явно избыточны.
Откройте любую статью, посвещенную опенсорсу. Как там хорошо, что много глаз код просматривают и все такое… (заметите под ковер heartbleed). А потом разверните аргументы на 180* и получите перечень проблем, которые возникают от «всего своего». Начиная от качества этого «своего» и заканчивая временем нового разработчика для понимания.
Нет ничего «крутого» в том, чтобы сделать медленну, кривую, работающую только в пачке браузеров реализацию, вместо того, чтоб взять нормальную.
Потому что вы обрекаете пользователей на баги, которые давно починены в библиотеках.
Надо просто писать без багов.
Начиная от качества этого «своего»
Зависит от того, кто и как реализует (и насколько ему интересно/приятно этим заниматься).
и заканчивая временем нового разработчика для понимания
Опять же, если код аккуратный, с комментариями (а ещё лучше, self-docemented, не нуждающийся в комментариях) — порог вхождения нового разработчика будет не очень высоким.
чтобы сделать медленную
В том-то и дело, что как правило, это будет в 2-3 раза быстрее, чем на каком-то фреймворке/движке, как минимум из-за отсутствия лишней логики.
работающую только в пачке браузеров
Так надо писать так, чтобы работало во всех, а не в пачке! Где я за «пачку» агитировал?
Единственные плюсы фреймворков — это обход особенностей и багов старых браузеров, о которых разработчик банально может не знать, и большая компактность получающегося кода.
Но с другой стороны, для старых браузеров можно использовать условно подключаемые полифилы, и результат будет надёжнее и предсказуемее, так как фреймворк неизвестно насколько большой совместимостью в сторону старых версий обладает, особенно если брать динозавров вроде IE 6-8 и новые версии JQuery. Причём даже если фреймворк обладает такой совместимостью, то вот плагины к нему (на примере того же JQuery) с вероятностью 99,9% — нет, и всё равно в старом браузере сайт сломается и будет нерабочим. Кроме того, в случае 90% проектов на совсем старые браузеры вроде IE до версии 9 можно вообще забить, поставив заглушку с просьбой обновиться.
Что до компактности, то из-за неё сложность исполнения кода браузером увеличивается если не на порядок, то в разы, также растёт и количество потребляемой памяти: например, известный факт что движки обычно работают с синтетическими объектами событий (заворачивая внутрь них обычные как одно из полей), оборачивают HTML элементы в специальные объекты, возвращая результаты из функций-селекторов, и так далее).
А другой человек подумает, возьму я JQuery (который, к слову, давно уже пора закопать) и буду анимировать всё на нём. И конечно же будем вычислять каждый кадр каждого свойства каждой анимации на CPU, и каждый раз будем сбрасывать кеш всей страницы. Это ведь на порядок, как вы говорите, стабильнее. А на пользователей нам плевать.
Верно я понял вашу мысль на тему «JQuery для анимаций»?
Долго я там не проработал, но осадок остался…
В любом случае визуализация должна быть на стороне css — это точно, а на JS уже бизнес-логика. Если ваш calc только для позиционирования элементов, то не вижу ничего страшного в этом, сам с недавнего времени начал активно его использовать и не понимаю теперь как жил без него.
Я привёл в пример всего лишь один из случаев, когда кто-то, не зная одного инструмента, но зная другой ненамеренно всё усложняет. По-этому весь софт и становится медленнее.
Конечно, есть и другие критерии. Например, дополнительные абстракции ради снижения сложности поддержки ПО. Как раз тот из вариантов, когда JQ можно использовать для селекторов. Хотя, лично я в этом вижу не слишком много смысла, благо 2018год на дворе и давно есть querySelector, но мнение имеет право на существование.
по этому лично для меня, написание нативных решений js, в любом случае подразумевает дополнительные затраты по времени
Вы полагаете, изучить и научиться применять на практике такую большую библиотеку, как jQuery (пусть и не самую сложную из тех что есть), будет быстрее? Тут смотреть надо
Тот же GitHub заменил jQuery на querySelectorAll и fetch с полифиллом.
Предпросмотр нового коммента все-таки удобнее, чем перезагружать страницу отправкой формы и проверять как оно выглядит, не так ли?)
То есть в эпоху стамегабитного интернета Вам западло лишний раз "перезагрузить страницу отправкой формы"? Если уж Вам тяжело перещагружать страницу со 100500 комментариями — загрузите окно предварительного просмотра в iframe, наконец!
Если на каждой странице будет по iframe со своей разметкой на каждое действие, то мне кажется ресурсов это будет занимать еще больше. Вместо 20 вкладок в памяти браузера будет 60-100. А если и нет, все равно это менее удобно, почему и стали делать на js.
Тот же Хабр в данном случае исключение, здесь комменты могут быть даже интереснее статей. Но в подавляющем большинстве случаев комменты прямо на странице нафиг не нужны, а вот малый вес и быстрая работа еще никому не вредили. Хотите пообсуждать — вот вам ссылка на форум. Легко и просто, но не модно, это да.
Критикуешь — предлагай. Если это легко и просто, покажите, что сделали лично вы и сколько времени на это потратили, без js и библиотек/фреймворков. Причина идет из создания кода, а не из моды. Я этим занимаюсь, и утверждаю, что не легко и не просто.
В конце концов есть простое и абсолютно элементарное решение — кнопка или ссылка, по которой пользователь переходит на страницу, где вы можете хоть гигабайт жабаскрипта навешать. Хочет какой-то пользователь пострадать — пусть страдает. Не надо делать тормозные страницы, только из-за того, что кто-то захочет что-то прокомментировать.
И даже на более интерактивных сайтах можно что-то такое придумать, чтобы страницы, где 99,99% пользователей только читают, не загружали весь мусор, необходимый для интерактивного взаимодействия.
Сайты на которых интерактивное взаимодействие — основная, критическая часть функционала — это одно. Где совершенно необязательная — совсем другое. Но вторые почему-то маниакально изображают из себя гибрид фейсбука с твиттером.
Я говорю о конкретной и при этом самой распространенной категории сайтов. Сайтов информационных, на которых контент генерирует только автор сайта.
Таких сайтов сейчас практически нет. Интернет-магазины, соц-сети, веб-интерфейсы к сервисам типа почты — это самые распространенные категории, и везде есть функционал, который требует действий от пользователя. Даже на сайте газеты NY Times есть кнопки подписки, поиска, и подгрузка картинок при прокрутке. И как раз на популярных ресурсах перенос части обработки на клиент дает пользу.
по которой пользователь переходит на страницу, где вы можете хоть гигабайт жабаскрипта навешать
Ну вот это они и есть. Не хотите, не переходите) Вы предлагаете тратить в 2 раза больше денег и поддерживать 2 версии. Мало кто на это пойдет.
Мне тоже не нравится тормознутость, но надо понимать, что у нее есть причины, и нельзя просто взять и убрать ее, ничего не потеряв.
Модная подгрузка страницы при прокрутке — на самом деле одно из вреднейших извращений. Если раньше при использовании pagination я мог сразу перейти на 10-ю, 100-ю, да хоть на миллионную страницу, то теперь чтобы попасть на 100-ю мне нужно перелистать все 99 предыдущих. Мало того раньше первая и последняя страницы работали одинаково быстро, то теперь быстро (и то относительно) работает только первая, поскольку при подгрузке постепенно растет объем пожираемой памяти и тормоза.
Вы предлагаете тратить в 2 раза больше денег и поддерживать 2 версии
А зачем ее отдельно поддерживать? Если вы не будете лезть с ненужными никому кроме вас «улучшениями», то она может работать десятилетиями. В конце концов верстку вы можете иметь идентичной с интерактивной страницей.
Мне тоже не нравится тормознутость, но надо понимать, что у нее есть причины
У нее гораздо меньше рациональных причин, чем вам хочется думать.
Таких сайтов сейчас есть сколько угодно.
Примеры?
Модная подгрузка страницы при прокрутке
Я не писал "подгрузка страницы", я написал "подгрузка картинок". Это совсем не то, о чем вы говорите.
А зачем ее отдельно поддерживать?
У вас какое-то неправильное представление о том, как делаются веб-приложения. Если мы переименовали поле в базе данных с body на text, то и в обычном коде, и в коде "без скриптов" надо поменять условный output($news['body']) на output($news['text']). Если мы поменяли верстку шаблона интерактивной страницы для новости, то и верстку шаблона для страницы "без скриптов" надо менять, чтобы они были идентичные. Просто отключить скрипты не выйдет, вы можете в этом убедиться, отключив скрипты в браузере. Нужно предпринимать отдельные усилия, чтобы работало и так и так. Один и тот же шаблон использовать нельзя, потому что в одном шаблоне есть условная кнопка "Подписаться", а в другом нет. Либо каждый блок, требующий скриптов, оборачивать в проверку выводить или нет, и проверять, что при добавлении очередной кнопки в версии без кнопок ничего не поехало. И т.д. и т.п.
У нее гораздо меньше рациональных причин, чем вам хочется думать.
Так я причины из практики знаю. То, о чем вы говорите, требует дополнительных ресурсов при разработке.
Примеры?
Вики. Которая как раз прекрасно работает на отображение вовсе без js, а редактируется на отдельной странице.
Просто отключить скрипты не выйдет, вы можете в этом убедиться, отключив скрипты в браузере
Это только при условии, что js служит не только для взаимодействия, но и для отрисовки. И да, вы меня тоже изначально неправильно поняли. Совсем необязательно иметь 2 визуально идентичных версии страницы, на одной из которых комментировать нельзя, а на другой можно. Есть смысл разделить функционал. Очевидно, что подавляющее большинство только читает, скажем, новости. Они получают легкую и быструю страницу без лишних скриптов с кнопкой/ссылкой «обсудить». И вот на этой странице делайте что хотите. Я не вижу смысла делать ее визуально похожей на первую страницу.
Так я причины из практики знаю. То, о чем вы говорите, требует дополнительных ресурсов при разработке.
Так это потому что вы и те, кто дает вам задание, мыслите именно в такой парадигме.
Вообще было бы гораздо проще обсуждать все на конкретных примерах.
Вики.
Мы говорили о сайтах, которые "Поэтому там не нужно ни форм с валидацией, ни прочего. Но где все это навешивается, потому что у 100500 других сайтов такое есть.".
В вики информация статичная, действия пользователей не требуются, потому там и скриптов нет. А там где есть, там навешивается не потому что "у других сайтов есть", а потому что надо для определенных целей. Даже анимацию добавляют не потому что на других сайтах есть, а потому что там из-за этого новых пользователей больше.
Так какие есть распространенные сайты, где все это есть, но можно убрать без проблем?
Они получают легкую и быструю страницу без лишних скриптов с кнопкой/ссылкой «обсудить». Я не вижу смысла делать ее визуально похожей на первую страницу.
Ну вот у нас и появилось 2 страницы вместо одной, да еще и с разной версткой. И почему вы все время про комменты говорите? Это был пример конкретно про Хабр, на других сайтах свои применения скриптов. Та же кнопка "Подписаться". Сделают так, как вы предлагаете, а потом будут жалобы от пользователей "почему у вас кнопку Подписаться не найти, вот сайте X она рядом со статьей, нажал и все".
Так это потому что вы и те, кто дает вам задание, мыслите именно в такой парадигме.
Если на фреймворке прототип делается за час, а без него за неделю, тут не надо никаких парадигм.
Потому что если судить с позиции количества пользователей, то вики — это куда более «распространенный» сайт, чем все сайты, в разработке которых вы хоть как-то принимали участие за всю жизнь. Если судить с точки зрения количества самих сайтов, то как раз сайтов со статической информацией вася-пупкин.рф опять же на порядки больше ваших сайтов, в которых действительно нужны тонны скриптов.
Даже анимацию добавляют не потому что на других сайтах есть, а потому что там из-за этого новых пользователей больше.
Это как? Откуда появляются при этом новые пользователи?
Так какие есть распространенные сайты, где все это есть, но можно убрать без проблем?
Я свои примеры привел. Давайте наоборот — приведите хотя бы один пример сайта где тонны js прямо необходимы.
Та же кнопка «Подписаться». Сделают так, как вы предлагаете, а потом будут жалобы от пользователей «почему у вас кнопку Подписаться не найти, вот сайте X она рядом со статьей, нажал и все».
По-видимому вы так и не поняли. Оставьте все необходимые кнопки, только сделайте их просто ссылками на соответствующие страницы — и все! Даже не на много, а на одну страницу.
Ну вот у нас и появилось 2 страницы вместо одной, да еще и с разной версткой.
И не говорите, это просто ужас. Ведь на второй странице нужно обязательно делать какой-нибудь крутой дизайн, а это сложно, дорого и бла-бла-бла.
Правда я сделал бы там дизайн в духе ya.ru (ага!), который стоит 3 копейки и не нуждается в поддержке. Но да, это же сейчас не модно…
Если на фреймворке прототип делается за час
Дак кто ж вам запрещает делать на фреймворке прототип? Сколько угодно. Но вот в продакшн — не надо…
И не говорите, это просто ужас. Ведь на второй странице нужно обязательно делать какой-нибудь крутой дизайн, а это сложно, дорого и бла-бла-бла.
Правда я сделал бы там дизайн в духе ya.ru (ага!), который стоит 3 копейки и не нуждается в поддержке. Но да, это же сейчас не модно…
Пользователям тоже будете сами объяснять, какой это крутой дизайн?
Это очень странно, поскольку google.com миллиардам пользователей по-видимому вполне нравится. А там как раз дизайн вроде того, что предлагаю я.
Я так понимаю, что для вас «распространенные сайты» — это сайты, которые вы разрабатываете.
Из чего вы сделали такой вывод? Вы говорили про "распространенные сайты, где все это навешивается". Я попросил примеры. В Википедии это навешивается? Нет. Так какое отношение она имеет к разговору?
Я бы даже сказал, она подтверждает мои слова. Там не нужны скрипты, вот и не добавляют. А где добавляют, значит там они зачем-то нужны.
как раз сайтов со статической информацией вася-пупкин.рф опять же на порядки больше ваших сайтов
А какая вам разница, что на личном статическом сайте Васи Пупкина используется JS? Там все равно ничего не тормозит, потому что функциональности мало, да и вряд ли вы столько личных сайтов посещаете.
Это как? Откуда появляются при этом новые пользователи?
Ну вот так. Нужен человеку некий функционал, есть 2 сайта с таким функционалом, на одном есть анимации, приятные глазу, на другом нет. Поэтому он зарегистрировался на первом сайте.
На втором сайте заметили, что пользователей что-то мало, а в интернете все первый сайт обсуждают, запустили рекламу с a/b тестированием, и оказалось, что если интерфейс без анимаций, то меньше пользователей регистрируется.
А третий сайт не стал проводить тестирование, а сразу добавил анимации.
Я свои примеры привел. Давайте наоборот — приведите хотя бы один пример сайта где тонны js прямо необходимы.
Нет, не привели. Только про одну Википедию написали, которая ни при чем.
И давайте без демагогий. Я не говорил, что необходимы именно тонны js, я говорил, что в целом js и всякие библиотеки/фреймворки нужны. Но вообще https://docs.google.com неплохой пример.
Оставьте все необходимые кнопки, только сделайте их просто ссылками на соответствующие страницы — и все! Даже не на много, а на одну страницу.
"Я нажимаю кнопку Подписаться, а страница просто перезагружается. С остальными кнопками то же самое. Почините немедленно!". Ну и да, одна страница все равно требует меньше ресурсов (для разработки), чем две похожие. И зачастую разница гораздо больше, чем в 2 раза.
Правда я сделал бы там дизайн в духе ya.ru (ага!), который стоит 3 копейки и не нуждается в поддержке.
Вы неправильно представляете, как делаются веб-приложения. Не требует поддержки только страница, которая сверстана полностью в блокноте и лежит на диске в виде отдельного файла. В любом блоге на Вордпрессе, в любом новостном сайте, информация сохраняется в базу данных и выводится кодом. Все это требует поддержки и проверки при изменениях.
Ну и да, большинству пользователей неохота смотреть на ужасный дешевый дизайн.
Но вот в продакшн — не надо
Вы думаете, для продакшена математика другая и там по волшебству дополнительные недели появляются?)
Ну и да, одна страница все равно требует меньше ресурсов (для разработки), чем две похожие. И зачастую разница гораздо больше, чем в 2 раза.
Про сложность согласен, это важный фактор. Хотелось бы однако отметить, что есть техники, позволяющие обойтись всего одной страницей, и при этом обеспечить её полиморфное поведение. То есть она будет одинаково хорошо работать и при отключенном, и при включенном JS. Вы наверное об этом знаете. Ну да, в разработке это сложнее, и даже не в 2 раза. Зато у нас одна страница, работающая везде и у всех (даже в каких-нибудь мобильных Операх Мини), все правки централизованы в одном месте, разработчики заняты делом и получают повышенную зарплату за возросшую сложность. Классно же.
Я бы даже сказал, она подтверждает мои слова. Там не нужны скрипты, вот и не добавляют. А где добавляют, значит там они зачем-то нужны.
Далеко не всегда. Скажем, надоедливые баннеры «добавляйтесь в друзья» или «закажите обратный звонок», закрывающие контент в самый неподходящий момент, вряд ли можно назвать нужными. Но их вешают. Про навязывание подписки на push-уведомления и вовсе молчу. Или, скажем, онлайн-чаты, которые сейчас на каждом втором магазине висят. В принципе, неплохая вещь, если их делать нормально, то есть сначала видна только кнопка «Задать вопрос» (еще для привлечения внимания по ней можно какой-нибудь блик пустить), а при щелчке по ней подгружаются необходимые скрипты и начинается чат. Но нет же, делают загрузку скриптов сразу и сразу же разворачивают окно чата.
Если на фреймворке прототип делается за час, а без него за неделю, тут не надо никаких парадигм.
Так речь же о том что на фреймворке у конечного пользователя тормоза начнутся.
Ну вот этот come_block надо добавлять в каждый блок, и желательно в обертку, чтобы собственным классам не мешало. Суть же не в том, что сделать нельзя, а в том, что поддерживать надо. А еще оно все равно на клиент поедет.
come_block — Это и есть собственный класс в примере выше)<button class="display_inline_block come_block"></button>Ну если вы вот так сделаете, то верстка может поехать, там же display другой задан.
Думаете не хватает на разработчиков?
Мы пользовались софтом, который работал на компьютерах в сто раз медленнее нынешних смартфонов, при этом он был значительно более функциональный, отнюдь не стоил космических денег для пользователя, а разработавшие его программисты были ничуть не менее богатыми, чем современные. Так что проблема отнюдь не в том, что для разработки более качественного ПО нужно намного больше денег.
Мобильный софт — это вообще издевательство. Там количество фич только уменьшается. Старые гугл.карты (еще на Андроиде 2) умели трекать остановки транспорта. В новых появилась прекрасная фича «потряси телефон, если нашел ошибку», зато они перестали показывать таймлайн с остановками маршрутки. Хотя, вроде в этом году вернули эту фичу обратно…
Атом (который редактор) в принципе не умеет того, что умеет мой emacs.
Про новый скайп уже говорили.
Даже в новом MSPaint потеряли какую-то фичу, которой многие пользовались в оригинальном приложении. Извините, не помню деталей.
При желании, этот список можно продолжать еще долго.
Скорость работы именно программы выросла — Эксель научился нормально использовать многопоточность для расчетов (сравнивал 2016 на десятке с 2013 на семерке).
Либреофис отстаёт очень сильно, и может служить нормальной заменой только для относительно простых задач.
Скорость работы именно программы выросла — Эксель научился нормально использовать многопоточность для расчетов (сравнивал 2016 на десятке с 2013 на семерке).Вот это, пожалуй, первое реально полезное добавление после MS Office 2000. Хоть кто-то что-то может назвать.
совместная работа появившиеся в версиях 2016+Тоже интересно.
Но, заметьте, обе этих вещи отсутствовали в MS Office 2000 в силу полнейшей бессмысленности в тогдашних реалиях, а не потому что разработчики не могли их реализовать… и совершенно неясно почему эти вещи нельзя было добавить сохранив быстрый и отзывчивый интерфейс…
Либреофис отстаёт очень сильно, и может служить нормальной заменой только для относительно простых задач.Возможно. Я не нагружаю его так сильно, чтобы меня нервировало отсуствие многопоточности — а вот то, что MS Office изображает на экране «патоку» даже на 24-ядерной машинке… меня раздражает…
Ну в начале 2000-х как минимум одноранговые локальные сети были нормой, а многие даже небольшие компании и домен на в2к поднимали. И терминальные серверы тогда же или чуть позже (в в2к3) в массы пошли.
Ну в начале 2000-х как минимум одноранговые локальные сети были нормойВ одноранговой сети совместное редактирование документов не нужно. Если уж так хочется вот прям одновременно вдвоём редактировать — проще взять стульчик и сесть вдвоём у одного компьютера. Правда-правда, попробуйте.
А вот что нужно — так это передача документов от одного отдела другому с разными рецензиями и прочим. И это всё в MS Office 2000 (да и в MS Office 95/97) достаточно хорошо развито.
что умеет мой emacs.
Только вы почему-то не упомянули что емакс тормозит ;)
за возможность играть в новую игру хоть каждый день
А можно поподробнее, что в этом инновационного по сравнению с, к примеру, приставками из 90-х?
1. Вам не нужно убеждать магазин в том, чтобы он начал распространять ваш продукт. Зарегистрировались, выложили. А дальше уже покупатель голосует рублём/долларом/юанем.
2. Магазин не имеет никаких прав на ваш продукт, ни даже эксклюзивного права на распространение. Как вам больше нравится — так и распространяйте. Издательство же вас сожрёт с потрохами.
3. Магазин у вас не требует никакой финансовой доли в бизнесе. Он продал ваш софт — он взял свою комиссию, не продал, он ничего не потребовал. Насчет того, что комиссия большая, вопрос спорный. Сколько вам не жалко отдать денег посреднику за продажу вашего товара, которой без него вообще бы не было? Особенно если учесть, что тиражирование этого товара не стоит вообще ничего.
И они даже не берут некоторый процент с продаж?
Ну, на ваши расходы на создание продукта это уж точно никак не влияет. Согласитесь, факт, что магазин берёт свою наценку при продаже вашего товара, абсолютно естественен и логичен.
А зачем аппстору юридические эксклюзивные права, если 99.9% пользователей iOS не имеют других источников?
Зато пользователи Андроида тоже с удовольствием поиграют в те же Растения против Зомби, что и на аппсторе. А вот издатели иногда трясут ананайкой перед студиями, дескать, «хочу, чтобы в ЛастОфАс играли только на нашей любимой плейстейшен, и нигде более».
Не напомните, какой размер указателя в байтах был на windows 98, и каков он в «современных приблудах на телефоне», раз уж взялись мерить?Припомню, да. 4 байта размер указателя в Windows 98 (сегмент 16 бит, смещение 16 бит), 4 байта сегодня (да, большинство приложения 32-битные до сих пор). И?
При этом с помощью этого браузера я могу решить в тысячи раз больше задач, чем с помощью вашего 97го офиса, 98 винды, и каждого по отдельности приложения для нее.Замётано. Не расскажите — как именно с помощью вашего браузера создать табличку с формулами и посчитать что-нибудь в ней. Сделать каталог с книгами и найти там чего-нибудь? Ну или, на худой конец, подготовить и распечатать книжку с картинками? Это всё Офис делал в 97й версии без каких-либо дополнительных аддонов или чего-либо ещё…
Я про существование таких знаю, могу даж пример привести. Целое одно приложение, вы не поверите.
Все остальные — либо ABI-agnostic (то есть там может быть любой поинтер), либо с поддержкой armeabi-v7a.
P.S. Да, я знаю, что в мире iOS всё не так — ну так это, опять-таки, чисто и исключительно хотелки чьи-то. То ли Тима Кука, то ли духа Стива Джобса, я не знаю. Никакой объективной необходимости в таком «форсированном» переходе на 64-бита нет и не было.


Интересно, как ей бы было с 32-битными указателями.
Иногда удивляюсь, почему "compressed pointers" так мало распространены. Выравнивание по 8 байт — и можно адресовать 32ГБ, используя 32-битные указатели. Немного памяти сбережёт.
Не расскажите — как именно с помощью вашего браузера создать табличку с формулами и посчитать что-нибудь в ней. Сделать каталог с книгами и найти там чего-нибудь? ...
Гуглодокс и прочие веб приложухи.
И не говорите мне что 97ой офис не тормозил нa компах того времени. Еще как тормозил. Ворд частенько падал при сохранении/загрузки нетривиальных документов, все они нe показывали контент при скролле и т.п.
Попробуйте собрать себе старый комп с 98ой виндой и поработать под ним. Очень быстро захочется обратно в «тормозное будушее»
А бразуер, грубо говоря, парсит и генерирует http, и может открыть некоторые файлы для чтения.
Как верно заметили выше, браузер только парсит HTML, применяет CSS и исполняет скрипты; в довесок он умеет определять геопозицию юзера, показывать картинки и сохранять их на диск, проигрывать аудио и видео (уже лет 7-8 как), выводить и подсвечивать в консоли JS код, а также исполнять пользовательский код прямо там же. Но это обстоятельство не позволит вам сделать электронную таблицу, сверстать книгу или статью, или сделать слайд-шоу. Для всего этого нужно облачное приложение — браузер же может его только исполнить. Некорректно говорить, что функционал, предоставленный этим приложением, предоставлен непосредственно браузером. С таким же успехом можно сказать, что мы обязаны всему JVM или компилятору (браузер по сути такой же JIT-компилятор/интерпретатор).
А может и в 1000-100000 раз быстрее. Смотря что…
Через веб-приложение — да, но при чём тут браузер?
Ээ… А браузер без веба зачем нужен то вообще?
P.S. Это если забыть про то, что начиная с MS Office 2000 в офис и «настоящий» браузер входит. Кокретно в MS Office 2000 — MS IE 5.0
У меня вопрос по существу вашего примера имеется. Код простой, но у меня он, однако же, не работает. Ошибка очень забавна: "
document.querySelectorAll(...).forEach is not a function". Перед этим я заменил стрелочную функцию на обычную, так как моя версия Хрома стрелочные ещё не поддерживает. Но тем не менее подсчёт итоговой суммы не работает. Я так понимаю, querySelectorAll возвращает в моей версии не массив, а NodeList или что-то вроде того, и у этой сущности отстутствуют методы массивов. То есть надо делать Array.prototype.forEach.call(...). Вопрос, почему у Вас работает без этого?P.S. Не знал про темплейты, спасибо, теперь где-нибудь применю при случае :)
ЗЫ foreach работает не везде
И не говорите мне что 97ой офис не тормозил нa компах того времени. Еще как тормозил.
На новом компе 1997-го (а это был бы Pentum 133+ с 16 Мб памяти и выше) года он работал адекватно, не тормозил. На компе 1999-го уже бы летал. Сложно сравнивать производительность тех лет с современной, т.к. тогда за год-полтора производительность вырастала в разы, а сейчас лет за пять процентов на сорок.
У меня на новом компе 2018-го последний офис тожe не тормозит.
У меня на новом компе 2018-го последний офис тожe не тормозит.А вы в этом уверены? Или вам так кажется?
Поставьте себе MS Office 2000 (он на Archive.org доступен), поиграйтесь пару дней — и, внезапно, MS Office 2016 начнёт тормозить.
Мы просто забыли что бывают программы, которые не тормозят.
И я даже могу сказать когда это произошло: 1984й год, вот тот самый роликс молотком, являение GUI народу.
Потому что до этого времени всем было известно сколько времени занимает реакция компьютера на действия пользователя: 16.6ms, вот как клавишу нажали, так в следующем кадре — видим результат. Интерфейс весь под этот подгонялся: не можем перерисовать весь экран — думаем что можем за 16.6ms изменить, так и работаем.
А вот появление GUI сделало «патоку» нормальной… но это, в общем, ощущалось как нечто временное: да, оно тормозит пока, но потом машинки станут мощнее, и будет как в рекламе — красивые окошки и реакция за 16.6ms…
Однако прошло 30 с лишним лет, а «патока» — по прежнему на экране. Только разработчики игр знают, что может быть по-другому…
У меня на новом компе 2018-го последний офис тожe не тормозит.
Вы знаете, я на последний офис в этом плане тоже не жалуюсь, видимо, там ещё достаточно кодовой базы с тех лет осталось. Зато у меня на новом компе 2018-го года заметно глазу подтормаживает последний вайбер и скайп, просто при наборе сообщений. Вдумайтесь, клиент чатика, который со всем шифрованием и эмодзи по функционалу представляет несопоставимые крохи в сравнении с офисом, притормаживает на восьмиядерном процессоре и NVMe диске.
Ну и скайп никогда вроде как не был эталоном производительности и вообще хорошего софта.
Договоритесь со знакомым Васей, он вам сделает Ворд, а вы ему Эксель) Можете обсудить стоимость. Только она не важна) Вы можете сделать друг-другу куски офиса скажем за мильярд долларов. Хватит? Но взаимозачет же. Он вам. Вы ему.
Только фишка же получается не в деньгах вовсе) Ни он ни вы абсолютно ничего не сделаете.
Выводы.
Причем тут фишка еще и в том, что тут совсем деньги ни при чом. Потому что вы и так знаете, что Вася вам ничего в итоге не сделает) А значит и вы не захотите. Смысла же нет.
Если вы ваш скил обратите в экономические бумашки — эти бумашки вообще ничего не будут стоить. Потому что вы ничего не можете вовсе) Потому что есть другие, которые могут. Которые сделают круче, быстрее и дешевле, а скорее всего вообще задаром.
И да, браузер тут вообще не нужен.
Договоритесь со знакомым Васей, он вам сделает Ворд, а вы ему Эксель) Можете обсудить стоимость. Только она не важна) Вы можете сделать друг-другу куски офиса скажем за мильярд долларов.
Идея богатая и в некоторых кругах весьма уважаемая. У каждого фигуранта в этом случае остается компания с миллиардным оборотом.
Остается отрастить бороду, подвернуть штаны — и на ICO, а того краше — на IPO.
Отображать pdf
Только если стоит плагин от Adobe, либо, опять же, через JS расширение, написанное сторонним разработчиком (да, его иногда включают в поставку, но у меня даже нет уверенности, что его пишут те же люди, что сам браузер).
Предоставляет инструменты для их верстки.
Да, но это верно только для HTML, в какой-то другой формат экспорт сделать будет вряд ли возможно)
С помощью браузера и написанного на коленке скрипта, я могу p2p позвонить знакомому по webrtc, без всяких скайпов.
Окей, что-то такое анонсировали, как минимум в Mozilla. И как это сделать? Что для этого нужно знать, куда нажать и что куда ввести?
И делается это движением мизинца правой ноги.
Вы сильно утрируете. Хотя в целом такое и правда возможно, для создания веб-приложения не нужен сервер, можно работать и локально, и даже делать импорт/экспорт в файлы, и использовать прикольные штуки вроде Indexed DB, WebSQL и Local Storage.
При этом все это очень быстро работало на мобильных процессорах того времени (200-500 МГц), 64-128 МБ памяти.
Но глючновато, винмобайл часто любил зависать наглухо.
Кстати, а почтовые клиенты прошлого умели передавать файлы больше 100мб? а 10Гб? Сейчас это на уровне средних потребностей.
Ну не перегибайте, ни раньше, ни сейчас почтовые клиенты для передачи подобных файлов не используются. И проблема тут не столько в клиенте (дайте ему достаточно памяти и времени, он вполне себе сжуёт такой файл), сколько в ограничениях на размер вложений у почтовых сервисов. Что касается самой возможности обмена крупными файлами, то она не слишком-то и изменилась, единственное, сейчас у вас будет файлообменник с веб-мордой, а двадцать лет назад у вас был бы файлообменник с FTP-клиентом. И дисковая квота, конечно, с поправкой на размеры файлов тех лет :)
Технологии вроде бы как не изменились, но пользовательский опыт — очень сильно.
Почему, кстати, досихпор не видно отдельных нативных почтовых программ способных автоматически передавать большие файлы вложений через файлообменники?
Почему же? вот совсем недавно отправлял фото для печати в онлайн-сервис, почта… 5Гб.
Ну а я так ни на одном из своих ящиков не смогу. И никто из тех пользователей, у кого нет специального корпоративного ящика с отсутствием лимита на вложения, так не сможет. Gmail сейчас имеет лимит на вложения 25 мегабайт. Mail.ru — 20 мегабайт. И подобные лимиты практически везде. У вас это редкое исключение, связанное с профессиональной деятельностью.
Почему, кстати, досихпор не видно отдельных нативных почтовых программ способных автоматически передавать большие файлы вложений через файлообменники?
Кстати, идея очень даже неплохая :)
Да, если все вокруг пользуются GMail'ом и GDisk'ом — то это работает. Но шаг вправо, шаг влево… и нет больше прозрачности…
один робот мне ответил что их предел 25Мб,
второй — что 20,
один человек — «шлите все только в pdf, картинки не открою»
и двое — «приложенные ссылки гуглдиска не открываются, шлите только вложением»
и это при том что мобильный клиент гугла умеет напрямую с интернет-диска гугла же только ссылки шарить (хорошо что наоборот еще отключить не догадались — с приложения гуглдиска можно отправить письмо с вложением)
так что «вжжух и ушло» — это несмотря на 2018 ситуация до сих пор из серии «любой каприз за ваши деньги»
Google Drive запрещён как файлообменник.
А для чего он тогда создавался, для личного архивирования? Там вроде в пользовательском соглашении ничего нет про запрет передачи ссылок.
В целях безопасности у многих сотрудников там вообще интернета нет.
Чтобы не слили данные по операциям (соблюдение банковской тайны)? Разумно. Но у кого совсем нет интернета, там и почты не будет. А у кого интернет есть, те обычно к особо секретным базам и не допущены (отдел по работе с клиентами какой-нибудь).
Почта с внутрикорпоративного сервера работает. Через почтовый клиент типа Outlook или Lotus.
Нет, ну это для компании логично. Я имел в виду, у кого нет физически доступа в сеть. То есть значит сеть есть, но лишь локальная, нет именно интернета? Я просто уже привык, что это синонимы, сорри.
Зачем отделу по работе с клиентами интернет?
Например, чтобы работать с CRM. Хотя скорее всего, она тоже локально развёрнута, в интрасети.
А ещё чтобы уточнить детали тарифа/услуги, хотя наверное для этого у сотрудников стоит специальный справочный софт, не нужно даже корпоративный сайт открывать.
Почему, кстати, досихпор не видно отдельных нативных почтовых программ способных автоматически передавать большие файлы вложений через файлообменники?
Thunderbird умеет. Outlook тоже умеет.
Вспомните, какой прорыв в голосовой связи через интернет произвёл скайп. Который не надо настраивать, не надо вручную прокидывать какие-то там порты в NAT(ещё одно страшное слово для пользователей) и куда-то вводить адрес прокси-сервера. Он просто работает. Запустил и работает. В этом плане потребности пользователей уменьшились, они хотят и получили заветную кнопку «сделать всё хорошо».
То есть пользователь, конечно, не обязан становиться разработчиком и даже админом. Но всё-таки… Хоть для себя-то какой-то кайф получить от того, что сделал, настроил, и оно заработало в итоге
Моё разочарование в софте