Обновить
40

Пользователь

16
Подписчики
Отправить сообщение

Почему UFW не спасает от Docker: анатомия сетевой подставы и что ищут боты в открытых портах БД

Уровень сложностиСредний
Время на прочтение25 мин
Охват и читатели115K

Типичная картина при переезде на свежий VPS. Подняли чистую Ubuntu или Debian под новый проект, сразу навели базовый порядок: ufw default deny incoming, снаружи оставили только 22, 80 и 443. Глянули ufw status — всё четко, лишнего не торчит. Дальше ставится Docker, через компоуз взлетает бэкенд с PostgreSQL и Redis. Чтобы удобно ходить в базу с ноута через DBeaver и гонять миграции, на автомате дописываем ports: - "5432:5432". Кажется, что мы в домике: наружу ничего не светит, фаервол же режет всё, кроме веба и SSH.

А через пару дней прилетает абуза от хостера или срабатывает алерт в мониторинге: все ядра в полке, в htop резвится какой‑нибудь kdevtmpfsi или kinsing, а вместо таблиц в базе лежит одна записка README_TO_RECOVER с биткойн‑кошельком. Грабли старые, как сам Docker. Но на них с завидной регулярностью наступают и джуны, и вполне опытные админы, привыкшие доверять выводу ufw status.

Разобрать анатомию подставы

125 токенов в секунду на RTX 4070 Ti SUPER: как я заставил локальную LLM работать полноценным кодинг-агентом

Уровень сложностиСложный
Время на прочтение5 мин
Охват и читатели112K

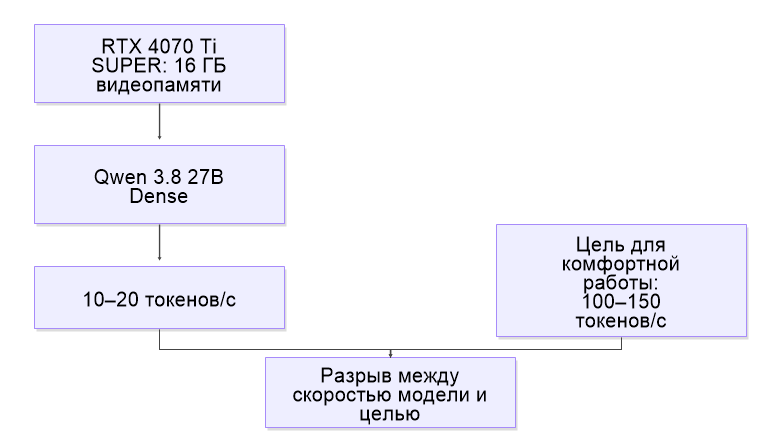
По статистике, среди рядовых пользователей настольных компов самая распространенная видеокарта имеет 16 ГБ видеопамяти. По опросам GaugeDB, такие карты занимают 27,21% рынка. У меня как раз видеокарта NVIDIA GeForce RTX 4070 Ti SUPER с 16 ГБ видеопамяти GDDR6X, которая на текущий момент стоит 900$. До сего момента главной проблемой было то, что на видеокарте такого класса невозможно было запустить LLM-агента, который будет достаточно умным и достаточно быстрым. Если запускаешь умную модель типа Qwen 3.8 27B (Dense архитектура), то на выходе получаешь 10-20 токенов в секунду. А для комфортной работы кодинг-агента надо 100-150 токенов в секунду.

Читать далее

Мощный ИИ агент в 16гб VRAM

Время на прочтение8 мин
Охват и читатели107K

Недавно я обновил свою видеокарту до RTX-5060-TI 16GB. Получив новую карту я решил исследовать, что можно на ней запустить из нейросетей. Традиционно пишут, что нормальные ИИ модели начинаются с rtx3090 и выше, что ниже 24GB VRAM жизни нет. В этой статье я постараюсь развеять этот миф.

Читать далее

Более 100 000 вакансий: полный анализ IT‑рынка России в 2026 году. И почему hh.ru нас обманывает?

Время на прочтение19 мин
Охват и читатели116K

Привет, Хабр! (И тебе, IT-шник, который хочет разобраться, что в 2026 вообще здесь происходит? Сейчас разберёмся, но легче тебе от этого не станет).

Сегодня будем препарировать весь IT рынок России на более чем 100 тысяч вакансий со всевозможных площадок. По-настоящему полная и честная аналитика. С графиками, цифрами и верой в светлое будущее...

Здесь будет всё, зарплаты, актуальные стеки и то что уже никому не нужно, прогнозы, тренды, и многое другое, будет интересно...

Читать далее

Разработка цифрового радиолюбительского протокола на базе OFDM. PHY‑уровень

Уровень сложностиСредний
Время на прочтение53 мин
Охват и читатели18K

Статья посвящена разработке радиолюбительского протокола связи на базе OFDM (Orthogonal Frequency-Division Multiplexing). В ней рассматривается процесс создания физического уровня, сложности, с которыми пришлось столкнуться, а также его испытания в эфире.

Читать далее

Компилятор, который галлюцинирует

Уровень сложностиСредний
Время на прочтение12 мин
Охват и читатели11K

Начнем с простого. Вы скачали нейросеть, и теперь у вас на диске лежит файл на несколько гигабайт, внутри которого миллиарды чисел. Этот файл можно запустить и он будет делать всякие осмысленные штуки: писать текст, отличать котов от собак на фотографиях, переводить с китайского. То есть перед нами работающая программа. Только исходного кода к ней нет, и никогда не было.

Дальше в статье мы разберем идею, которая из этого же наблюдения и выросла. Она звучит так: а давайте напишем компилятор, который берет понятную человеку программу и превращает ее прямо в веса нейросети.

Звучит странно. Но чтобы понять, зачем это нужно и почему это красиво, придется сначала заглянуть в обычные компиляторы и немного в азы ИИ. Без них дальше будет непонятно.

Читать далее

Фильтрация ТСПУ у серверов Таймвеб Cloud: диагностика, обход через reverse-proxy и СDN

Уровень сложностиСредний
Время на прочтение7 мин
Охват и читатели40K

Два коммерческих сайта на WordPress, оба на одном VPS. Клиенты в одном городе, я сам в другом.

Начало июня. Клиенты жалуются, что сайт не открывается без VPN.

Мало ли, подумал я — ограничения, белые списки и т.д.

Потом сайт перестал открываться у меня. По проводу. Дома.

Три дня был потный танец с бубном:

Читать далее

Невыносимая слопность бытия

Уровень сложностиСредний
Время на прочтение32 мин
Охват и читатели26K

Эта статья выросла из одного моего комментария в качестве читателя об ИИ-слопе, возникшей после этого дискуссии с писателями и редакторами, переросшей во взаимное минусение друг-друга с высунутыми языками и последовавшего затем всеобщего успокоения.

Далее мой взгляд на проблему со стороны читателя, попытка перевести все в конструктивное русло и небольшое исследование для технического решения проблемы.

Читать далее

Английский вместо кода

Уровень сложностиПростой
Время на прочтение17 мин
Охват и читатели45K

Язык, который придумали, чтобы программисты стали не нужны, породил профессию, которая жива до сих пор и неплохо оплачивается, а другой язык назвали "структурированным английским", и думали, что на нем сможет писать любой бухгалтер, и он тоже породил новую специальность со своей зарплатной вилкой. А еще была попытка сделать "программирование без программистов к двухтысячному году", но и он дал обратный результат.

Думаю вы узнали COBOL, который по сей день ежедневно эксплуатируется и по разным оценкам стоит за 80% обычных (магазинных) банковских транзакций, а его кодовая база тянет на пару сотен миллиардов строк и до сих пор кормит десятки, если не сотни тысяч разработчиков. Правда, если копнуть эти красивые цифры, почти все они восходят к одному опросу конца девяностых, который потом бесконечно переэкстраполировали на весь мир, так что честнее считать их порядком величины, а не точными данными.

SQL породил особую касту DBA (Database Administrators) и Data Engineers и сегодня человек, который пишет "простые запросы", может легко зарабатывать на уровне мидла, а сам язык стал настолько сложным, что современные диалекты (PostgreSQL, Oracle) - это полноценные языки программирования с процедурной логикой, где можно написать всё что угодно, от генератора фракталов до игрового движка.

Семейство 4GL оказалось "золотой клеткой" и прекрасно работали, пока нужно было сделать типичную форму "ввод-вывод", но как только требовалась нестандартная бизнес-логика или интеграция с внешним сервисом, инструмент упирался в свои границы и программистам приходилось дописывать "костыли" на низкоуровневых языках, что превращало разработку в адский коктейль из визуального дизайна и грязных хаков. И вместо исчезновения программистов, 4GL создали "архитекторов корпоративных систем", которые (например, SAP ABAP), стали невероятно дорогими специалистами, и тоже не устранил программирование, а просто переместил его из зоны "универсальных языков" в зону "дорогих и капризных инструментов", привязывающих компанию к конкретному вендору.

Каждые десять-пятнадцать лет индустрия торжественно объявляет, что писать код руками больше не придётся, продавая новый способ "объяснить машине задачу на нормальном человеческом языке". И каждый раз через несколько лет выясняется, что программистов стало не меньше, а больше, просто теперь они называются иначе. Предположу, что сейчас мы проживаем очередной виток этого цикла, и новое название таким людям будет вайбкодеры, и думаю этому инструменту, уготована та же судьба, что и у предыдущих попыток.

Читать далее

habrGPT. Обучим LLM 0.5B с нуля на статьях Хабра с помощью nanochat от Карпатого. Обучение fp8 дома и сравнение с bf16

Время на прочтение17 мин
Охват и читатели36K

Раскрученный проект nanochat обещает "за $100 обучите свой ChatGPT". В оригинале обучение на 8xH100 80Gb, но никто не мешает обучить его на домашнем и более слабом железе. Попробуем обучить LLM с нуля на статьях Хабра, чтобы посмотреть хватит ли там материала, чтобы модель хотя бы смогла связать пару слов.

Читать далее

Как на самом деле работают LLM

Уровень сложностиСредний
Время на прочтение22 мин
Охват и читатели36K

В статье подробно рассматриваются принципы работы больших языковых моделей (large language model, LLM). Поскольку в основе большинства современных LLM лежит архитектура трансформера (transformer), ее понимание дает представление о ключевых механизмах, обеспечивающих работу таких моделей.

В этой статье мы разберем ключевые принципы работы современных LLM, построенных на архитектуре трансформера. Я постараюсь объяснить основные идеи без погружения в сложную математику. Конечно, для глубокого понимания темы математическая база важна, но для первого знакомства этого материала должно быть достаточно.

Читать далее

Зачем мне фото- и видеоредакторы с GUI, когда есть FFmpeg?

Уровень сложностиПростой
Время на прочтение17 мин
Охват и читатели19K

...или записки из палаты Линуксоида

Часто ли вам пригождается базовая обработка фото или видео? Понизить разрешение, вырезать область, нанести текст, перекодировать в другой формат и другие задачи. Раньше я пользовался для этих целей самыми разными средствами - загрузка в веб-редакторы, Paint, Photoshop, Sony Vegas.

Пока в один прекрасный момент не пересел на Linux...Удобного видеоредактора для себя не нашёл, а к рабочему процессу в командной строке и установке через dnf install уже привык (я использую Fedora). И понеслась...

Внутри - интересная справка по FFmpeg. Ничего лишнего, максимум примеров с визуализацией и компактными объяснениями. Покажу, какие задачи можно решать с помощью этого инструмента не выходя из командной строки - а таких очень много. В конце - личный опыт: зачем мне эта шизофрения понадобилась и что она мне дала.

Увидеть нестандартный workflow

Почему не взлетели дирижабли? Часть 20: как воздушные корабли ВДВ СССР служили на полях Великой отечественной

Уровень сложностиПростой
Время на прочтение8 мин
Охват и читатели20K

Прошлый рассказ мы завершили в начале 1942 года. Амбициозный план высадки 4-го десантного корпуса под Вязьмой, чтобы окружить изрядную часть немецкой группы армий «Центр», потерпел трагическую неудачу. Советские ВДВ понесли тяжёлые потери, и нужно было срочно готовить новых десантников на смену павшим. Для обучения каждый новобранец должен был совершить немало прыжков с парашютом; до войны для этого использовали самолёты, но после потерь 41-го транспортники были дефицитом, нужным для ещё более приоритетных задач. И тогда было решено направить на помощь ВДВ советских воздухоплавателей, в распоряжении которых были небольшой дирижабль СССР В-12 «Победа», крохотный «Малыш» и десятки аэростатов. Центр подготовки парашютистов по новой методике развернули в Долгопрудном — сердце советского дирижаблестроения. Так воздушно-десантные силы оказались единственной ветвью советской военной машины, имевшей в своём составе дирижабли. Этим машинам и их экипажам пришлось немало потрудиться в годы Великой Отечественной, чудом уцелеть под огнём и даже... поохотиться на лосей.

Читать далее

Почему не взлетели дирижабли? Часть 17: трест «Дирижаблестрой» и Нобиле в СССР

Уровень сложностиПростой
Время на прочтение9 мин
Охват и читатели17K

После возвращения в Италию Умберто Нобиле столкнулся с нарастающей неприязнью руководства страны и вооружённых сил, включая лично Муссолини. Строить дирижабли на родине для него стало невозможным. В то же время в СССР, где Нобиле уже побывал по пути на полюс на «Норвегии» и сохранил самые лучшие впечатления, всерьёз задумались о собственной программе дирижаблестроения. Не просто задумались: с осени 1930 года, когда в Москву прилетал огромный немецкий «Граф Цеппелин», и массы, и руководство страны буквально охватила дирижаблемания. Поскольку Нобиле уже бывал в СССР и произвёл при этом самое лучшее впечатление, его решили пригласить в качестве главного консультанта по строительству воздушных кораблей.

Читать далее

Как математика стала такой абстрактной?

Уровень сложностиСредний
Время на прочтение17 мин
Охват и читатели26K

Сегодня математика считается крайне абстрактной наукой. На форумах наподобие Stack Exchange опытные математики насмехаются над новичками, просящими понятных объяснений эзотерических математических концепций, а постоянные попытки привязать основы математики к реальности стали визитной карточкой онлайн-сумасшедших.

Мне кажется это ироничным: тысячелетиями математика оставалась более-менее естественной наукой. У нас не было философского объяснения тому, почему 2 + 2 должно быть равно 4. Мы просто наблюдали происходящее вокруг нас и пытались вывести правила. Абстракции были важны, но они обязательно должны были обосновываться объективной реальностью. Согласованности аксиом было недостаточно: углы нашего гипотетического треугольника должны были соответствовать углам в реальном мире.

Читать далее

Считаем логарифмы в уме

Уровень сложностиПростой
Время на прочтение10 мин
Охват и читатели30K

В 1957 году писатель-фантаст Роберт Хайнлайн так представлял себе людей XXI века: «Делала перерасчет прочности гидропонических оранжерей, но выходило с ошибками. Дважды забывала логарифмы, так что пришлось лезть в таблицу».

Однако наша цивилизация выбрала другую ветку развития — и в нашей версии XXI века все за человека делают машины: от сложения двузначных чисел до написания статей на Хабре. Считать в уме, а уж тем более помнить наизусть логарифмы — звучит, как не самая востребованная сверхспособность.

Зато, чтобы обрести эту сверхспособность, не требуются укусы радиоактивных пауков — достаточно просто прочитать эту статью, а уж пригодится ли в жизни — решайте сами. Может быть в нужный момент калькулятора под рукой не окажется, а может быть просто захочется произвести впечатление на коллег небрежно брошенной фразой: «Корень седьмой степени из пяти это примерно 1,25». Хотите научится быстро считать? Тогда добро пожаловать под кат!

Читать далее

Вы не сможете это развидеть: краткий гайд по определению LLM-текстов на Хабре

Уровень сложностиСредний
Время на прочтение25 мин
Охват и читатели47K

Но сейчас я вижу то, что я не просто не люблю, я ненавижу — нейрослоп. Это статьи, которые полны логических ошибок, не отвечает на вопрос заданный в заголовке, с кучей воды. Это не просто дно копирайтинга, это "снизу постучали". Это не было бы проблемой, будь это плохие авторы. Плохие авторы конечны. LLM может генерировать гигабайты текста, только плати за токены, и весьма недорого — у меня есть несколько проектов, в которых LLM используется для NLP, и там ощутимые обьемы входа и генерации, и знаете сколько я потратил за все время существования этих проектов на работу и тесты? Долларов пять. Дешевый некачественный копирайтинг еще никогда не был ТАК дешев.

Возможно этот слоп замечательно индексируется, но я считаю что это путь в никуда для хабра как сообщества специалистов.
Потому что как только таких статей станет большинство — из сообщества уйдут те самые специалисты, просто потому что ну зачем им читать воду. Я закрываю эти статьи ровно сразу же, как только опознаю ИИ. Если их станет слишком много — я просто уйду. И чем больше уходит активных авторов, тем меньше становится интересных статей, и тем больше в процентном соотношении такой воды, тем больше уходит ядерная аудитория. Замкнутый круг.

Читать далее

Смирись: ты ненормальный

Уровень сложностиПростой
Время на прочтение10 мин
Охват и читатели177K

Я встречал много людей, которым не нравится их работа. И когда я их спрашиваю, чем бы они занимались вместо, около 75% из них отвечают что‑то вроде: «Хммм, не знаю. Я бы хотел открыть свою небольшую кофейню!» Если в тот день я в хорошем настроении, я задаю им встречный вопрос: «Тогда где бы ты взял кофейные зерна?»

Если они не знают что ответить, то я задаю ещё пару наводящих вопросов:

Читать далее

Вход — бесплатно, выход — по подписке: разбор реального скама

Уровень сложностиПростой
Время на прочтение16 мин
Охват и читатели23K

Сегодня у нас по‑своему уникальный разбор. Мы будем разбирать ещё идущую (на момент написания статьи) массовую криптоскам‑схему. В некотором роде автор статьи (то есть я) рискует, потому что обламывает ловким ребятам стотысячедолларовую схему по радостному отьему денежек у отрицательных счастливчиков!

Будет всё: имена, пароли, явки, количество обманутых прогретых инвесторов и объемы успешно проинвестированного. Спешите читать!

Разбираемся с криптоскамом

Вот такие пироги… Почему нам врут круговые диаграммы

Время на прочтение4 мин
Охват и читатели18K

Все мы видели круговые диаграммы. Их любят рисовать во всяких отчётах и презентациях. А ещё их очень любят авторы рекламных материалов и стоковых картинок: довольный «эффективный менеджер» с лучезарной улыбкой держит в руках распечатку графиков своего головокружительного успеха.

На первый взгляд может показаться, что круговая диаграмма — это отличный способ визуализации данных. Наглядно, красиво, высокохудожественно, современно. Однако у круговых диаграмм есть ряд проблем... При должном усилии их можно превратить в инструмент искажения данных. Но мы ведь хотим донести до наших читателей объективную информацию и не хотим её скрыть или исказить. Ведь правда?

Читать далее
1
23 ...

Информация

В рейтинге
5 630-й
Зарегистрирован
Активность