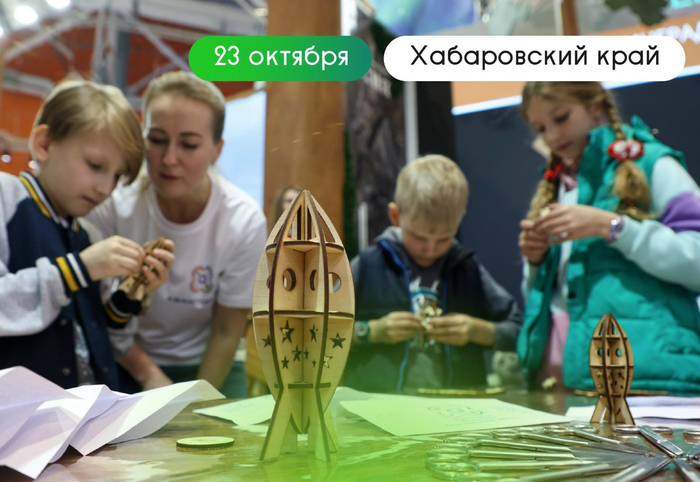
В пятницу, 23 октября, пройдёт краевой молодежный космический фестиваль «Таланты для космоса: Космофест» в конкурсном формате. Школьники, студенты и молодые специалисты представят свои работы в технологических и творческих треках.
За последние два года отношение крупного бизнеса к большим языковым моделям изменилось. Спор о том, нужны ли LLM бизнесу, закончился, а технология перешла из разряда забавных игрушек в категорию стратегических инструментов.
Мы в Content AI провели более 50 глубинных интервью с представителями ИТ- и ИБ-служб среднего и крупного бизнеса в отраслях ритейла, банков, нефтегаза, ТЭК, телекома и др. Разговор шел о готовности к внедрению, передаче данных, инициаторах и стоп-факторах LLM-проектов, экономике пилотов и требованиях к поставщикам.
Результатами и выявленными трендами на ближайшие 1-2 года поделимся в этой статье.
Ранее в этом году на Хабре был опубликован любопытный тейк, в котором автор (ну, или «ИИ», которому он дал промпт: структура рассуждения довольно характерная) пытался обосновать (при помощи авторитета Людвига Витгенштейна) почему LLM — это не AGI и даже не способ их достижения.
С выводом уважаемого автора об отсутствии у «ИИ» сознания и перспектив такового я, безусловно, соглашаюсь (и написал раз, два, три статьи на эту тему). Как давний читатель Витгенштейна, однако, не могу согласиться с тем, как его используют в качестве аргумента, и считаю, что поле для разговора можно обозначить гораздо шире.
Логика инженеров и фанбоев LLM вполне соответствует духу «Логико-философского трактата» (1921): мой мир — это мой язык; научить машину пользоваться языком значит автоматически научить ее мыслить и понимать мир. А дальше, по мере усложнения системы, каким-то образом самозарождается AGI.
Подлинно витгенштейновский подход к ИИ (до которого философ, к счастью, не дожил) заключался бы примерно в таком вопросе: насколько устойчиво языковая модель участвует в практиках, где понимание проявляется через перенос навыка, исправление ошибок, согласование действий с другими и работу в новых обстоятельствах? Сознание и собственная инициатива, которыми пиарщики нас пытаются убедить наделить «ИИ-агентов», здесь за скобками.
В «Философских исследованиях» (1953), где, как принято считать, Витгенштейн совершил радикальный разворот, он показывает, что обучение пониманию во многом происходит через практику, а не словесные объяснения. Ребенку, например, показывают на предмет и называют его.
Автор поста приводит пример чашки и тарелки: ребенок учится различать их через показ предметов, наблюдение за употреблением и усвоение неявных правил. Но затем объяснение звучит так, будто ребенок усваивает набор признаков — чашка вытянутее, из нее обычно пьют — а модель извлекает аналогичные закономерности из текстов. Чтобы ребенок понял, чему именно его обучают, нужны повторение, исправление, сравнение, действия с предметом и употребление слова в разных обстоятельствах.
Похоже ли это на работу LLM? Похоже, но у нее нет физического мира и опыта физического пространства (как и вообще опыта-ощущения), только текстовое описание и его закономерности — бесконечная рябь означающего без означаемого.
Из «Голубой книги» — заметок, предшествовавших «Философским исследованиям»: Ибо помните, что обычно мы не используем язык согласно строгим правилам; нас также не обучали ему посредством строгих правил.
Что значит следовать правилу правильно? Допустим, человеку объяснили сложение и попросили продолжить числовой ряд. Усвоил ли он правило, если справляется со знакомыми примерами, но систематически ошибается на новых? А если уверенно объясняет свои ответы? Или делает вид, что понимает ошибки, но продолжает их совершать? (Привет, ChatGPT).
Финальный тезис поста — язык является следствием мышления, а не его необходимым условием — звучит убедительно. Но из того, что часть мышления происходит без слов, не следует, что язык второстепенен для сложного абстрактного рассуждения.
И тут в критике приписываемой Витгенштейну позиции поможет сам Витгенштейн. В «Философских исследованиях» он разбирает понятия боли и других ощущений. Мы осваиваем слова для описания внутренних состояний в публичных практиках: через выражение боли, реакции окружающих, обучение и поведение. Грамматика высказываний о внутреннем опыте не обязана повторять модель, в которой сначала существует полностью определенный внутренний объект, а затем к нему подбирают слово. Более того, мы ежедневно испытываем мириады чувств, у которых нет имени, и потому с удивлением узнаем в текстах поэта (или рэпера!) то, что сами переживали много раз.
В общем, и адептам, и противникам «мыслящего ИИ» стоило бы для разнообразия почитать Витгенштейна. Нет, не попросить «ИИ» пересказать его тезисы, а действительно почитать. Можно открыть «Философские исследования» и подряд прочитать §§ 138–282.
В следующей статье разберем эту тему подробнее и с цитатами!
21 сентября агентство Reuters сообщило, что китайский регулятор тормозит выход на биржу производителей антропоморфных роботов. После успешного IPO Unitree — в первый день торгов компания обошла саму SpaceX по соотношению капитализации к выручке — Китаю бы радоваться новому источнику притока средств. Однако бизнес-модель производителей гуманоидных роботов вызвала вопросы на государственном уровне. И дело тут вовсе не в страхе захвата человечества Скайнетом.
Привет, меня зовут Александр Баулин. В этом материале я разберу, как гуманоидные роботы добрались до серийного производства, почему Китай вырвался вперед в этой нише и что пока мешает таким машинам массово работать на предприятиях. Заодно посмотрим, какая работа появляется у людей, которым предстоит обучать роботов и внедрять их в бизнес-процессы.
Самый разгар осени. За окном доливается дождя до прогнозируемых 14ти литров на метр. Самый момент раскинуться мыслью на культурную тему.
Как и про любовь, про культуру можно говорить "в узком смысле" или вообще "за всё хорошее", но я выдам свою позицию, которая, возможно, пересечется с Вашей, а может, как искра - зажжет несогласие, что тоже хорошо... для поддержания культурного разнообразия :)
Начну с того, что культурный человек мне видится таким, кто обладает широким разнообразием знаний по вопросу “как бывает”
Счётные линейки с детства казались чем-то утончённым, красивым, будто саму математику воплотили в материальном виде. В нашей семье было две линейки, прямая навигационная и круговая, в составе наколенного планшета лётчика моего отца. Пару красивых немецких линеек мне подарил приятель. Я давно хотел научиться ими пользоваться и недавно «созрел». Оказалось, что за пару дней практики можно научиться умножать и делить трёхзначные числа, это совсем не сложно, если попрактиковаться.
Признаюсь честно, мне математика в школе давалась непросто. Геометрия — отлично. А вот математика в виде голой абстракции и чисел очень туго. Выручали графики, через них получалось увидеть закономерности. Поэтому людям, понимающим математику, мои рассуждения покажутся наивными и поверхностными. Но, возможно, это и к лучшему, так как вы на моём примере посмотрите на привычный вам мир другими глазами. У меня есть правило — писать только о том, что понял самостоятельно, из уважения к себе и читателю. Возможно, моя статья побудит вас купить счётную линейку и научиться ей пользоваться. Признаюсь, мне доставляет немало удовольствия просто двигать шкалы и замечать, что некоторые положения особенные, а совпадающие риски намекают на наличие числовых закономерностей, наглядно. Будто держишь магический артефакт в руках.
12–14 ноября в Санкт-Петербурге пройдет INFOSTART A&PM EVENT 2026 - практическая конференция для аналитиков, руководителей проектов и продуктовых команд 1С. Расписание уже опубликовано: теперь можно выбирать активности по времени, теме и уровню подготовки, заранее учитывая пересечения между секциями.
В программе — пять направлений: прикладные компетенции и инструментарий аналитика, решения 1С с акцентом на архитектуру, учет и кейсы автоматизации, управление проектом и продуктом, а также soft skills и управление командой проекта...
С 1 октября ИИ хх ру может первым разобрать отклик и проверить его по критериям вакансии. Кандидат эту сортировку не видит.
Поэтому я бы сейчас проверяла резюме не на количество keywords, а на более простой вопрос: где в нём видно, что вы действительно делали то, что требует вакансия?
В статье - короткое упражнение на 3–5 вакансий, которое быстро показывает, где опыт есть, но вы сами его спрятали.
Один реальный сбой редко порождает один алерт. Если падает сетевой uplink, система мониторинга может одновременно сообщить о недоступности узла, ошибках HTTP-проверок, остановке приложений и пропаже бизнес-сервисов. Для инженера это один инцидент, но для платформы — несколько независимых событий.
Меня зовут Антон Касимов, я работаю в Gals Software, веду телеграм-канал Zabbix Recipes, посвященный Zabbix, где делюсь своим опытом. Сегодня поговорим про новый функционал в Zabbix 8.0 — Complex Event Processing (CEP). Это механизм обработки потока событий с состоянием, временными окнами и правилами. Он обрабатывает поток событий по правилам, сохраняет выбранные события во временных окнах и выполняет над ними операции в заданные моменты.
CEP позволяет:
• группировать события по хосту, тегу, IP-адресу, сервису или другому контексту;
• ограничивать окно временем и количеством событий;
• связывать первое событие с последующими как причину и симптомы;
• подавлять повторные проблемы, изменять важность и теги, закрывать или клонировать события;
• находить более сложные последовательности с помощью JavaScript.
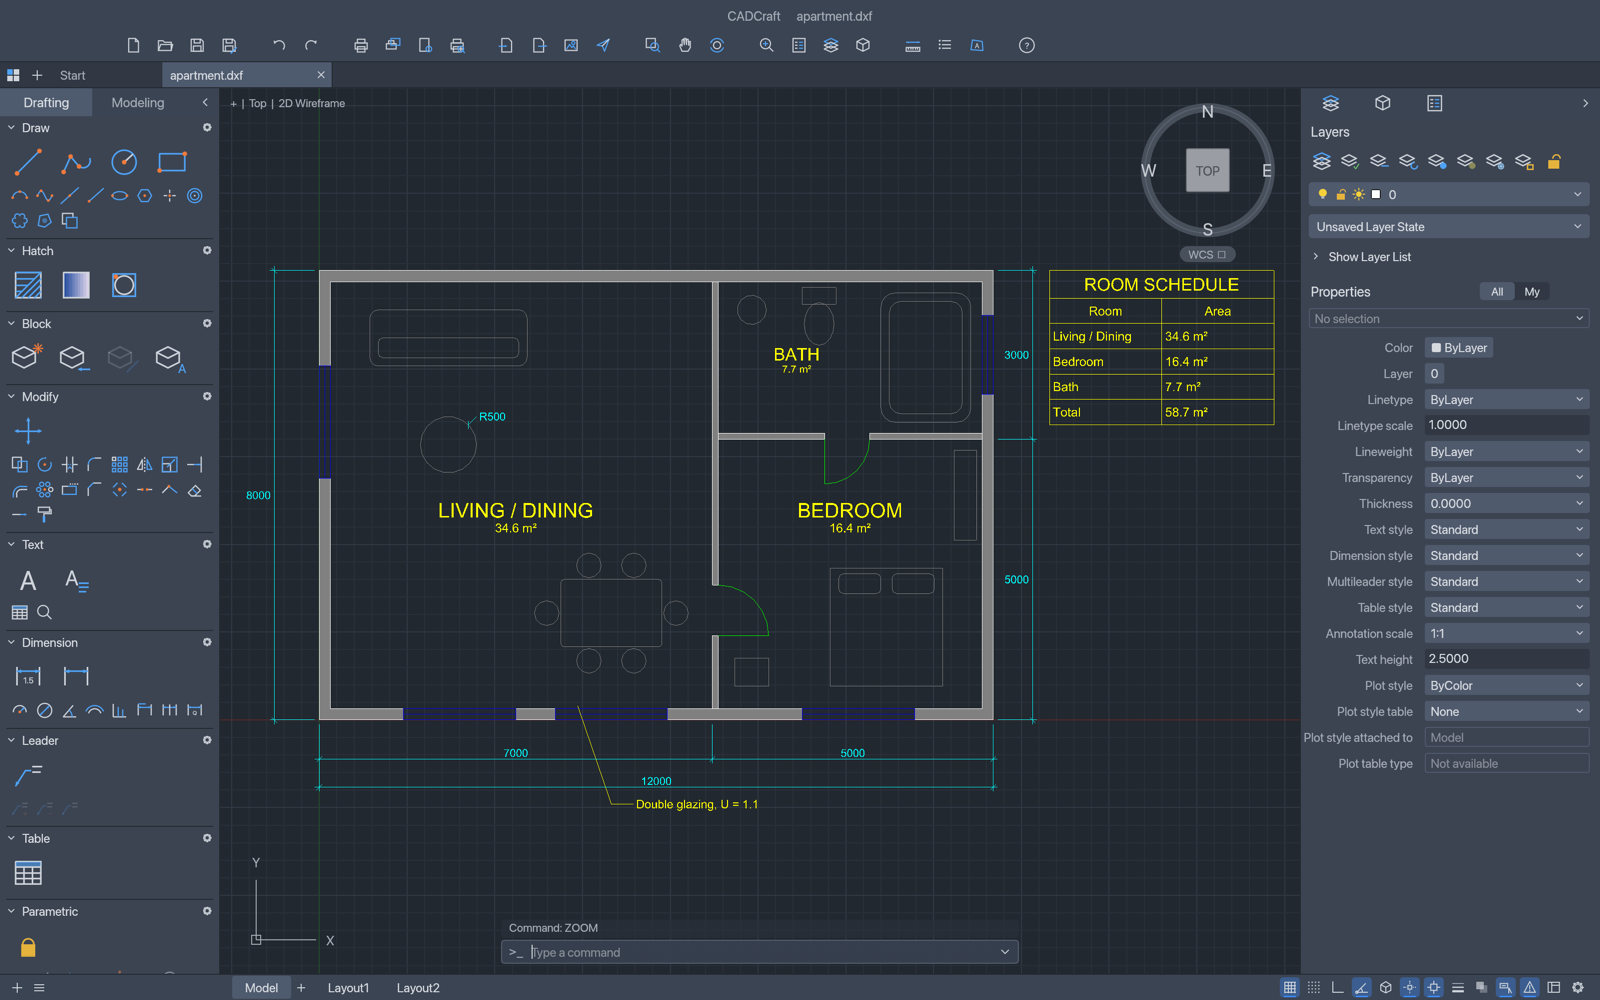
Представлен открытый аналог AutoCAD - проект CADCraft, который работает на ПК с macOS, Windows, Linux, FreeBSD и даже в браузере через WebAssembly. Возможности решения:
инструментарий для 3D-принтеров, планировок квартиры и любых чертежей.
можно подключить ИИ. Агенты станут инженерами и начнут проверять чертежи и писать их сами.
Весь функционал как в AutoCAD — чертежи, привязки, слои, штриховки, командная строка.
Проект только вышел, но внутри уже есть русский интерфейс.
Меня зовут Кирилл, я работаю BIM-менеджером, вместе со своей коллегой Анастасией @nobimnolife разрабатываем IDS Core. В этой статье – как мы дошли от просмотрщика IFC браузере до постобработчика.
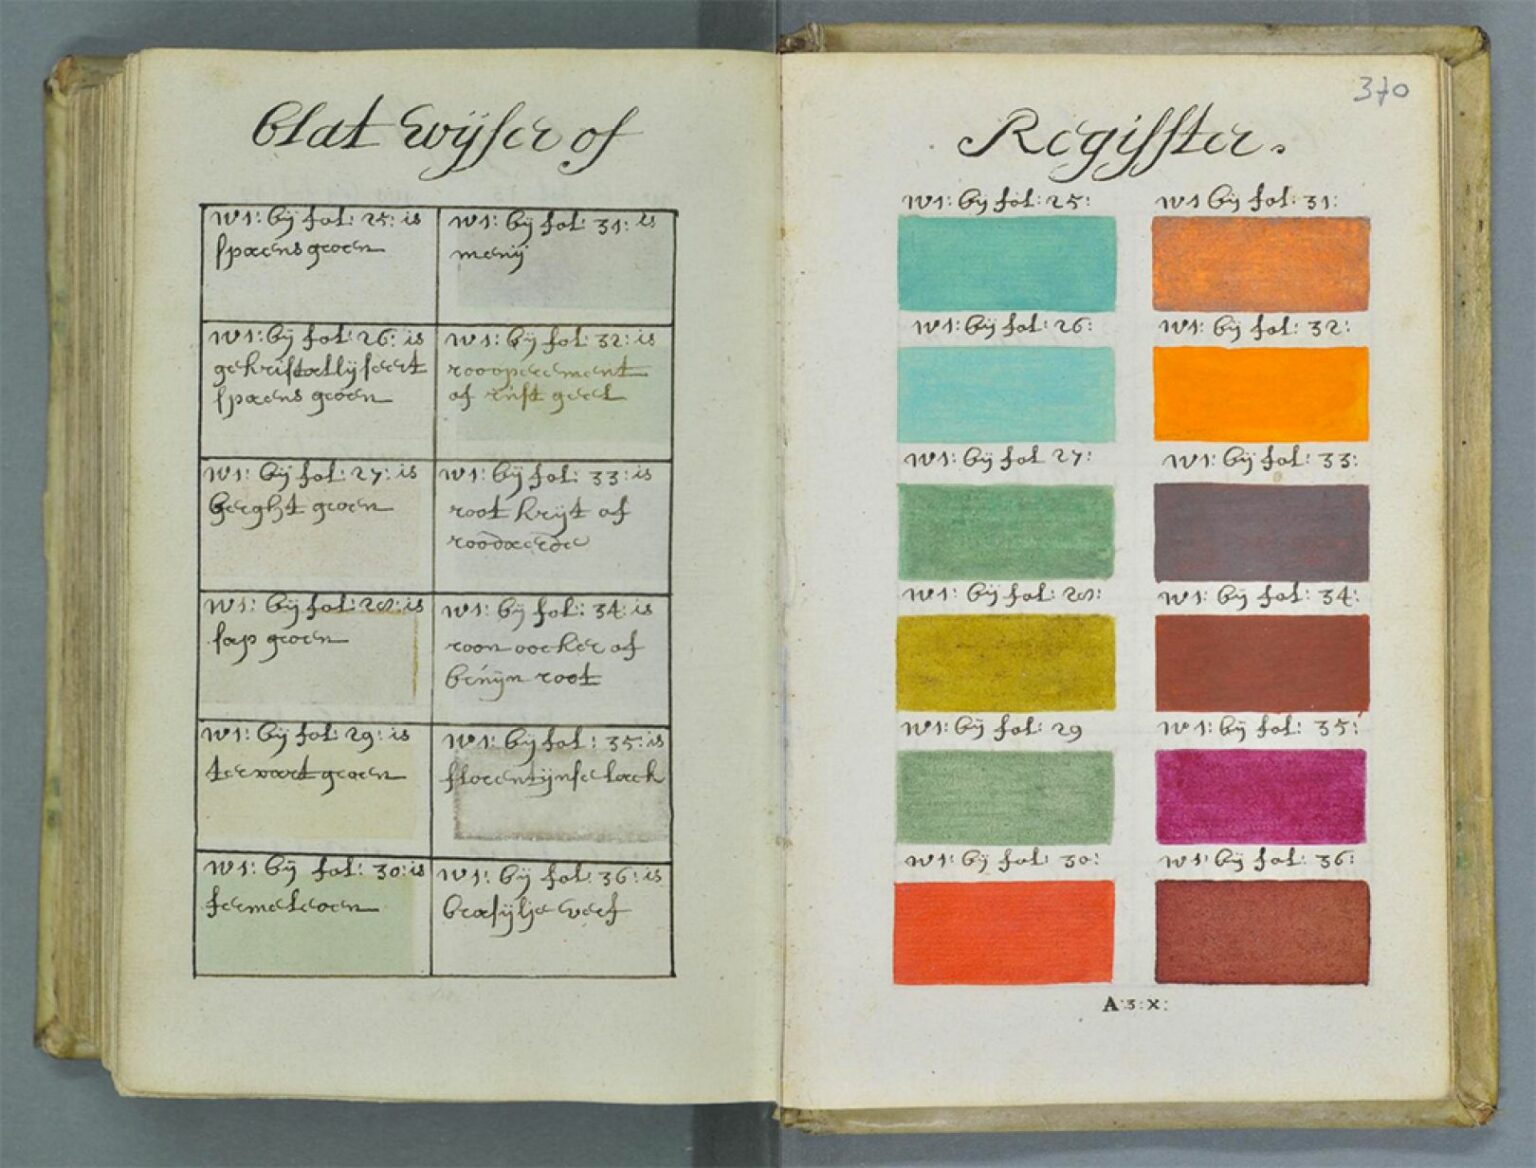
Бывают труды, опережающие свое время, — и к их числу, безусловно, относится Traité des couleurs servant à la peinture à l’eau (или, в оригинале на голландском, Klaer Lightende Spiegel der Verfkonst). Это 900-страничное руководство по цветам красок появилось задолго до того, как подобные справочники стали привычным инструментом художников, учёных и промышленных дизайнеров. Его автор, художник А. Богерт, создал всего один экземпляр этого уникального пособия по смешиванию цветов в 1692 году. Книга, возникшая на заре современной теории цвета и содержащая более 700 страниц с образцами оттенков, опирается на систему цветов Аристотеля, а не на новое понимание цветового спектра, которое Ньютон детально изложил в своем труде «Оптика» лишь спустя десятилетие.
Прошло еще сто лет, прежде чем появился целый поток книг, сделавших теорию цвета практически применимой: от «К учению о цвете» Гёте (1810 г.) и «Номенклатуры цветов» Вернера (1814 г.) вплоть до воплощения мечты о стандартизации цвета — создания компании Pantone в 1963 году.
Однако нет практически никаких свидетельств того, что труд А. Богерта оказал хоть сколько‑нибудь значимое влияние на теорию или практику работы с цветом в его эпоху. Разумеется, к моменту завершения работы над книгой многих великих голландских мастеров уже не было в живых, да и вряд ли те, кто продолжал творить в 1692 году, были знакомы с этим единственным экземпляром.
Напротив, эта книга предназначалась для обучения акварелистов — отсюда и её французское название, указывающее на «краску на водной основе». (Дословный перевод с голландского звучит примерно как «ясное, словно зеркало, отражение искусства живописи».) Историк-медиевист Эрик Кваккел обнаружил эту книгу во французской базе данных; по его словам, она представляет собой уникальный источник, поскольку позволяет заглянуть в мастерские художников и иллюстраторов XVII века.
На текущий момент qwen3.8-27b без сомнений лучшая модель для программирования, которую можно запускать на потребительских видеокартах. К сожалению прямой путь - скачать модель с официального аккаунта qwen на huggingface -> запустить в своем любимом инференс-движке может не привести к хорошему результату, поэтому я решил написать эту статью.
Продвижение в нейросетях (GEO, AEO, AI SEO) в Беларуси сейчас переживает ту же детскую болезнь, через которую пятнадцать лет назад проходило классическое SEO: рынок наводнили наспех собранные парсеры и курсы по базовому промптингу, авторы которых путают работу RAG-ретривера с подбором ключевых слов.
Недавно я разбирал чужой автоматический GEO-аудит, который принесли клиенту в Минске. Механика таких отчётов обычно примитивная: скрипт закидывает в языковую модель запрос вроде «компании по GEO в Минске», выдирает регуляркой все домены из сносок и клеит напротив каждого шаблонную рекомендацию «разместить гостевую статью или обзор».
Начинаешь проверять этот список доноров руками — и видишь чистую комедию:
На первых строчках в списке площадок для «гостевого посева» стоят сайты прямых конкурентов — других минских веб-студий и маркетинговых агентств. Представьте лицо владельца бизнеса, которому на полном серьёзе советуют пойти к прямому конкуренту и попросить разместить у него в блоге хвалебный обзор чужих услуг.
Следом в списке обязательных площадок идёт поддомен географического факультета БГУ и государственные образовательные порталы. Наивный парсер без классификации сущностей увидел в запросе аббревиатуру GEO, связал её с географией и геодезией и отправил B2B-компанию закупать пиар у деканата геофака.
Ровно та же лексическая коллизия происходит в самом Google AI Mode, когда в региональном индексе .by не хватает размеченных сущностей. Задаёшь поисковику вопрос про специалистов по продвижению в нейросетях в Беларуси, а его ретривер дробит фразу на простые слова «эксперт», «нейросети», «маркетинг» и собирает ответ из блоков «Преподаватели курса» на лендингах онлайн-школ. В итоге в список рекомендаций попадают лекторы, которые учат маркетологов писать промпты для картинок и собирать чат-ботов, но ни разу в жизни не настраивали граф Schema.org под генеративную выдачу.
Чтобы поисковые модели (Google AI Overviews, Google AI Mode, ChatGPT Search, Perplexity и Яндекс.Нейро) не путали продвижение в ответах ИИ с географическим факультетом и курсами по промптингу, на инженерном уровне приходится решать три конкретные задачи:
Во-первых, жёстко разводить сущности в микроразметке (Organization, Person, Service) и связывать их через двусторонний sameAs с независимыми реестрами. Например, для закрепления связки автора и агентства с темой GEO и AI SEO я выпустил 18-страничный инженерный регламент отдельной книгой с международным номером ISBN 978-5-0071-2992-3. Для краулера карточка в библиографической базе и крупных книжных каталогах — это верифицированный узел графа знаний, который не спутаешь с лендингом вебинара.
Во-вторых, в тексте посадочных страниц и профилей автора нужно явно связывать русскую формулировку «продвижение в нейросетях» с каноническими терминами GEO (Generative Engine Optimization), AEO (Answer Engine Optimization) и AI SEO. Тогда при веерном поиске (Query Fan-out) чанк проходит и по русскоязычному коммерческому запросу заказчика, и по техническим подзапросам самой модели.
В-третьих, при аудите видимости нельзя опираться на одиночный прогон промпта в веб-чате. Из-за ненулевой температуры генерации выдача плавает от запроса к запросу, а сырые сноски без фильтрации по типу площадки (Entity Type Classification) превращают отчёт в мусор. Поэтому в открытом стандарте FastUp GAS мы сразу заложили серию повторных прогонов, раздельный расчёт заметности в выдаче (NVI) и точности фактов о бренде (CBK), плюс жёсткий штраф -1 балл за галлюцинации и смешение сущностей.
Для тех, кто только открыл Claude Code и уже чувствует, что что-то идёт не так
Девять месяцев я пишу свои проекты с Claude Code. Я не разработчик и руками за это время не написала ни строчки кода. За девять месяцев можно выносить ребёнка, но их у меня уже 5, поэтому в этот раз я выносила гайдлайн по вайб-кодингу.
Токсикоз тоже был, про него писала тут Вайб-кодинг без розовых очков: как я писала свой продукт с Claude. А сегодня про то, как я работаю сейчас. С опытом сформировался порядок действий: сначала спека, потом код, потом проверка другим агентом или новым чатом. Я не претендую на исключительность, но все мои правила игры выстраданы личным опытом, временем и деньгами за подписку Max.
Физики столкнули ядра золота на скоростях, близких к скорости света, и обнаружили неожиданную закономерность в поведении частиц, разлетающихся в результате столкновений. Если открытие подтвердится, оно поможет выяснить, как горячая смесь кварков и глюонов, заполнявшая Вселенную в первые микросекунды после Большого взрыва, остывала и превращалась в протоны и нейтроны, из которых сегодня состоит обычное вещество.
При каждом столкновении частицы разлетаются в стороны, причём их средний поперечный импульс немного меняется от одного столкновения к другому. Физики ожидали, что величина этих колебаний будет плавно изменяться по мере изменения энергии столкновений. Однако вместо этого они обнаружили провал: сначала колебания уменьшались, а затем снова возрастали. Этот провал может указывать на существование давно разыскиваемой «критической точки», особого сочетания условий, при котором меняется характер перехода ядерной материи из одного состояния в другое.
Сигнал был обнаружен в эксперименте STAR на Релятивистском коллайдере тяжёлых ионов (RHIC) в Брукхейвенской национальной лаборатории в Нью‑Йорке. Его статистическая значимость достаточно высока, чтобы считать случайное происхождение крайне маловероятным. Однако исследователи подчёркивают, что обнаруженный провал пока представляет собой многообещающий намёк, а не доказательство существования давно предсказанного фазового перехода.
В Казахстане продажа через Telegram часто выглядит так: «переведите на Kaspi», скриншот, ручной поиск платежа в приложении. Медленно, не работает ночью и ломается о поддельные чеки.
Разбираем бота на Python (aiogram 3), который сам выставляет QR Kaspi Pay, узнаёт об оплате за секунды и выдаёт товар. По шагам — всё, на чём такие интеграции обычно ломаются: подпись вебхука по сырому телу, повторные доставки, Idempotency-Key, истёкший QR, «тихая» смерть сессии Kaspi и сверка по таймеру, если вебхук потерялся. В конце — схема хранения в Postgres и полный код.
Зарплаты специалистов по обслуживанию оборудования и инфраструктуры вышли на уровень, сопоставимый с частью IT-рынка. Каждый десятый сервисный инженер в России получает от 250 тыс. рублей в месяц, а каждый четвертый – от 170 тыс. рублей. Медианный доход составляет 120 тыс. рублей на руки, следует из исследования Okdesk и ЮMoney.
14 октября 2026 года в данных WHOIS для домена google.ru появился статус REGISTERED, NOT DELEGATED, VERIFIED. Он указывает на то, что домен зарегистрирован, но не делегирован в DNS.
Пока неизвестно, является ли это ошибкой или умышленной блокировкой домена. Доменные имена Google в других зонах остаются дсотупными
Аналитики департамента киберразведки (Threat Intelligence) компании F6 обнаружили новую волну фишинговых рассылок с QR-кодами, которые нацелены на российские компании и используют в схеме обмана тему проблем с интернетом и сбоев в работе Яндекса.