Обновить
512K+

Python *

Высокоуровневый язык программирования

335,06
Рейтинг
Сначала показывать
Порог рейтинга
Уровень сложности

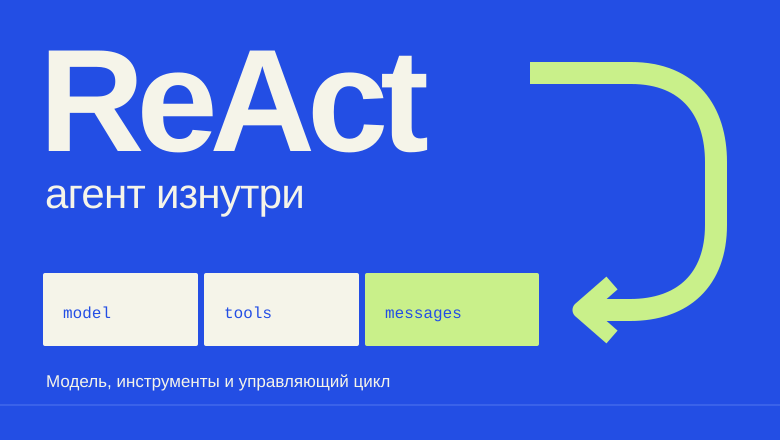
ReAct-агент изнутри. Модель, инструменты и управляющий цикл

Уровень сложностиПростой
Время на прочтение10 мин
Охват и читатели2

Как запрос языковой модели превращается в чтение файла или запуск команды? Разберем устройство ReAct-агента: кто выбирает действие, кто выполняет инструмент и как результат попадает в следующий запрос. Сначала посмотрим на схемы обмена, затем - на реализацию цикла на Python без агентных фреймворков. Код примера доступен на GitHub.

Читать далее

Новости

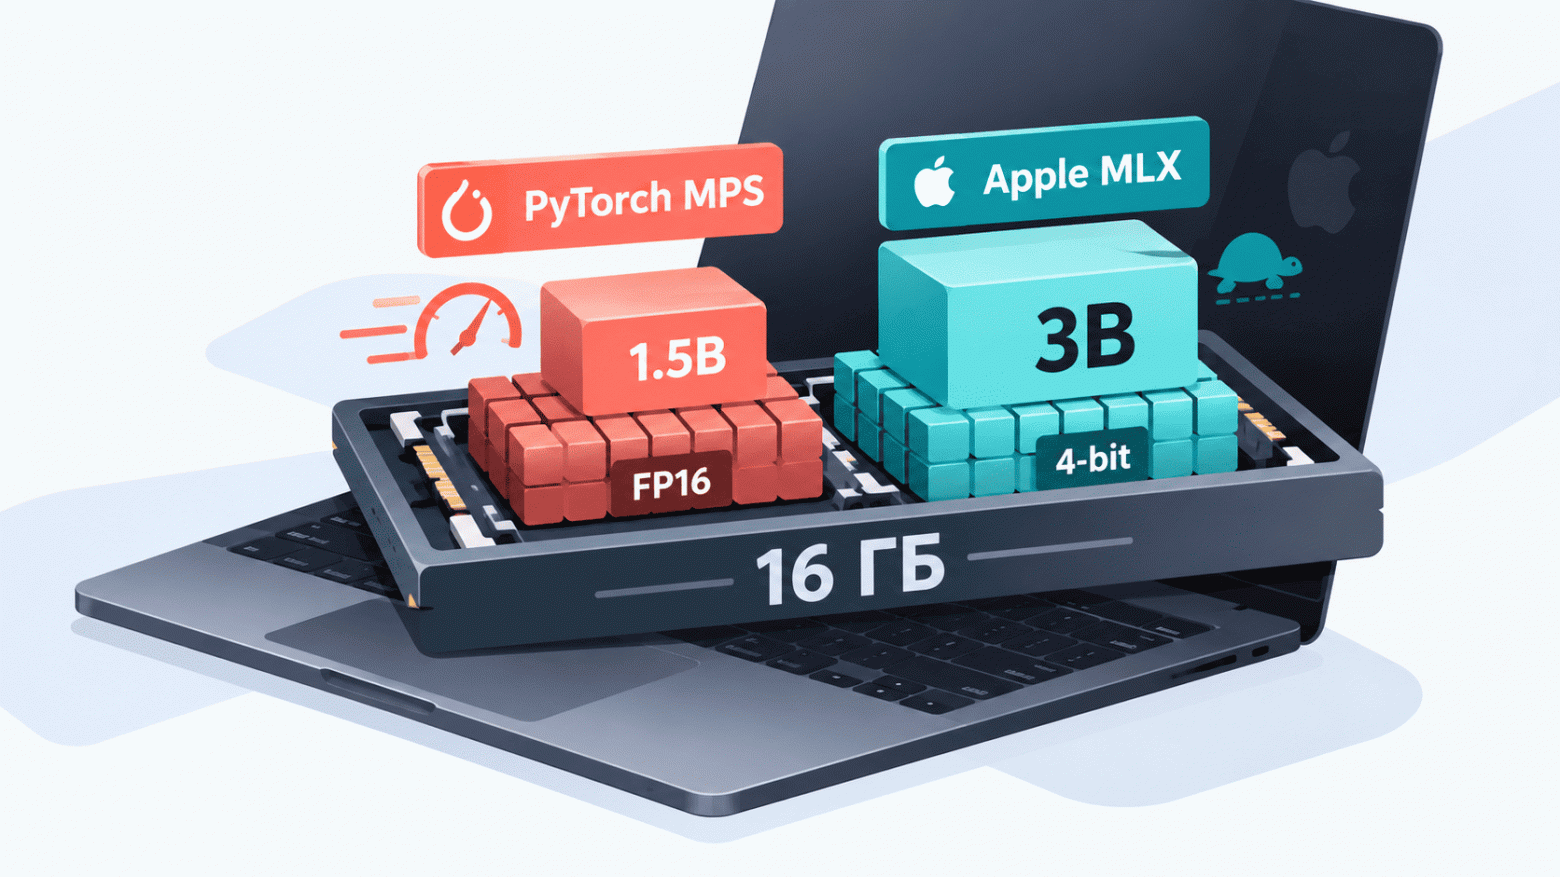
PyTorch MPS против Apple MLX: как дообучать LLM на Mac с 16 ГБ и что выбрать

Уровень сложностиСредний
Время на прочтение19 мин
Охват и читатели7.8K

Apple MLX создавался для эффективной работы с моделями на Apple Silicon, но при дообучении он может оказаться в несколько раз медленнее PyTorch MPS. Зато там, где MPS упирается в ограничения памяти, MLX позволяет запустить модель вдвое крупнее. Откуда берётся такой разрыв, насколько виновато квантование и какой стек выбрать для локального SFT? Ответы дают 10 запусков Qwen 2.5 с разными размерами моделей и длиной контекста.

Изучить бенчмарки

Как читать таблицу на 100 млн строк и не положить ни память, ни базу

Уровень сложностиСредний
Время на прочтение10 мин
Охват и читатели5.4K

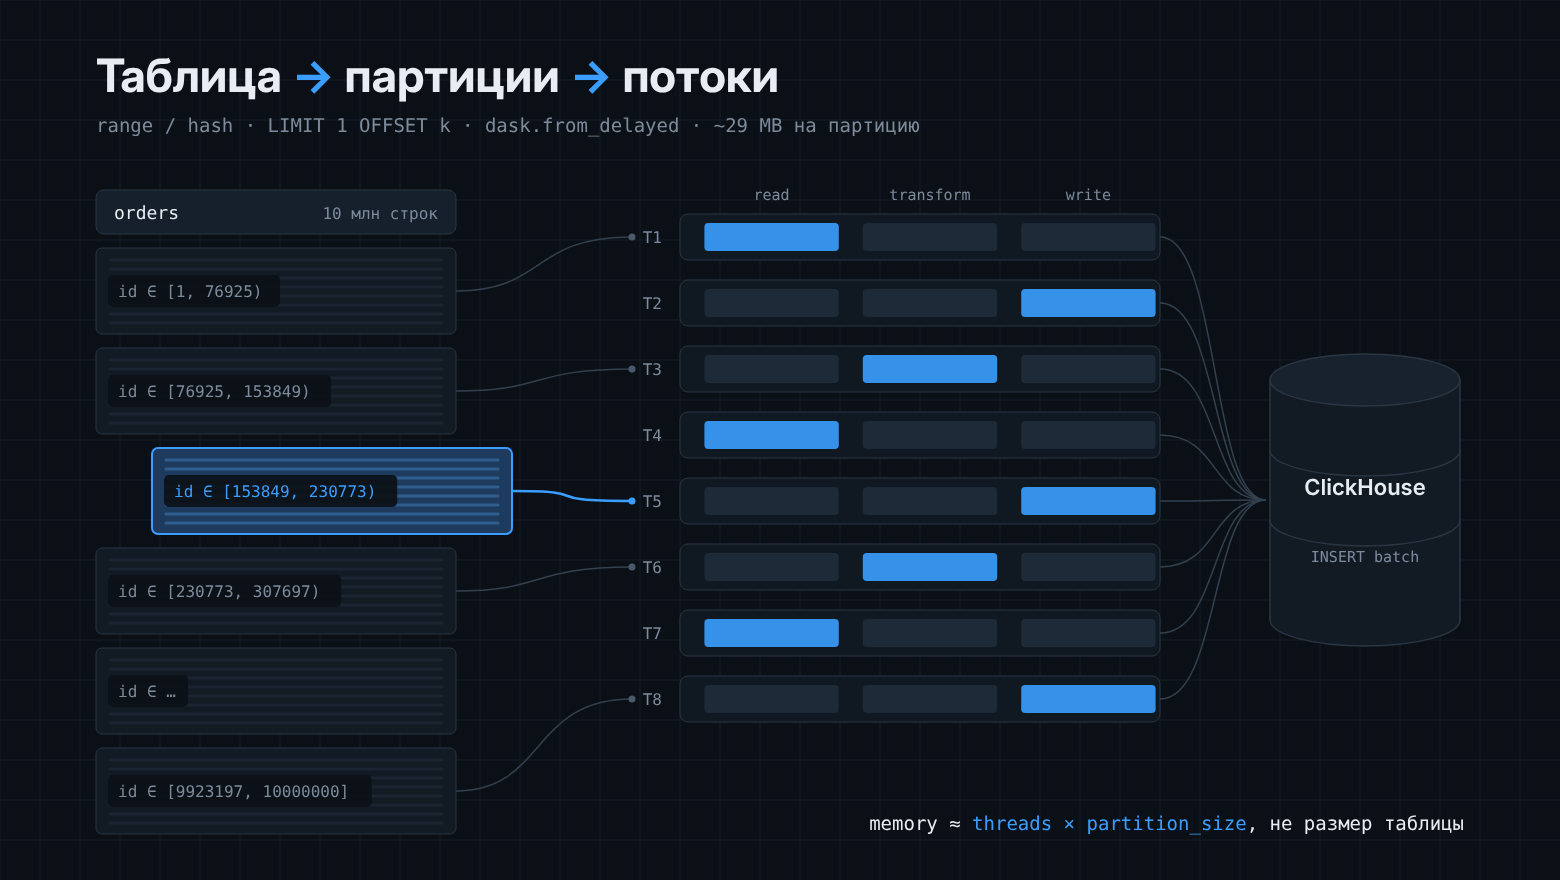
DVT — open-source платформа визуального ETL: пайплайн собирается из нод (чтение → преобразования → запись) и выполняется на воркерах поверх Dask. Я разрабатываю бэкенд DVT, в статье — устройство одного из его компонентов.

Нода чтения из БД должна одинаково работать на таблице в 10 тыс. и в 100 млн строк, на шести СУБД (PostgreSQL, MySQL/MariaDB, MS SQL, Oracle, SQLite, ClickHouse), в воркере с ограниченной памятью и без избыточной нагрузки на источник.

Ниже — устройство планировщика чтения core/db/read_v3: оценка размера строки, расчёт числа партиций, построение границ range и hash, стоимость разметки для источника и интеграция с Dask.

Читать далее

Почему сэмплеры 4+ порядка взрываются в диффузии, и как мы это починили: история создания Flow-WLS

Уровень сложностиСложный
Время на прочтение6 мин
Охват и читатели4.7K

Почему сэмплеры 4 и более порядков взрываются в диффузии, и как мы это починили: история создания Flow-WLS

Читать далее

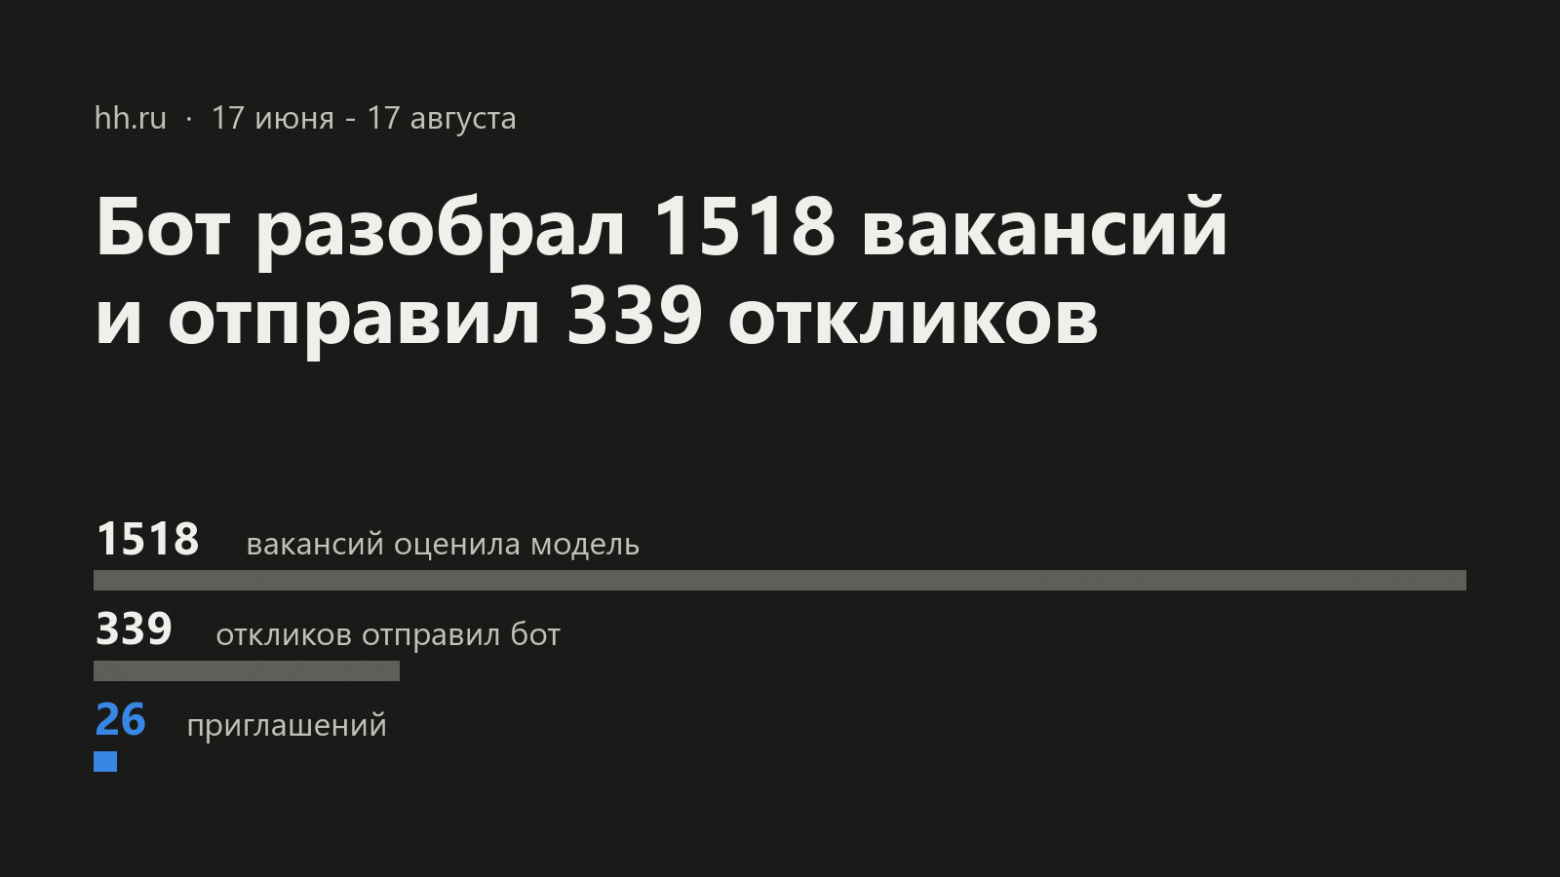
Бот разобрал 1518 вакансий на hh.ru и отправил 339 откликов

Уровень сложностиПростой
Время на прочтение6 мин
Охват и читатели5.1K

Летом я написал бота, который сам искал вакансии на hh.ru, оценивал их через LLM, писал сопроводительные и откликался. За два месяца он разобрал 1518 вакансий и отправил 339 откликов. Рассказываю, что из этого вышло: воронка, какие правки поднимали конверсию и почему расширение поиска ее уронило.

Читать далее

Переносим бота из Telegram в MAX: что отличается в API и как не переписывать логику

Уровень сложностиСредний
Время на прочтение7 мин
Охват и читатели5.2K

У меня есть бот-консультант на aiogram 3 и FastAPI, который оформляет заявки через Claude. Когда Telegram стал открываться у клиентов через раз, я добавил второй канал, MAX, не переписывая логику. В статье: что в MAX Bot API устроено иначе, чем в Telegram (сертификат Минцифры, вебхук, который глушит polling, лимиты, кнопки), как держать пользователей двух мессенджеров в одной таблице, где я потерял час и как всё проверялось без боевого токена.

Читать далее

Wispr Flow для Ubuntu за один вечер: плавающая кнопка диктовки на Wayland, и сколько граблей в этом нашлось

Уровень сложностиСредний
Время на прочтение7 мин
Охват и читатели4.2K

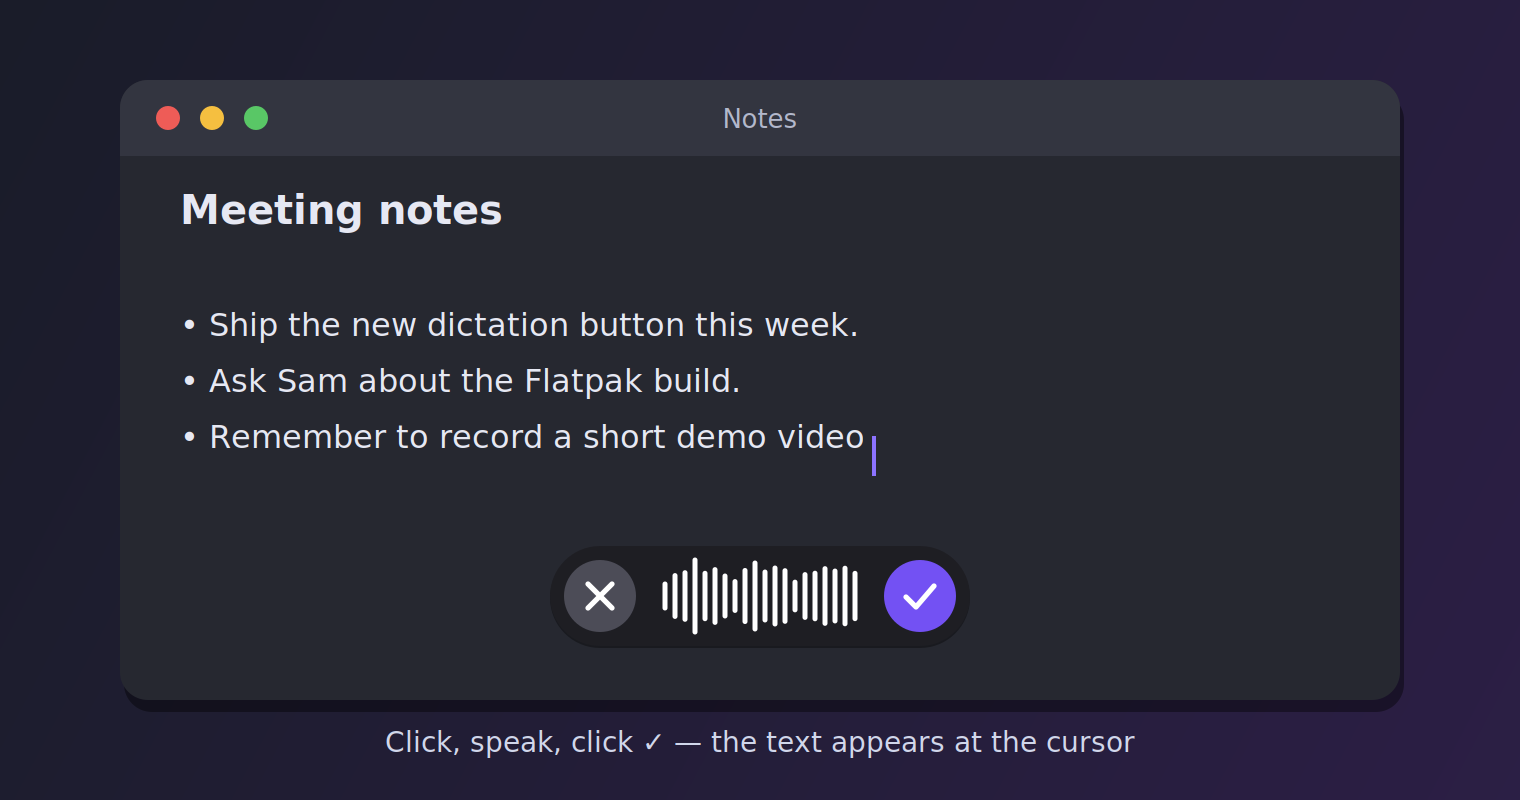
Хотелось Wispr Flow на Linux: нажал кнопку, сказал, текст вставился в любое поле. Рассказываю, как собрал плавающую кнопку диктовки на GTK, faster‑whisper и /dev/uinput под Wayland, и какие грабли нашлись по дороге: фокус, буфер обмена, хлопок микрофона и связанные регуляторы громкости.

Читать далее

Цена за 50 штук записалась в колонку «200 штук»: разбираю 42 PDF с коммерческими предложениями

Уровень сложностиСредний
Время на прочтение7 мин
Охват и читатели3.7K

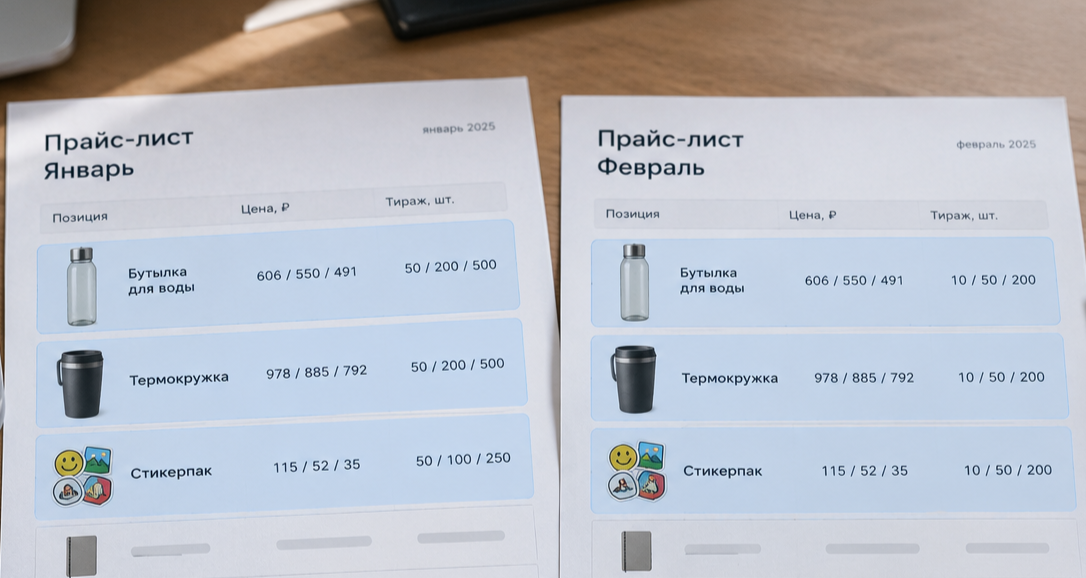
У нас в мастерской за год накопилась папка коммерческих предложений: 42 PDF, 532 страницы, 650 мегабайт. Прайсы, презентации, предложения под конкретных заказчиков. Мне понадобилась из неё одна таблица: позиция, тираж, цена за штуку. Вопрос простой: насколько дешевеет изделие, когда тираж растёт с 10 до 200 штук, и одинаково ли это работает для футболки и для стикеров.

Казалось, что это вечер работы: снять текст, найти числа рядом со словом «шт», сложить. Вышло иначе, и почти все ошибки по дороге были тихими. Скрипт отрабатывал без исключений и выдавал правдоподобные числа, которые не совпадали с тем, что напечатано на странице.

Читать далее

mAP50 = 0,99 за 22 минуты на CPU. Жаль, что цифра ничего не значит

Уровень сложностиСредний
Время на прочтение9 мин
Охват и читатели4.1K

Я дообучил YOLO11n на датасете medical-pills из документации Ultralytics: 60 эпох, 22 минуты на ноутбучном Ryzen 7, mAP50 = 0,991 на валидации. По всем признакам — успех: можно делать скриншот и рассказывать, как легко сегодня учить детекторы.

Потом я прогнал тот же датасет через dataset-doctor — свою проверялку датасетов — и узнал, что у каждого из 23 валидационных кадров есть почти точная копия в train. Валидация измеряла не «как модель справится с новыми таблетками», а «как хорошо модель помнит то, что уже видела».

Под катом: что именно нашлось, почему метрика при этом не врёт в прямом смысле, но и не говорит ничего полезного, как ловить такую утечку за два десятка строк на Python (dHash плюс корзины) и как делить данные, чтобы её не было.

Читать далее

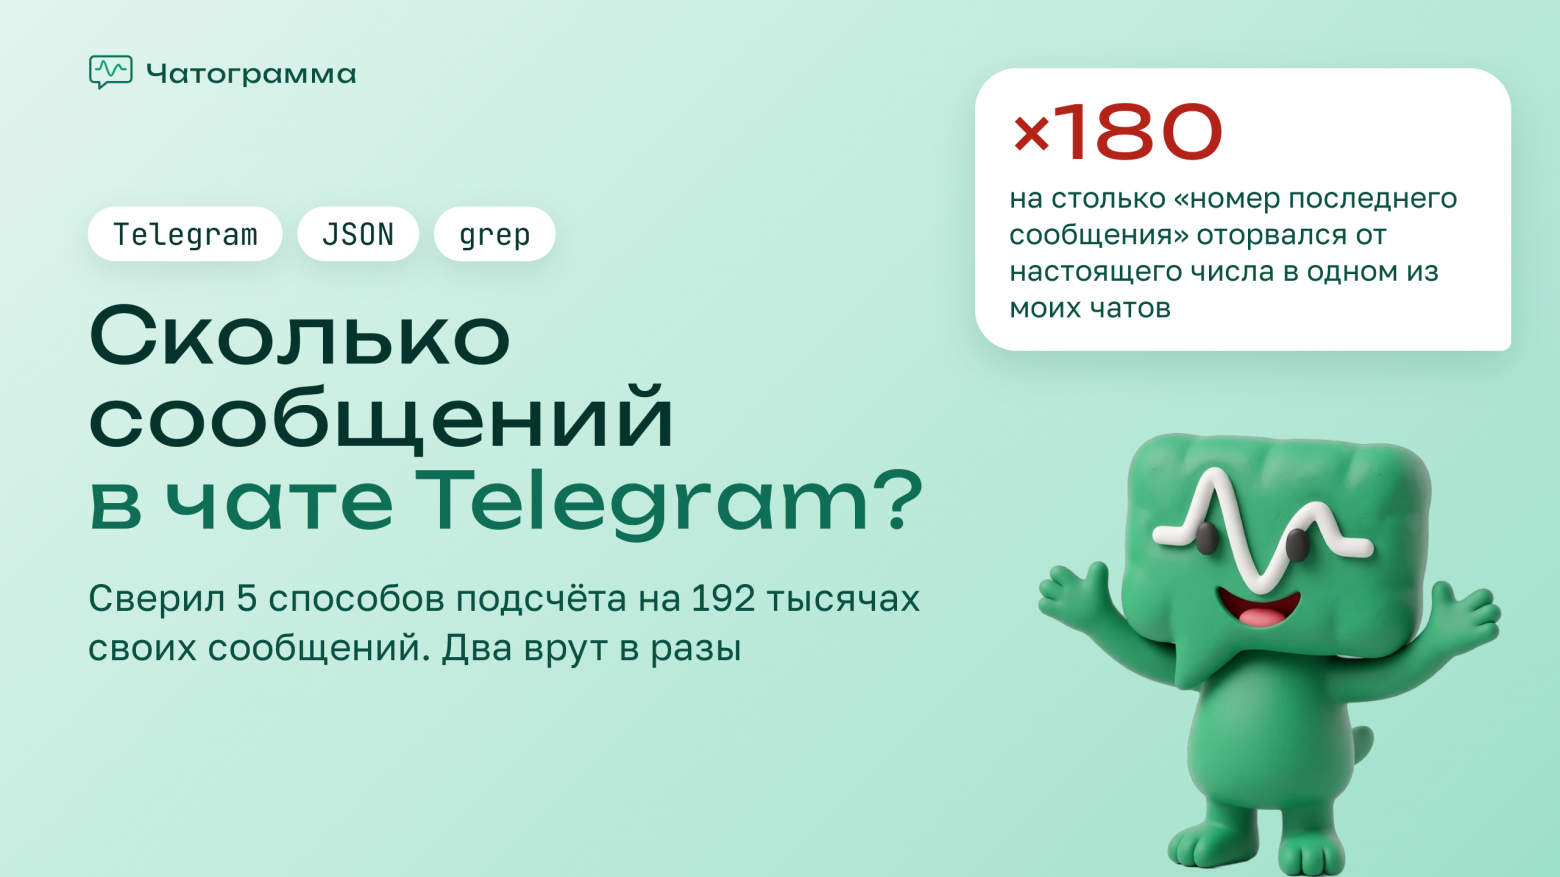
Как узнать, сколько сообщений в чате Telegram. Проверил способы из интернета на своих чатах

Уровень сложностиСредний
Время на прочтение5 мин
Охват и читатели3.7K

Стало интересно, сколько сообщений мы с женой написали друг другу за всё время.

Оказалось, что в Telegram нет счётчика сообщений. Совсем: ни в профиле собеседника, ни в настройках, ни в поиске. Статистика есть у каналов, но она про охваты и подписчиков, а не про переписку с женой.

Странно, правда? Приложение хранит каждое сообщение и при этом не может сказать, сколько их. Я полез искать способы и нашёл три, которые советуют чаще всего. Введи в поиск точку. Посмотри номер последнего сообщения. Выгрузи чат и посчитай. Ни один из них не выглядит сложным, поэтому я решил не верить на слово и проверить на своих чатах: шесть личных и две группы, 192 тысячи сообщений за семь лет. Потом добавил четвёртый способ, через API.

Про итог скажу сразу, чтобы не томить: точно считает один способ, и это не тот, что обычно все советуют. Ещё один считает почти точно, если вычесть лишнее.

Читать далее

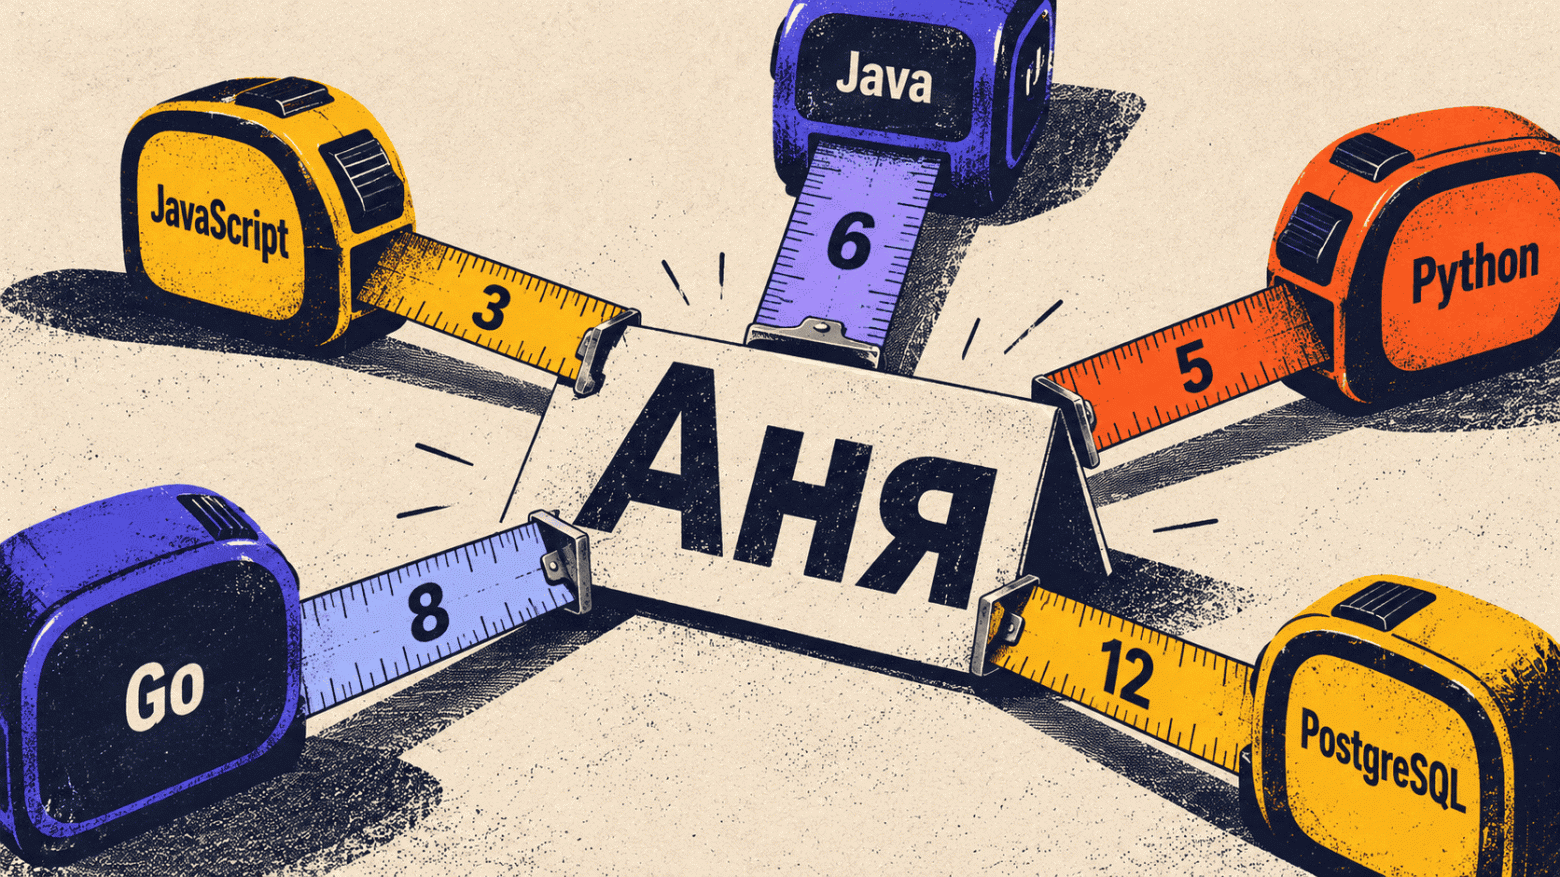
Сколько символов в нике «Аня»? Шесть языков, три ответа, и ни одного правильного

Уровень сложностиСредний
Время на прочтение9 мин
Охват и читатели5.2K

Пять видимых символов в нике могут превратиться в 10, 15 или 32 — смотря какой язык программирования их считает. Из‑за этой разницы пользователь получает ошибку валидации, теряет часть эмодзи или сталкивается с проблемой при сохранении данных. Разбираемся, почему JavaScript, Python, Go и другие языки по‑разному измеряют длину строк и как правильно задавать ограничения, чтобы данные не терялись.

Узнать подробности

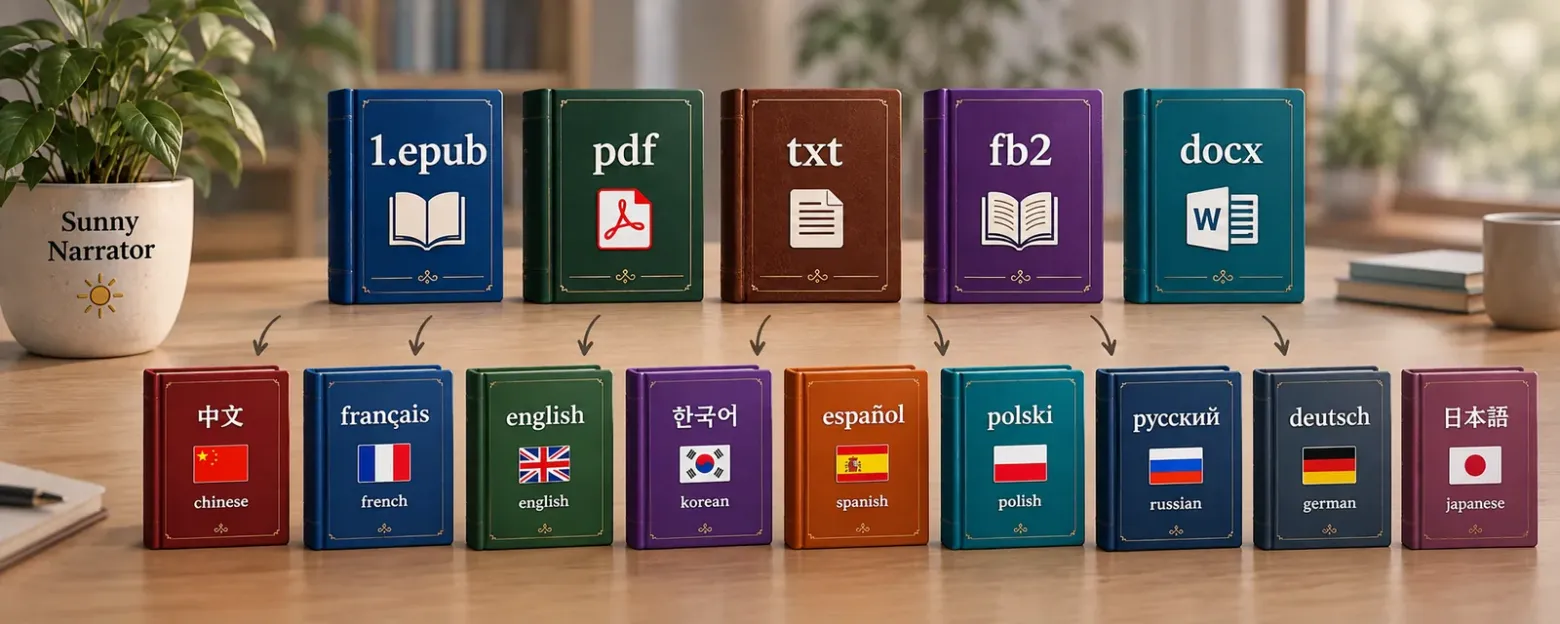
Снижаем барьеры: переведённая книга за день — без видеокарты, почти без Python

Уровень сложностиПростой
Время на прочтение11 мин
Охват и читатели4.8K

Третья статья о Sunny Narrator — переводчике книг нейросетями «для себя». Первая была про прототип, который переводил тысячу страниц два дня. Вторая — про словари, скорости и то, почему переводчики всё ещё нужны. Эта — про то, что запустить перевод теперь может почти любой.

ОФФтопик : Мне тоже жаль что Хабр да и весь инет залит нейрослопом, сырыми ИИ-продуктами, да и вообще, мы не так что бы нужны. Это не реклама - если вам она кажется такой поставь минус и получи мое сердечко и пусть у тебя будет хороший день завтра.

Это статья для тех кому нужн перевод некоего художественного текста либо для тех кто решил открыть для себя мировую литературу и не осилил другие языки как и я (посыпаю голову пеплом), но вот не смог.
Коротко: немного питона и 100 рублей денег на сервисы нейронок и полдня . Такова цена входа. Ну для тех кто любит пожестче я уже писал - там CUDA, сервера , claude\chatgpt и прочеее длиной в месяцы и годы. Поэтому статья разделилась на две части:

Читать далее

Поиск узких мест в Oracle с помощью ASH/AWR и LLM

Уровень сложностиСложный
Время на прочтение16 мин
Охват и читатели4.7K

Добрый день, всем любителям Oracle и пирогов из картофельных очистков!

Одна из самых часто встречающихся проблем при использовании баз данных - это поиск узких мест: нахождение долго выполняющихся запросов и их исправление.

Как часто вы сталкивались с ситуацией, когда запрос мгновенно отрабатывает в тестовом окружении, но начинает «тормозить» на боевом сервере? Или замедление запросов проявляется не сразу, а по мере роста данных?

Я написал open-source утилиту Optimus Oracle. Она получает тяжёлые SQL-запросы из ASH/AWR, собирает планы и через LLM (локальные или облачные) предлагает оптимизацию: создание индексов или изменение запроса. Дальше - реальные примеры «до/после», цифры, грабли и честный разговор о приватности.

Читать далее

Ближайшие события

RAGу для программиста

Уровень сложностиСредний
Время на прочтение16 мин
Охват и читатели7.1K

Внедрение AI в программные продукты часто сопровождается необходимостью обогатить контекст LLM специфичными для ваших задач данными. Для обогащения знаний используемой вами модели применяется два подхода:

- fine-tuning — дообучение модели на ваших данных. Тут финансовые затраты идут на обучение модели:

-- ресурсы на fine-tuning в случае on-prem решения,

-- дополнительные средства за дообучение модели по подписке.

- RAG — внешний источник данных, данные из которого передаются в качестве контекста к промпту в LLM. Затраты тут переносятся на размер запроса за счёт увеличения входящего контекста.

Так как я программист, а не Data Scientist, то предпочитаю понятные, переносимые вне зависимости от способа размещения модели, подходы, поэтому мой выбор — RAG. 

Читать далее

Одна франшиза — три адреса и два написания: дедупликация каталога франшиз по открытым данным

Уровень сложностиСредний
Время на прочтение5 мин
Охват и читатели5.5K

Человек, который вводит в поиск запрос вроде «франшиза каталог для малого», получает несколько каталогов, и в каждом тысячи карточек. Кажется, что из них легко собрать одну таблицу рынка: обойти, склеить, посчитать. Я так и думал, пока не попробовал склеить два каталога и один каталог сам с собой.

Ниже - что я взял за ключ записи, сколько раз каждый ключ подвёл и что в итоге работает. Код на Python, данные сняты 6 и 16 октября 2026 года.

Читать далее

Читаем DataMatrix с конвейера: открытое сравнение четырёх библиотек на 1368 синтетических кадрах

Уровень сложностиСредний
Время на прочтение9 мин
Охват и читатели6.6K

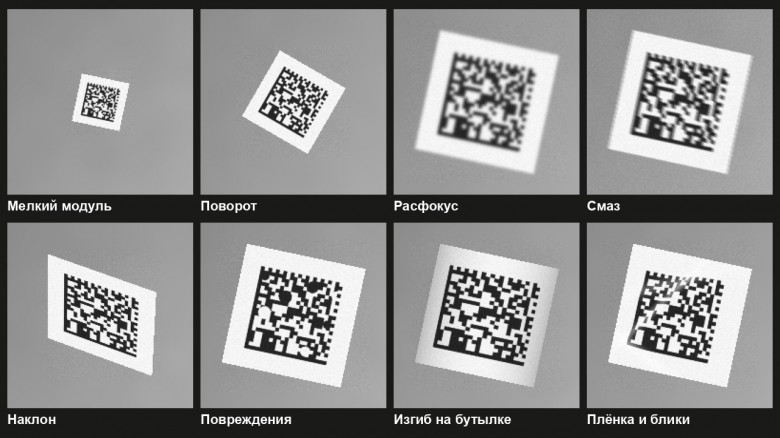
На производстве код «Честного знака» читает камера над лентой, и символ на кадре мелкий — 2–3 пикселя на модуль, повёрнутый, смазанный, на изогнутом боку бутылки. Мы сравнили, как с такими кадрами справляются ZXing, zxing-cpp, libdmtx и наша библиотека dmr. Кадры, ожидаемые строки и скрипты замера выложены — любую цифру можно проверить.

Коротко: — на 1368 синтетических кадрах dmr прочитал 82 %, zxing-cpp — 70 %, libdmtx — 65 %, ZXing (Java) — 3 %; — ложных чтений — ноль у всех четырёх библиотек; — dmr надёжно читает от 1,4 пикселя на модуль и при любом угле поворота; — zxing-cpp примерно в 2,5 раза быстрее; — есть условия, где соперники читают больше dmr, — разбираем их в статье.

Таблицы, графики и данные

Как Живаго ставит диагноз всей эпохе

Время на прочтение6 мин
Охват и читатели5.2K

С помощью Python проверяю диагнозы доктора Живаго и пытаюсь понять, был ли Юрий Андреевич просто хороший диагност или он проверял патологию всей эпохи.

Читать далее

«Ты сеньор» и «думай пошагово»: проверил шесть приёмов на 30 задачах по Python

Уровень сложностиСредний
Время на прочтение8 мин
Охват и читатели5K

Под прошлой статьёй предложили не спрашивать модель, уверена ли она, а отдельным запросом просить перепроверить и исправить код. Я проверил одну формулировку такой просьбы и ещё пять приёмов — «ты сеньор», «думай пошагово», «меня уволят», «сначала тесты», «только код» — одинаково: 30 задач по Python, скрытые тесты, три модели, по три прогона. Ни один приём не дал обнаружимой разницы в доле прошедших тестов. Переспрос исправил 3 решения из 5 неверных — мало, чтобы делать выводы. «Сначала тесты» дало в 2,6–4,4 раза больше выходных токенов, «только код» — на 10–46 % меньше. Некоторые ошибки повторялись при разных фразах: Haiku отвергал «1h30m» в пяти вариантах из семи. Внутри таблица, тексты фраз дословно и границы того, что из этого следует.

Читать далее

Радар спроса: ловим «ищу разработчика» в чатах, а ИИ-классификатор держит потолок $30 в месяц

Уровень сложностиСредний
Время на прочтение15 мин
Охват и читатели4.6K

Я делаю сайты и телеграм-ботов на заказ. Заказчики пишут «ищу, кто сделает лендинг» в профильные чаты и в ленты соцсетей, и кто ответит первым, тот обычно и получает разговор. Читать все чаты глазами я не могу, поэтому собрал робота: он читает чаты и ленты, отсеивает мусор, оценивает каждую находку нейросетью и присылает мне в личку карточку с баллом и черновиком первого ответа. Отвечаю я сам, руками. Робот никому, кроме меня, ничего не отправляет, и это правило закреплено в коде, а не в договорённости с самим собой.

Статья про устройство «трубы», по которой идёт сообщение, про учёт расходов с потолком, про три места, где было больно (зависший event loop, невалидный JSON от модели, пачка находок, которую сервер не успевал принять), и про то, что в итоге получилось по живым цифрам. Код ниже взят из рабочего проекта, лишнее я выкинул, промпты классификатора не привожу: у них своя история, к архитектуре она не относится.

Читать далее

AG‑UI 1.0: у протокола наконец появилась спецификация. Разбираем, что изменилось, на связке AG2 + CopilotKit
Уровень сложностиПростой
Время на прочтение7 мин
Охват и читатели5.4K

15 октября Tesla показала летающий Roadster, а мы разберём не менее важное: вышел AG-UI 1.0 - мажорный релиз протокола между агентом и интерфейсом. Что в нём нового и как это выглядит на связке AG2 + CopilotKit

Читать далее
1
23 ...