Обновить
4
Дмитрий Норманев@Normalisht

Backend Developer

10
Подписчики
Отправить сообщение

Новинка: «Инженерия данных. Паттерны проектирования»

Время чтения3 мин
Охват и читатели15K

Приветствуем, Хабр.

Мы стараемся лицензировать в издательстве «O’Reilly» и переводить для вас фундаментальные книги, в том числе, по формирующимся парадигмам и подходам к разработке. Одним из наиболее успешных базовых изданий такого рода была книга «Основы инженерии данных» Джо Риса и Мэта Хоусли, вышедшая в середине 2024 года (допечатка – январь 2026). Желая развить эту тему, мы издали и вторую, возможно, не менее фундаментальную книгу «Data Engineering Design Patterns», которую написал для издательства «O’Reilly» Бартош Конечны. Русское издание вышло в конце июня и называется «Инженерия данных. Паттерны проектирования». Автор считает, что в дисциплине инженерии данных можно выделить такие же многоразовые и универсальные шаблоны проектирования типичных решений, как и в традиционном программировании. То есть, он берётся повторить в этой области фундаментальный труд «Банды четырёх», который в середине 1990-х привёл к появлению всем известной книги «Design Patterns». Ранее мы размещали статью с примерами вычленения паттернов проектирования в области инженерии данных — это был перевод, а оригинал статьи написал сам Бартош Конечны, собираясь обосновать готовящуюся книгу и очертить её тематическое поле. Под катом рассмотрим, какие именно темы вошли в новую книгу.

Читать далее

Настраиваем MTProto прокси с Fake TLS за 5 минут

Уровень сложностиПростой
Время чтения4 мин
Охват и читатели490K

Привет! Если вы читаете эту статью, то скорее всего столкнулись с блокировками Telegram или просто хотите обеспечить себе стабильный и безопасный доступ к мессенджеру. Я покажу, как поднять свой собственный MTProto прокси с Fake TLS на любом VPS сервере за 5 минут с помощью готового скрипта.

Читать далее

Структуры данных на практике. Глава 10: B-деревья и деревья, эффективно использующие кэш

Уровень сложностиПростой
Время чтения9 мин
Охват и читатели16K

Загадка базы данных

Вся наша база данных находилась в памяти, однако операции поиска по ней занимали 12 тысяч тактов. При миллионе показаний датчика IoT-устройства с 64 КБ кэша реализация красно-чёрного дерева оказалась слишком медленной для запросов в реальном времени.

«Давайте попробуем B-дерево», — предложил я.

«Разве они нужны не только для баз данных на дисках? — спросил лид, — У нас всё находится в памяти. Чем нам будет полезно B-дерево?»

Вопрос был вполне разумным. B-деревья были придуманы для доступа к диску; каждый узел в них — это блок диска. Однако паттерны промахов кэша выглядели подозрительно похожими на паттерны дискового ввода-вывода — всего в 100 раз, а не в 100000 раз быстрее.

В итоге мы реализовали B-дерево. Результаты удивили всех...

Читать далее

Как устроены память и Garbage Collector в CPython: разбор для Python backend interview

Уровень сложностиСложный
Время чтения19 мин
Охват и читатели8.1K

В Python памятью управляет не только Garbage Collector.
На самом деле основа всего — reference counting, а GC лишь помогает собирать циклические ссылки.

В этой статье разберём, как на самом деле устроено управление памятью в CPython:

• что находится внутри PyObject
• как работает ob_refcnt
• почему одного reference counting недостаточно
• как GC ищет циклический мусор
• какие объекты вообще участвуют в сборке
• и как всё это помогает искать memory leak в production

Если ты готовишься к senior Python интервью или просто хочешь понимать, как Python работает под капотом, — добро пожаловать под капот CPython.

Читать далее

Разбираемся с Redis

Время чтения19 мин
Охват и читатели600K

Этот материал представляет собой глубокое исследование всего, что связано с Redis. В частности — речь пойдёт о различных способах организации хранилищ Redis, о постоянном хранении данных, о форках процессов.

Читать далее

Black-White Array: новая структура данных с O(log N) аллокаций

Уровень сложностиСредний
Время чтения8 мин
Охват и читатели20K

Black-White Array (BWA) — это упорядоченная структура данных с амортизированным временем операций вставки/поиска/удаления O(\log N) и O(\log N) используемых участков памяти. Преимущества:

• Амортизированное время вставки/удаления/поиска сравнимое с реализацией BTree от Google;
• Низкое количество аллокаций памяти при операциях вставки O(\log N) - меньше давления на сборщик мусора, ниже фрагментация памяти;
• Массивы под капотом: данные лежат рядом, что улучшает кэшируемость процессором и скорость обхода/доступа к данным;
• Позволяет хранить элементы с одинаковыми ключами - не нужно использовать дополнительные структуры для группировки таких элементов;
• Низкий оверхед на хранение служебной информации - экономия памяти по сравнению с другими структурами данных;
• Удобен для вставки батчами;
• Простая сериализация и десериализация;

Подробности

21 урок, который я усвоил за 14 лет работы в Google

Уровень сложностиПростой
Время чтения11 мин
Охват и читатели87K

В Google я устроился где-то 14 лет назад и тогда думал, что моей работой будет написание хорошего кода. Отчасти так и оказалось. Но чем дольше я там трудился, тем больше понимал, что преуспевающие разработчики — это не обязательно лучшие программисты. Обычно это те люди, которые научились лавировать среди всего, что окружает код — среди людей, внутренней политики и условий неопределённости.

В конечном итоге за всё это время я освоил множество уроков, которые определённо пригодились бы мне изначально. Некоторые избавили бы меня от многих месяцев фрустрации. На понимание других ушли годы. Причём ни один не касается каких-то конкретных технологий, которые меняются слишком часто, чтобы играть важную роль. Все эти уроки связаны с паттернами, которые продолжают встречаться раз за разом — в каждом проекте и каждой команде.

Я решил поделиться ими, так как мне самому помогли освоить их другие разработчики. Поэтому в некотором смысле я передаю эстафету.

Читать далее

DDD на пальцах: как перестать проектировать таблицы и начать думать о бизнесе

Уровень сложностиСредний
Время чтения6 мин
Охват и читатели16K

Привет, Хабр! Cегодня я хочу поговорить о самом непонятном и переоцененном термине в мире архитектуры — Domain-Driven Design (DDD). Я объясню его так, чтобы стало понятно даже джуну, и покажу на реальных примерах, чем он отличается от других подходов.

Читать далее

Мало кто знает, но в Python есть switch/case: Гид по структурному сопоставлению (match/case) не только для версии 3.10+

Время чтения6 мин
Охват и читатели24K

Разбираем мощь match/case в Python: от базового синтаксиса до распаковки JSON и эмуляции в старых версиях.

Читать далее

Consistent против Rendezvous — чем отличаются подходы для хэширования данных на сервере

Время чтения7 мин
Охват и читатели26K

Всем привет, меня зовут Михаил Алексеев, я работаю программистом в студии ITT, пишу бэкенд на Java. Перформанс — это моя страсть, как и распределенные системы. Но еще больше я люблю, когда математика встраивается в перформансные цели и задумки.

В этом тексте я расскажу про разницу между Consistent и Rendezvous хэшированием, а также на примерах покажу, с какими проблемами мы сталкиваемся в работе.

Читать далее

Как стримить большие ответы в Django через StreamingHttpResponse и async-генераторы

Уровень сложностиПростой
Время чтения17 мин
Охват и читатели8.9K

Привет, Хабр!

Сегодня рассмотрим решение одной непростой задачи, как в Django выдавать очень большие объёмы данных, например, выгрузку в CSV или потоковый JSON-формат NDJSON) так, чтобы сервер не ложился от нагрузки, а пользователи быстрее получали первые данные. Разберём, как использовать StreamingHttpResponse и генераторы (в том числе асинхронные) для стриминга больших ответов и поговорим нюансах.

Подробнее о стриминге

SQL для всех: от новичка до профи. Полный гид по тренажерам, курсам и песочницам

Уровень сложностиПростой
Время чтения16 мин
Охват и читатели67K

Привет, Хабр! Часто ли вам приходилось часами смотреть на сложный JOIN, пытаясь понять, почему он работает не так, как надо? Или, может, вы только начинаете свой путь в IT и слышите со всех сторон, что без SQL никуда? Вы правы, так и есть. SQL — это не просто строчки кода, это ваш ключ к данным, настоящий швейцарский нож для любого тестировщика, аналитика или разработчика.

Все мы знаем, что можно прочитать тонну теории, но без реальной практики она быстро выветривается из головы. Именно поэтому я решил поделиться своей коллекцией проверенных тренажеров и ресурсов. Здесь есть все, чтобы вы могли уверенно «заговорить» на языке данных: от уютных песочниц для новичков до хардкорных задачек с реальных собеседований в ведущих IT‑компаниях. Так что устраивайтесь поудобнее, добавляйте в закладки и поехали тренироваться!

Читать далее

AsyncAPI — Swagger для асинхронного API

Время чтения13 мин
Охват и читатели23K

Привет, Хабр! Меня зовут Александр Митин. Я Java разработчик в компании ИТ-холдинг Т1 с 15 летним опытом, из которых последние 5 лет работаю в финтехе. Мой любимый стек — Java Spring. Я хочу рассказать такое AsyncAPI, как работать со спецификациями, какие есть инструменты и поделюсь нашим опытом перехода на подход API First в наших системах.

Читать далее

Docker изнутри: исчерпывающее руководство. Механизмы контейнеризации + примеры, эксперименты и реализация

Уровень сложностиСредний
Время чтения33 мин
Охват и читатели137K

Docker — не магия, а грамотное применение механизмов Linux. Разбираем инструмент, который пугает своей сложностью не меньше блокчейна. Показываем на пальцах как работают: Namespaces, Cgroups, OverlayFS – основные компоненты любого контейнера, и как стандарт OCI объединяет их в единую экосистему. Об этом и не только в статье.

Читать далее

Разработка высоконагруженных API: проблемы, решения, практические рекомендации

Уровень сложностиСредний
Время чтения14 мин
Охват и читатели71K

Ваш проект взлетел. Первые пользователи превратились в тысячи. Тысячи стали десятками тысяч. Метрики в дашбордах рисуют красивую кривую, устремленную вверх. Но есть и другие кривые, которые ползут вверх с не меньшей скоростью. Время ответа сервера. Количество ошибок 502 и 504.

То, что летало на ста запросах в секунду, начинает задыхаться на десяти тысячах. Это не ошибка, это физика. Архитектура для этих двух миров — это как велосипед и грузовой поезд. Они оба едут, но задачи у них разные. Так что давайте забудем про теорию и посмотрим, где обычно рвется и как это чинить, чтобы не переписывать все с нуля каждый раз, когда у вас прибавляется нолик в статистике пользователей.

Читать далее

Как собрать Docker-образ, который можно запускать в проде (а не только у себя на ноуте)

Уровень сложностиПростой
Время чтения4 мин
Охват и читатели54K

Если ты пишешь Dockerfile, скорее всего, он работает. Но вопрос не в том, работает ли. Вопрос в другом: будет ли он работать через неделю, на другом сервере, в CI/CD, на чужом железе — и будет ли это безопасно?

Читать далее

Как превратить старый ноутбук в домашний сервер для хранения данных и удаленной работы

Уровень сложностиСредний
Время чтения10 мин
Охват и читатели68K

Делюсь личным опытом превращения старенького ноутбука ASUS X552CL (Intel i5-5200U, 12 ГБ RAM, SSD + HDD), выпущенный 12 лет назад, в полноценный домашний сервер под Linux Ubuntu Server 24.04.5 LTS.

Получилось что-то вроде мини-датацентра на дому — он хранит файлы на жёстком диске с бэкапом в облаке, Docker-контейнеры крутит для дата-аналитики и даже имеет легковесный интерфейс XFCE, при этом есть потенциал к росту до терминала для управления умным домом. Расскажу, почему было решено отказаться от WSL на рабочем ноутбуке Huawei, как настроить удалённый доступ через xRDP (чтобы не было чёрного экрана), запустить там Docker, сборку Superset и JupyterLab с Anaconda (с разными версиями Python), прикрутить Samba-шару для домашнего использования и организовать бэкап в облачном хранилище. В этой статье будет немного технических деталей, щепотка шуток и парочка мемов с советскими плакатами.

Читать далее

Системные вызовы Linux, которые должен знать каждый разработчик

Уровень сложностиСредний
Время чтения7 мин
Охват и читатели37K

Многие разработчики работают в Linux-среде, но не всегда глубоко понимают, как взаимодействие с ОС происходит на низком уровне. На собеседованиях всё чаще спрашивают про системные вызовы Linux. В этой статье мы рассмотрим, какие вызовы встречаются чаще всего и как они работают.

Читать далее

Даже не влезайте в Kubernetes без этого

Время чтения20 мин
Охват и читатели85K
image

Главный прикол с k8s: поднять базовый кластер займёт всего 15 минут. А вот чтобы он реально заработал, ответить на все вопросы перед установкой, всё спланировать — на это нужны дни, реально дни мозгового штурма и планирования. Ну или потом придётся разбирать и делать ещё раз. Несколько раз.

Кубер унижает человеческое достоинство разными способами и на разных этапах. Это часть опыта от пользования продуктом. Так задумано.

И вот про эти самые вопросы мы сейчас и поговорим, потому что там целое волшебное поле грабель.

Начнём с простых вещей, например, выбора дистрибутива, выбора способа хранения данных (и динамического выделения места), а также того, куда складывать пароли к критичным ресурсам. На этих трёх выборах ломается примерно 50 % админов.

Поехали в ад!
Читать дальше →

Git Rebase: руководство по использованию

Время чтения8 мин
Охват и читатели929K
Rebase — один из двух способов объединить изменения, сделанные в одной ветке, с другой веткой. Начинающие и даже опытные пользователи git иногда испытывают нежелание пользоваться ей, так как не видят смысла осваивать еще один способ объединять изменения, когда уже и так прекрасно владеют операцией merge. В этой статье я бы хотел подробно разобрать теорию и практику использования rebase.

Теория


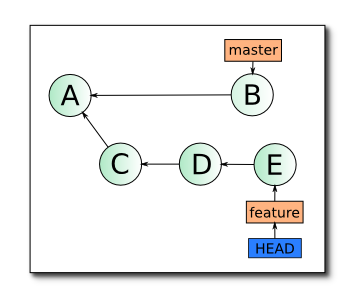
Итак, освежим теоретические знания о том, что же такое rebase. Для начала вкратце — у вас есть две ветки — master и feature, обе локальные, feature была создана от master в состоянии A и содержит в себе коммиты C, D и E. В ветку master после отделения от нее ветки feature был сделан 1 коммит B.


Читать дальше →

Информация

В рейтинге
Не участвует
Откуда
Калуга, Калужская обл., Россия
Дата рождения
Зарегистрирован
Активность

Специализация

Бэкенд разработчик
Средний
Git
Python
PostgreSQL
Docker
ООП
Django