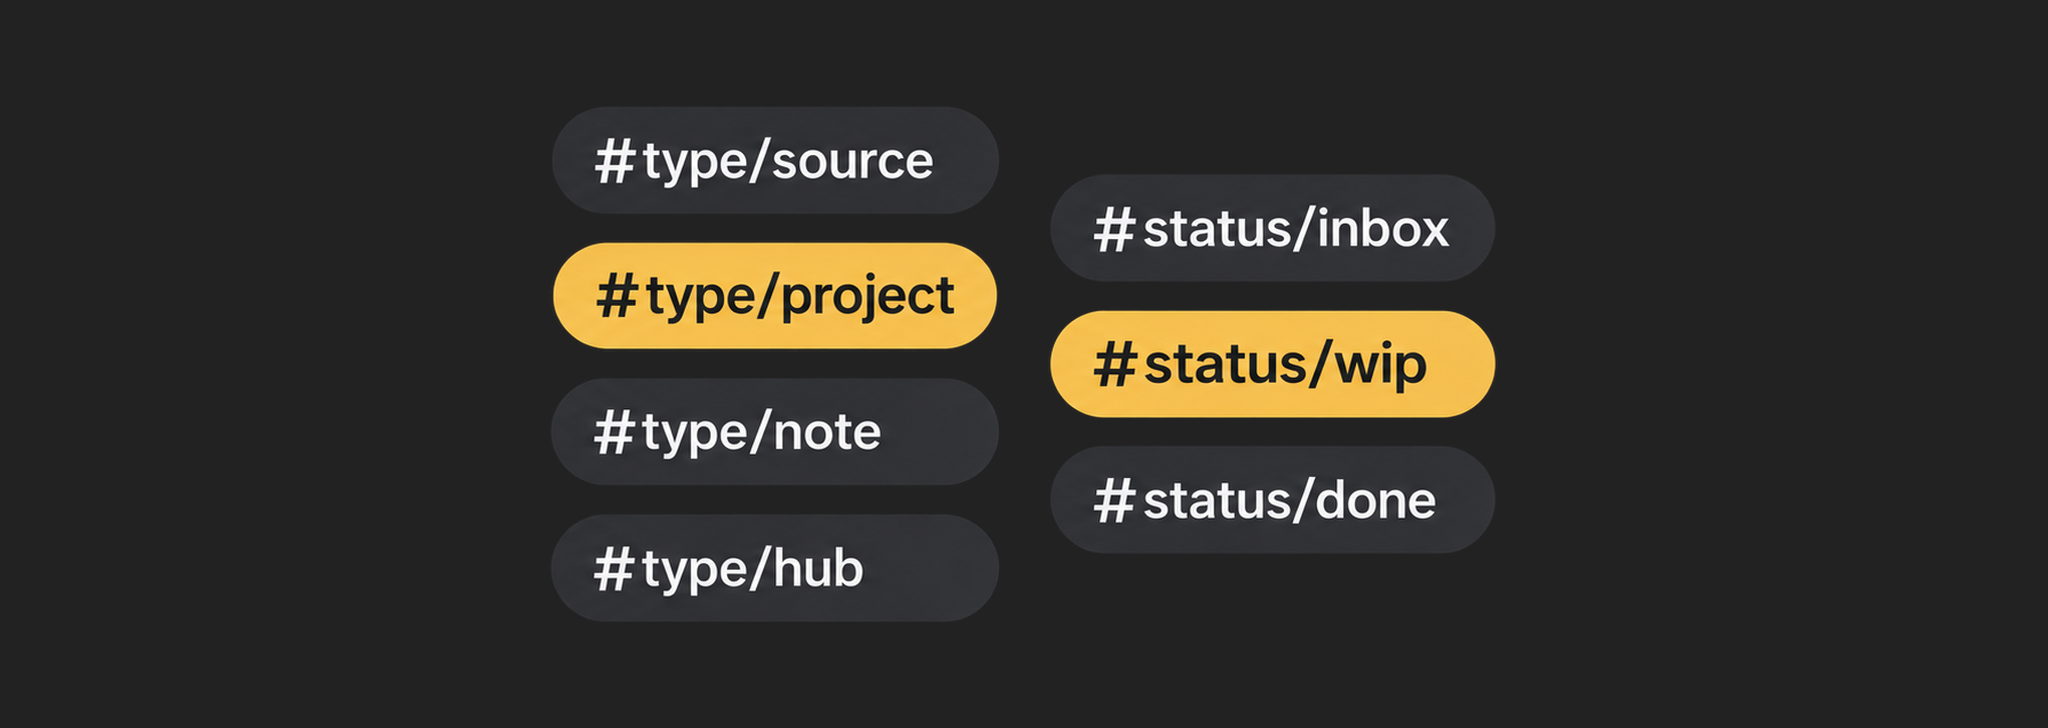
Через стандартную панель тегов можно посмотреть, какие материалы ещё не разобраны, что запланировано и что уже в работе.
Для проектов и источников использую статусы inbox, todo, wip и done. Для обычных заметок предлагаю ограничиться inbox и снимать его после перечитывания, доработки и связывания с другой заметкой.
В видео с нуля настраиваю шаблоны, QuickAdd и Templater, собираю общее меню создания заметок и показываю работу на примерах книг и проектов.
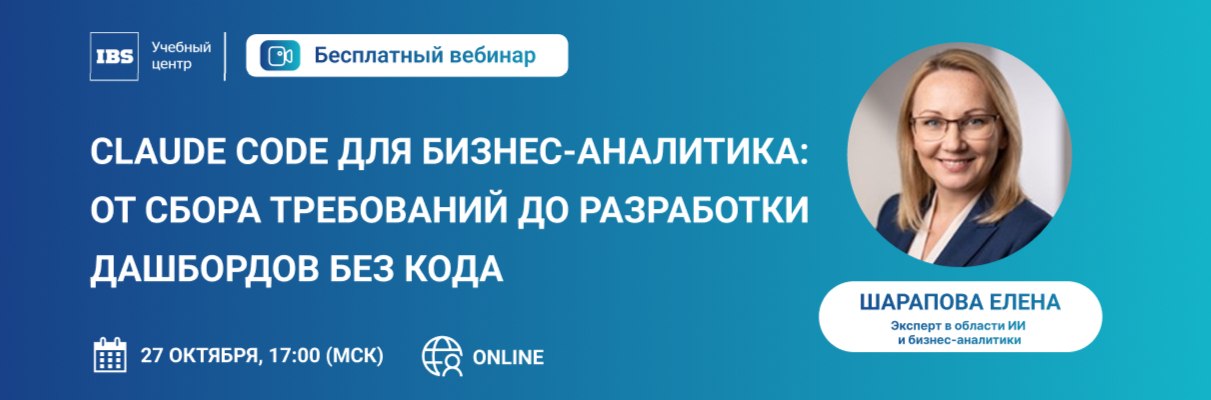
В прямом эфире: 👾 Как из протоколов встреч и переписки собрать структурированные требования, user stories и приоритизированный бэклог 👾 Настройка «устава проекта» для агента, скиллы как регламенты, роли аналитик → разработчик → QA-ревьюер 👾 Генерация BPMN-схем по текстовому описанию с проверкой нотации 👾 Подключение к MySQL: аудит базы, проектирование объектов, UML-схемы 👾 Прототипы экранов по циклу «ASCII-каркас → тема → анимации → HTML» 👾 Дашборды из CSV/Excel/БД в интерактивную страницу с KPI и фильтрами
Отдельный блок — контроль качества. Разбор реального инцидента в проде, после которого отключать проверки точно не захочется.
📆 Когда: 27 октября в 17:00 (Мск) 🙍♂️ ️Спикер: Шарапова Елена, эксперт в области бизнес-аналитикм и ИИ, архитектор бизнес-процессов и ИТ-систем
Четыре причины, почему пилоты ИИ-агентов в BI не доходят до ежедневной работы
Когда мы показываем заказчикам ИИ-агентов Dora для FineBI, почти каждый разговор заканчивается одной просьбой. Покажите кейс, где агент уже работает поверх BI в реальной компании. Таких историй в промышленной эксплуатации пока единицы.
С кем ни поговоришь, все хотят услышать кейсы. При этом мы понимаем, что реально ещё почти никто не внедрял.
Александр Брежнев, GlowByte
Пилоты идут, но до ежедневной работы доходят немногие. Чаще всего они застревают на том, что было в компании до агента:
• метрика «выручка» в двух подразделениях считается по-разному, и агент уверенно называет одну из версий;
• агент видит больше данных, чем человек, задавший вопрос, или меньше, чем нужно для ответа;
• у пилота нет владельца и эталонных ответов, и через два месяца его закрывают по ощущениям;
• команда прошла вебинар, а работает по-старому.
Одно исключение мы знаем по своим проектам. Это миграция отчётов между BI-платформами: у задачи есть эталон, исходный отчёт, и результат агента можно сверить с ним на данных.
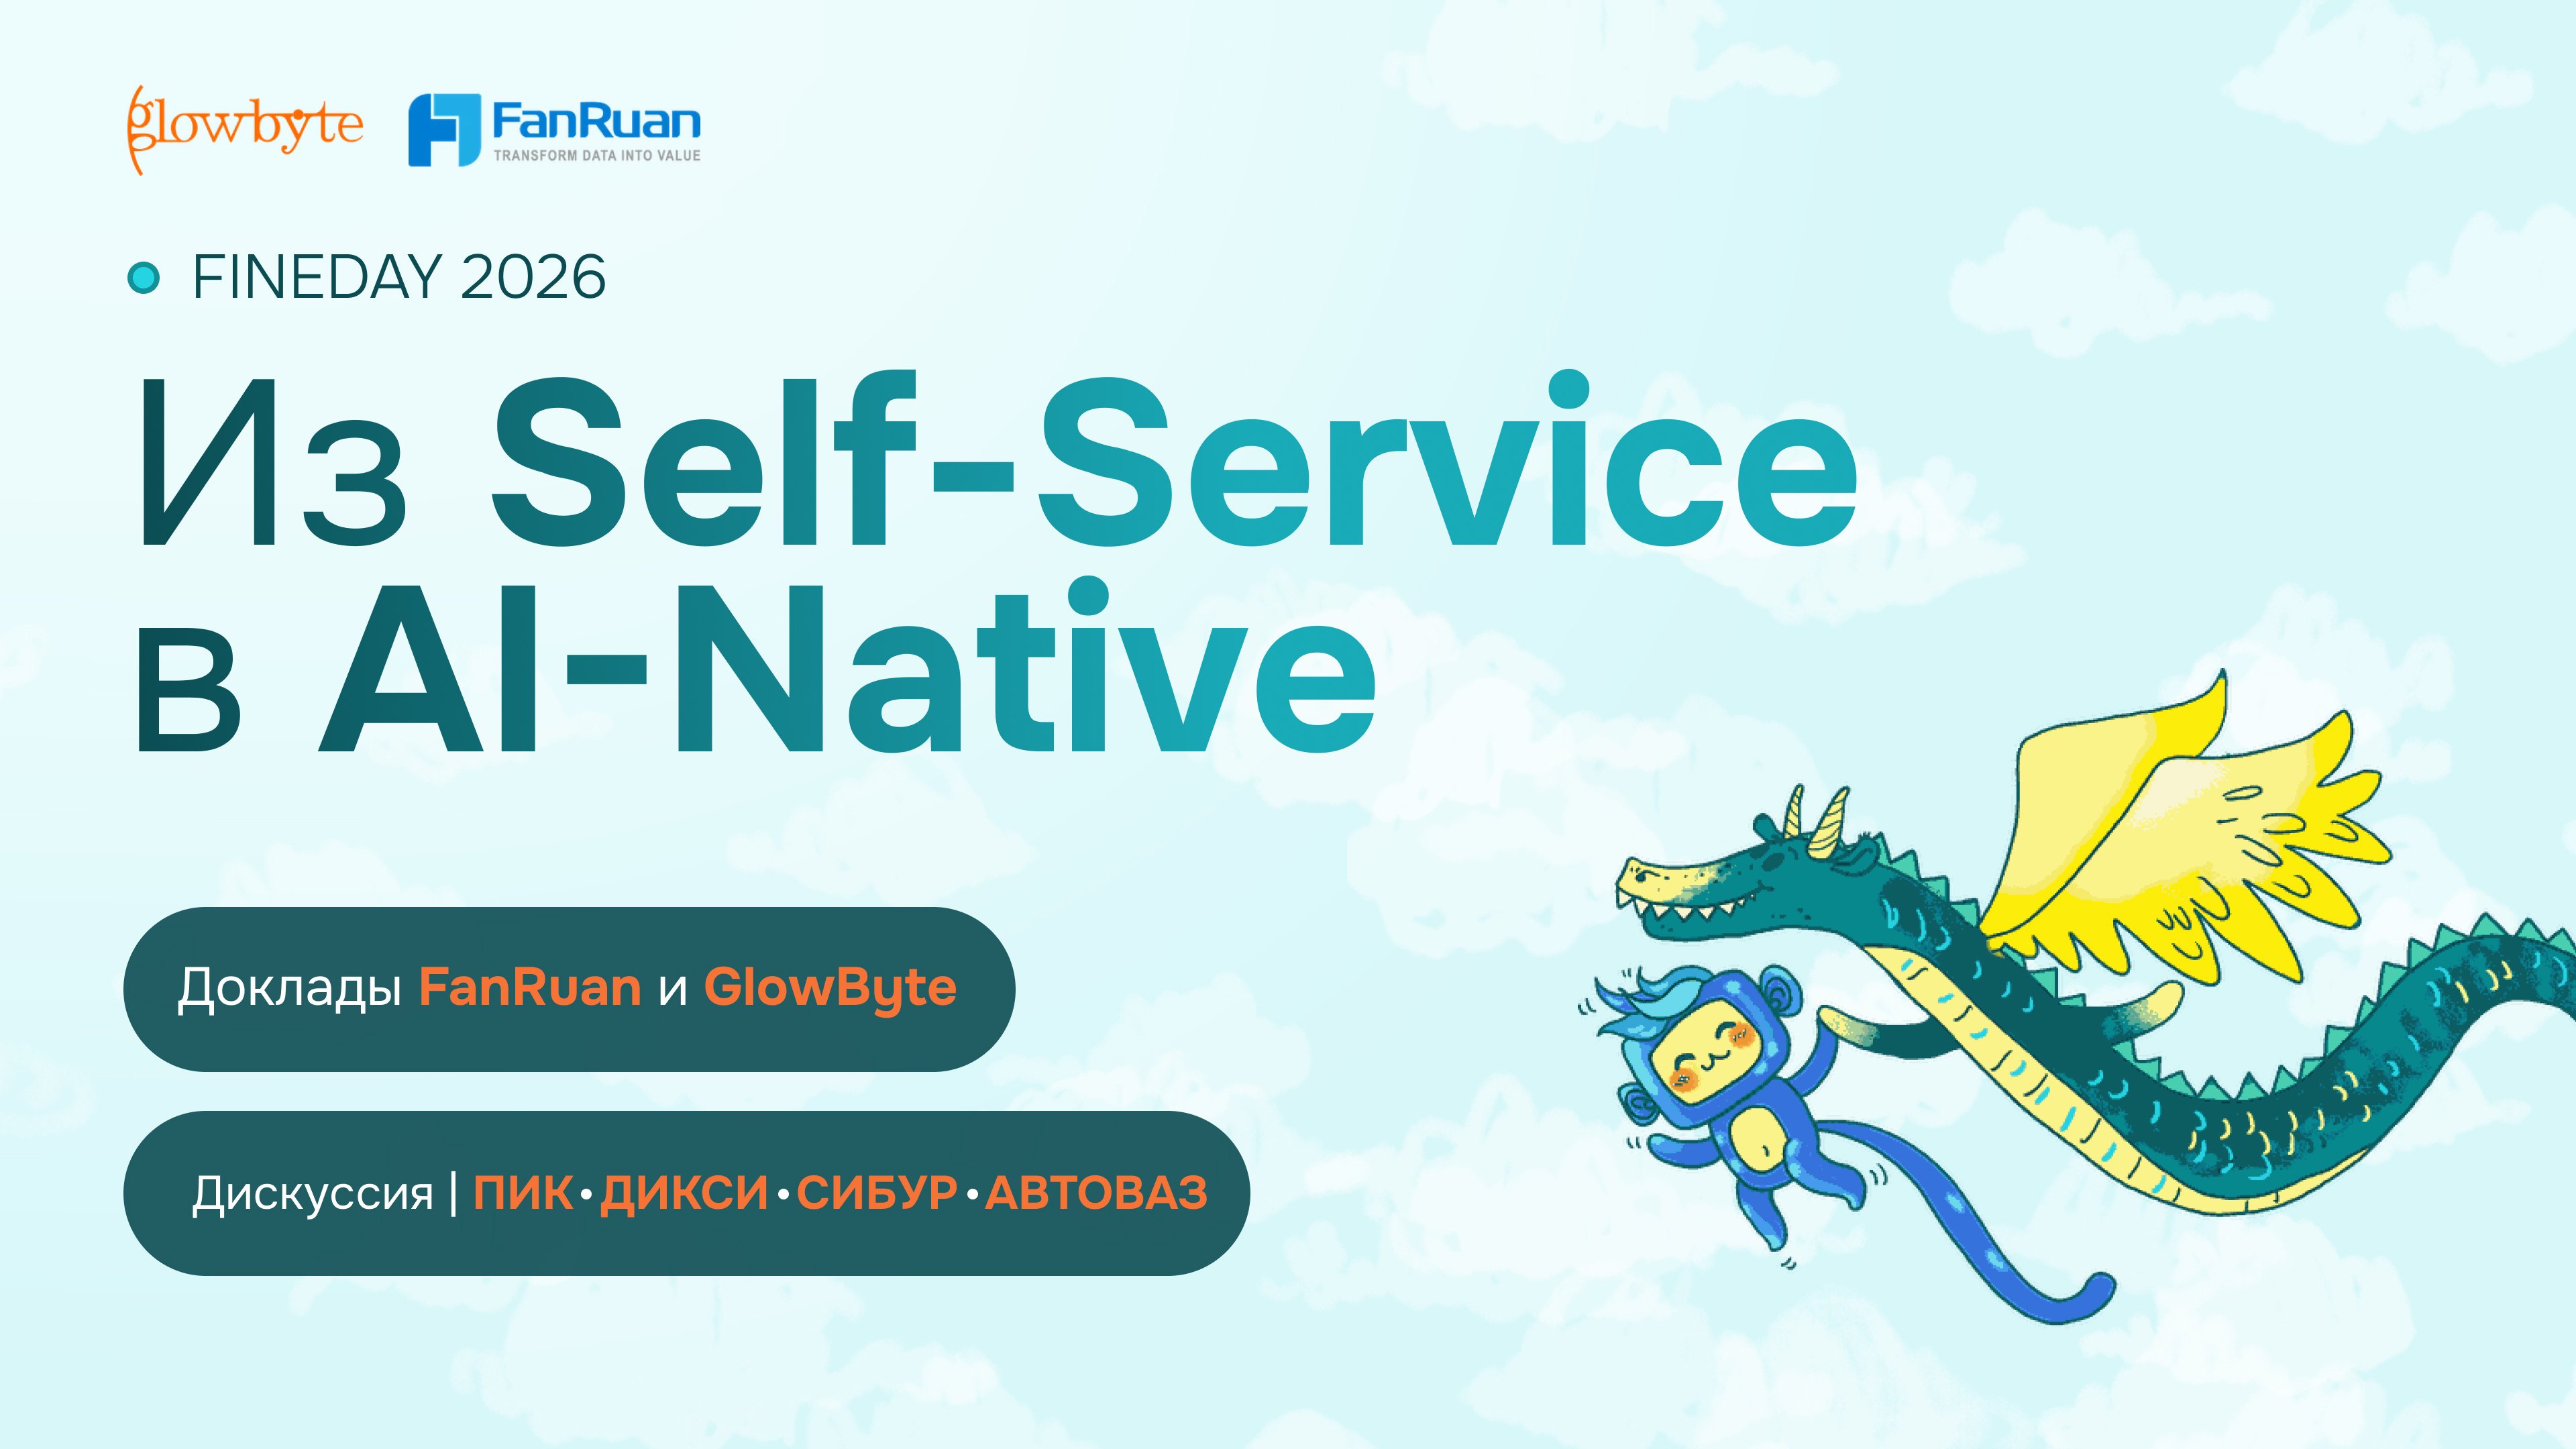
Про данные мы уже писали подробно, вот чек-лист готовности данных и шаблон пилота с приёмкой по 50 вопросам. Про людей, выбор сценариев и устойчивость платформы готовых ответов у нас меньше, поэтому 23 октября на Fine Day 2026 в Москве мы позвали тех, кто ищет их на практике.
• 15:00. Лэнс Ли, международный исполнительный директор FanRuan, о том, куда движется корпоративный ИИ и где ему нужна опора на BI
• 15:25. Дискуссия «AI-Ready: что нужно данным и командам, чтобы ИИ заработал» с руководителями аналитики ПИК, ДИКСИ, СИБУР и АВТОВАЗ
• 16:10. Дмитрий Куроедов и Андрей Пашков из GlowByte запустят на сцене ИИ-миграцию отчётов из Qlik и Power BI в FineBI и покажут, что перенеслось, а что пока доделывают консультанты
• 17:00. Андрей Демидов, основатель проекта ДатаЙога, о том, как за пять дней запустить у команды новую практику работы с ИИ. Это формат нашего онлайн-марафона 9–13 ноября
• 17:50. Вилл Ченг, FanRuan CIS, о том, что происходит с отчётами, когда основной сервер FineBI выходит из строя
Участие бесплатное, заявки проходят модерацию, поэтому регистрируйтесь с рабочей почты. После регистрации придёт полный чек-лист «Готовы ли ваши данные к ИИ-агенту?» из 25 вопросов: https://clck.ru/3WV5ot
Не в Москве? Онлайн-марафон про AI 9–13 ноября. Разберём реальные кейсы компаний и то, как ставить задачи агентам и проверять их выводы. Предзапись: https://clck.ru/3WV5pj
А на каком этапе вы? Агент уже отвечает на вопросы бизнеса, идёт пилот, смотрите демо или решили пока не трогать? Напишите в комментариях, что мешает сделать следующий шаг. Самые частые ответы передадим участникам дискуссии.
Как работать с меняющимися требованиями и внедрять ИИ-агентов
Поговорим об этом на «Коде аналитика» — бесплатном митапе ЮМопеу для системных аналитиков. В программе четыре доклада от экспертов ЮМопеу, Сбера и Бындюсофт о задачах, с которыми аналитики сталкиваются каждый день:
как работать с постоянно меняющимися требованиями и большим количеством стейкхолдеров;
чем промышленный ИИ-агент отличается от прототипа и что нужно для его работы после релиза;
как автоматизировать работу с архитектурой с помощью тестов и автогенерации;
какие ИИ-инструменты помогают системным аналитикам, а какие подходы не оправдывают ожиданий.
Разберём практические решения и опыт команд, а также обсудим, как меняется работа системного аналитика.
Когда: 22 октября, четверг, 19:00 (мск). Приходите на митап в Санкт-Петербурге или подключайтесь к онлайн-трансляции.
Зовите коллег, которым интересны системный анализ, архитектура и применение ИИ в работе. Все подробности и регистрация на сайте «Кода аналитика».
Пять признаков, что вашему self-service BI пора разводить разработку и прод
S
Хранилище нагружают запросы, которые ещё не стали отчётами. Разработчики тестируют гипотезы прямо на боевых подключениях.
Неописанные датасеты копятся. Рядом с официальным хранилищем вырастает теневое, и логика расчётов уходит из документации.
SQL в датасетах никто не проверял. SELECT * по большой таблице уходит в прод так же легко, как оптимизированный запрос.
Ключевой отчёт изменился, и никто не знает, кто и когда это сделал.
На вопрос «откуда эта цифра» отвечают по памяти. Цепочки от отчёта до таблицы в хранилище нет.
Если вы узнали у себя хотя бы пару пунктов, дальше встаёт вопрос, как разводить разработку и прод. Во многих крупных компаниях для этого держат два стенда, тестовый и продовый. Это дорого и по лицензиям, и по железу.
В ОТП Банке решили не дублировать инфраструктуру и пошли другим путём. Команда осталась на одном стенде FineBI и построила вокруг него CI/CD, в котором нашлось место и для LLM. Нагрузка на хранилище снизилась, а у банка появился слой согласованных датасетов, защищённых от случайных правок. Тот же слой команда считает основой для будущих ИИ-агентов: проверенный SQL, происхождение данных и описания отчётов дают им контекст.
Как это устроено и где LLM помогает, а где решение остаётся за человеком, 23 октября на Fine Day 2026 в Москве расскажут Пётр Гордиенко, руководитель команды BI ОТП, и Евгений Иванов, DevOps BI-платформы ОТП. Доклад в 17:30.
Участие бесплатное, регистрация с рабочей почты, заявки проходят модерацию: https://clck.ru/3WV5pE
Не в Москве? Онлайн-марафон про AI 9–13 ноября. Разберём реальные кейсы компаний и то, как ставить задачи агентам и проверять их выводы. Предзапись: https://clck.ru/3WV5pj
Как у вас разведены разработка и прод в BI? Два стенда, один стенд с разделением или пока всё на проде? И какой из пяти симптомов вы заметили первым?
Можно искать его среди всех котов по очереди, а можно заранее разделить их на группы, чтобы сузить круг поисков. Похожий принцип работает и с большими объемами данных, когда среди миллионов записей нужно быстро найти нужные.
Катя, руководитель группы системной аналитики, работала над оптимизацией больших таблиц с помощью секционирования.
Онарассказала, как работает этот подход, что важно учитывать при его реализации и при чем здесь коты.
🔸 Разбираемся с большими таблицами
В больших таблицах могут храниться миллионы записей. При таких объемах поиск нужных данных иногда занимает много времени, замедляя загрузку списков и отчетов.
Есть разные способы оптимизации: можно улучшать запросы, добавлять индексы или менять организацию данных.
Один из подходов — секционирование, то есть разделение большой таблицы на части.
🔸 Рассаживаем котов по коробкам
Представьте комнату, в которой живет сотня котов, а нам нужно найти кошку Мусю.
Можно искать ее среди всех животных, а можно заранее рассадить котов по коробкам, например, по возрасту.
Мусе два года — значит, ищем только в коробке с котами от года до семи лет.
С данными похожий принцип: система может искать только в нужной части таблицы.
🔸 Выбираем правило разделения
Чтобы секционирование было полезным, важно правильно выбрать, какую таблицу разделить и по какому правилу.
Вернемся к котам. Если все они примерно одного возраста, делить их на возрастные группы бессмысленно: почти все окажутся в одной коробке.
Зато, если коты разных пород, можно рассадить их по породам и искать Мусю только в нужной коробке.
🔸 Продумываем перенос данных
Выбрать способ разделения — только часть задачи. Данные из заполненной таблицы еще нужно перенести в новую.
Перенос может дополнительно нагружать систему, поэтому мы, например, предусмотрели возможность приостанавливать его в часы пик и продолжать позже.
А если секционирование не подойдет, данные можно перенести обратно в обычную таблицу.
🏦 Портфель альткоины/золото с автоматической балансировкой
Идея следующая: когда растет Bitcoin, растут альты. Золото растет независимо от Bitcoin.
Исходя от дней роста Bitcoin подряд, смещать распределение портфеля из золота в криптовалюты. Криптовалюты покупать в равной доле независимо от объема торгов, так как все коррелируют с биткоином. При этом не держать в USDT ничего совсем, чтобы избежать инфляции
Закрытие кассы и ребалансировку делаем раз в неделю
import {
  addLauncherSchema,
  addStrategySchema,
  Cache,
  getCandles,
  listenDoneBacktest,
  Position,
  setConfig,
} from "backtest-kit";

setConfig({
  CC_MAX_STOPLOSS_DISTANCE_PERCENT: 100, // иначе валидатор не пропустит технический стоп -50%
});

// Депозит делится поровну между тикерами корзины; доля депозита вне корзины паркуется в золото
const DEPOSIT_USD = 1000;
const PARKING_SYMBOL = "PAXGUSDT";

// Позиция живёт ровно неделю и закрывается по времени; перезаход на первом тике после закрытия
const HOLD_MINUTES = 7 * 24 * 60;

// Трендовый гейт по BTC: доля окон 20..45 дней с положительной доходностью BTC. Это экспозиция
// корзины от 0 до 1; остаток уходит в PARKING_SYMBOL. Ансамбль окон вместо одного N: одиночные
// окна за пределами 25..45 дней заметно хуже, внутри плато результат от выбора N не зависит.
const GATE_SYMBOL = "BTCUSDT";
const GATE_WINDOWS_DAYS = [20, 25, 30, 35, 40, 45];

// Технические уровни: за неделю на споте без плеча недостижимы, штатный выход только по времени
const STOP_LOSS_PERCENT = 50;
const TAKE_PROFIT_PERCENT = 500;

// BASKET:BEGIN
// Сентябрь 2020: топ-20 USDT-пар спота Binance по обороту за август 2020 (известен до начала месяца),
// листинг не моложе 90 дней, без стейблкоинов, плечевых токенов и обёрток BTC/ETH.
const BASKET = [
  "BTCUSDT",
  "ETHUSDT",
  "LINKUSDT",
  "XRPUSDT",
  "BNBUSDT",
  "EOSUSDT",
  "LTCUSDT",
  "TRXUSDT",
  "BCHUSDT",
  "BANDUSDT",
  "OMGUSDT",
  "XTZUSDT",
  "ADAUSDT",
  "ATOMUSDT",
  "VETUSDT",
  "LENDUSDT",
  "ZECUSDT",
  "WAVESUSDT",
  "QTUMUSDT",
  "NEOUSDT",
];
// BASKET:END

const SYMBOL_LIST = [...BASKET, PARKING_SYMBOL];
const PER_SYMBOL_USD = DEPOSIT_USD / BASKET.length;

// getCandles внутри getSignal обрезан по времени движка: последняя дневная свеча - последний
// закрытый день, заглядывания вперёд нет. Cache.fn с интервалом 1d считает гейт один раз
// в день на все тикеры и сам инвалидируется при переходе движка на следующий день.
const getGate = Cache.fn(async (): Promise<number> => {
  const candles = await getCandles(GATE_SYMBOL, "1d", Math.max(...GATE_WINDOWS_DAYS) + 1);
  const closes = candles.map(({ close }) => close);
  const last = closes[closes.length - 1];
  const up = GATE_WINDOWS_DAYS.filter((days) => last > closes[closes.length - 1 - days]).length;
  return up / GATE_WINDOWS_DAYS.length;
}, { interval: "1d" });

addStrategySchema({
  strategyName: "index_fund",
  interval: "1h",
  getSignal: async (symbol, when, currentPrice) => {

    const gate = await getGate();

    const cost = symbol === PARKING_SYMBOL
      ? DEPOSIT_USD * (1 - gate)
      : PER_SYMBOL_USD * gate;

    // cost: 0 движок молча заменяет на CC_POSITION_ENTRY_COST, поэтому нулевая доля - это отсутствие сигнала
    if (cost < 1) {
      return null;
    }

    return {
      id: `${symbol.toLowerCase()}-${when.toISOString().slice(0, 10)}`,
      symbol,
      ...Position.bracket({
        position: "long",
        currentPrice,
        percentStopLoss: STOP_LOSS_PERCENT,
        percentTakeProfit: TAKE_PROFIT_PERCENT,
      }),
      cost: Math.round(cost * 100) / 100,
      minuteEstimatedTime: HOLD_MINUTES,
      payload: { gate, weight: cost / DEPOSIT_USD, basketSize: BASKET.length },
      note: `${symbol} gate=${gate.toFixed(2)} cost=$${cost.toFixed(2)}`,
    };
  },
});

addLauncherSchema({
  launcherName: "main_launcher",
  backtest: true,
  symbolList: SYMBOL_LIST,
  cache: false,
})
«Зачем нам BI, если LLM соберёт дашборд за две минуты?»
Этот вопрос сейчас слышат многие BI-команды, и часто от руководства. Ответ «LLM ошибается» убеждает всё хуже. HTML-дашборд, который модель собрала за пару минут, выглядит вполне прилично.
Сразу оговоримся: речь не о том, что LLM переоценены. Александр Нугаев, начальник управления развития и сопровождения аналитических систем Московской Биржи, ставит вопрос иначе.
"Главный вопрос для меня звучит так: Как перевести использование LLM из стадии 'игрушки на портале' в полноценный промышленный инструмент.Надо уйти от парадигмы RAG 'на коленке', когда нейросети просто скармливают документы на портале. Моя задача — ответить на вопрос, как построить надежную связку LLM и продакшн-данных в крупном энтерпрайзе, учитывая строгие ограничения информационной безопасности и корпоративной архитектуры.
Доклад посвящен применению искусственного интеллекта в сфере дата-аналитики, разграничивая задачи, которые эффективно решает традиционный BI, и области применения LLM (GenBI). В материале рассматривается соотношение ожиданий от ИИ и архитектурной реальности, подчеркивая, что генерация кода для дашбордов не отменяет необходимости создания надежного ИТ-актива.
Разбираются причины, по которым ИИ не может полностью заменить BI. Обосновывается, почему регламентная отчетность должна оставаться в BI из-за детерминированности, ответственности за данные и стоимости инференса, тогда как уникальные запросы могут эффективно закрываться с помощью GenBI.
ИИ автоматизирует рутину создания визуализаций и ответов на разовые вопросы, но архитектура данных, достоверность метрик и информационная безопасность остаются зоной ответственности человека и классических BI-систем.
Если вам предстоит объяснять руководству, зачем компании BI в эпоху LLM, после доклада у вас будут аргументы и рамка выбора, которую можно применить у себя.
Доклад «Классы задач data-аналитики: что закрывает BI-система, а что LLM-контур» прозвучит 23 октября в 17:15 на Fine Day 2026 в Москве. Это офлайн-конференция GlowByte и FanRuan о переходе от self-service BI к AI-native аналитике.
В тот же день ОТП Банк расскажет о подготовке данных для ИИ через CI/CD на FineBI, а руководители аналитики ПИК, ДИКСИ, СИБУР и АВТОВАЗ обсудят, что нужно данным и командам, чтобы ИИ заработал.
Участие бесплатное, регистрация с рабочей почты, заявки проходят модерацию: https://clck.ru/3WV5pR
Не в Москве? Онлайн-марафон про AI 9–13 ноября. Разберём реальные кейсы компаний и то, как ставить задачи агентам и проверять их выводы. Предзапись: https://clck.ru/3WV5pj
А у вас что уже ушло из BI в LLM? И какой довод сработал или не сработал в разговоре с руководством? Лучшие примеры из комментариев покажем Александру до доклада.
Логика, которая отработала на stage-стенде, часто ломается на боевых данных. В разработке эту проблему решает Git — ветки, коммиты, откаты.
На вебинаре покажем, как Apache Nessie переносит тот же подход на данные: версионирование поверх Apache Iceberg, изолированные ветки для ETL-пайплайнов и публикация только проверенных изменений. Разберем транзакционный каталог таблиц, паттерн Write-Audit-Publish, A/B-тестирование трансформаций без копирования данных и разрешение конфликтов слияния. На практике создадим ветку без копирования в S3, проверим работу DQ-гейтов и откатим продакшен к любой точке в истории одной командой.
🧑 Для кого: data-инженеров, аналитиков, DevOps и SRE, руководителей data-отделов и ИТ-директоров.
Еженедельные дайджесты новостей всё же не проходят цензуру на Хабре, увы
Краткая предыстория вопроса: в июне я писал о том, что перестаю публиковать дайджесты на Habr, т.к. позиция площадки поменялась на «финансам у нас не место, мы только про айти». К сентябрю всё же выяснилось, что финансы – это ок, а модерацию глобально волнует только политика.
Так как по этой части позиция Хабра не менялась (в правилах уже очень давно написано «Habr не для политики»), а на чисто политические темы я и так не пишу (политики и чиновники в моих материалах упоминаются только постольку, поскольку они непосредственно влияют на нашу жизнь через законы и регулирование) – я решил попробовать вернуть рубрику на площадку.
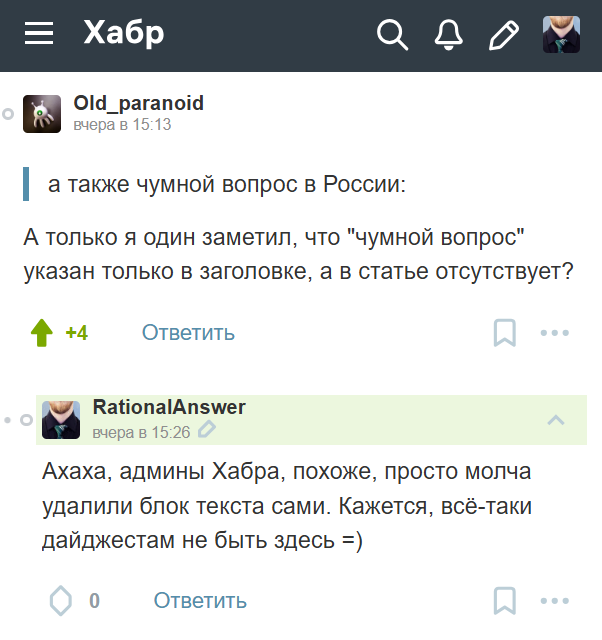
К сожалению, вынужден признать, что эксперимент по возвращению получился неудачным. В последнем дайджесте новостей модераторы Хабра просто молча (не известив меня) выпилили целый блок текста про ситуацию с чумой в Иркутске – узнал я об этом только из комментариев, где читатели спрашивали «а почему в заголовке написано про чуму, а в самой статье об этом ни слова?»
Почему эту тему модераторы посчитали «политической» – я, если честно, так и не понял. Из этой логики можно тогда смело сносить с Хабра и многие сотни материалов про коронавирус. Тем более, что подача в нашем дайджесте (см. вот здесь на Пикабу – похоже, именно там сейчас будет моя основная площадка) была крайне аккуратной и нейтральной, мы там пытались раскрыть два основных вопроса: 1) Какие есть версии произошедшего в Иркутске, и на чем они основаны? 2) Какова вероятность того, что из этого получится новая пандемия, и что про это говорят эксперты?
Вот такая вот фигня, малята. Кто хочет продолжать читать еженедельные дайджесты новостей – подписывайтесь на мой ТГ-канал, ссылки на тексты будут в любом случае появляться там (независимо от того, где они будут выходить).
У аналитиков есть много задач, к которым уже можно подключать ИИ: искать информацию, разбирать требования, фиксировать итоги встречи, работать с документами или проверять гипотезы.
Часть работы так действительно идет быстрее. Но результат все равно нужно проверить, учесть контекст и понять, подходит ли предложенный вариант для конкретной ситуации.
Ваня и Динара, аналитики Naumen, рассказали, для чего используют ИИ сейчас, что по-прежнему контролируют сами и какие навыки становятся важнее.
Что можно делегировать ИИ
Ваня, системный аналитик:
Чаще всего использую ИИ для:
поиска необходимой информации;
обработки встреч и фиксации итогов и договоренностей;
написания скриптов;
работы с документацией.
А еще с ИИ бывает проще разобраться в новой для себя области.
Динара, бизнес-аналитик:
Я использую ИИ, чтобы быстро разбирать документы и требования, находить связи, противоречия и то, что могло ускользнуть от внимания.
Еще его можно подключить на этапе «белого листа»: получить несколько подходов, от которых можно оттолкнуться.
А когда решение уже есть — проверить гипотезу: найти слабые места, задать вопросы, которые я могла не учесть, или предложить другой вариант.
Почему ИИ нужно проверять
Ваня, системный аналитик:
На мой взгляд, полностью доверять ИИ нельзя нигде. Он может галлюцинировать и терять консистентность, поэтому результат нужно проверять.
В конечном итоге ответственность за то, что получилось, будешь нести ты, а не ИИ.
Динара, бизнес-аналитик:
Тоже не воспринимаю ответ ИИ как готовое решение: его нужно проверить и понять, подходит ли он для конкретной задачи.
К тому же в начале работы не всегда ясно, какой результат нужен: мы исследуем проблему, задаем вопросы и уже в процессе уточняем цель.
ИИ может предложить варианты и другой взгляд, но определить нужный результат и учесть условия должен аналитик.
Какие навыки становятся важнее
Ваня, системный аналитик:
Важно глубже разбираться в своей области и видеть картину целиком: ИИ часто выдает отдельные фрагменты, которые аналитик должен связать между собой.
Еще один навык — работа с самим ИИ: точно ставить задачу, передавать контекст и понимать, какие данные безопасно ему отдавать.
Динара, бизнес-аналитик:
ИИ быстро подсказывает паттерны, кейсы и лучшие практики, которые раньше приходилось искать отдельно. Поэтому само знание того, «как принято делать», уже не такое большое преимущество.
Важнее сформулировать собственный замысел: понять проблему, нужный результат и ограничения. Часть условий может вообще не проговариваться, хотя именно они часто влияют на то, получится ли реализовать задуманное.
Как ИИ изменит работу аналитика
Ваня, системный аналитик:
Думаю, рутина и дальше будет уходить в автоматизацию. Будут развиваться агенты, и, скорее всего, мы придем к тому, что ИИ сможет сам генерировать гипотезы, предлагать изменения, создавать документацию и поддерживать ее в актуальном состоянии.
Аналитику при этом все равно придется валидировать результат.
Динара, бизнес-аналитик:
Для меня ИИ — не самоцель, а способ освободить время для мышления.
Чем больше рутины можно передать инструменту, тем больше времени остается на то, ради чего нужен аналитик: понять проблему, сформулировать замысел и принять решение.
ИИ может ускорить работу, но создать условия для реализации решения и взять за него ответственность остается задачей человека.
17 бесплатных вебинаров для аналитиков: ИИ, требования, бизнес-процессы и микросервисы
Привет, Хабр. Хороший анализ начинается не с документа и не с диаграммы. Сначала нужно понять, какую задачу решает бизнес, затем — разобраться с требованиями, договориться со стейкхолдерами, описать процессы и превратить всё это в понятное техническое решение.
Чем сложнее становятся продукты и системы, тем важнее для аналитика видеть картину целиком: от бизнес-целей и клиентского опыта до требований, бизнес-логики, данных и архитектуры. А ещё — уметь работать с изменениями и использовать ИИ там, где он действительно помогает ускорить рутинную работу.
В этом посте собрали 17 открытых вебинаров для тех, кто хочет развивать навыки системного и бизнес-анализа.
Luma: объединяем Data Governance, Business Intelligence и Искусственный интеллект
Вместе с Arenadata на вебинаре представили совместное решение Luma и рассказали, как интеграция каталога данных, BI-платформы и искусственного интеллекта помогает выстроить единое пространство для управления корпоративными данными и аналитики.
Обычная колода из 52 карт содержит почти немыслимое количество возможных комбинаций. Их количество сопоставимо с оценками числа атомов в нашей галактике.
Галактика в колоде карт
Для первой карты существует 52 возможных позиции, для второй — 51, для третьей — 50 и так далее. Общее число вариантов равно:
52 × 51 × 50 × … × 2 × 1.
В математике это записывается гораздо короче: 52!, или «52 факториал».
За этой компактной записью скрывается число из 68 цифр:
52! ≈ 8 × 10⁶⁷.
Это настолько много, что количество возможных порядков карт сопоставимо с оценками числа атомов в нашей галактике.
Поэтому, когда хорошо перемешанная колода оказывается у вас в руках, конкретный порядок её карт с огромной вероятностью никогда прежде не существовал. После следующей действительно случайной тасовки вы, скорее всего, получите ещё одну последовательность из 52 карт, которая появилась впервые в истории.
Но здесь возникает другой вопрос: сколько раз вообще нужно тасовать колоду, чтобы считать её хорошо перемешанной?
Исследования математиков показали удивительный результат: для обычной колоды достаточно примерно семи правильных riffle shuffle — привычных тасовок, при которых колоду делят примерно пополам, а затем переплетают две половины небольшими группами карт.
После одной или двух тасовок первоначальный порядок всё ещё хорошо заметен. Даже после четырёх или пяти в колоде сохраняется значительная структура.
А затем происходит резкий переход.
Примерно после седьмой такой тасовки распределение карт становится уже очень близким к случайному. Восьмая, девятая или десятая тасовка улучшают перемешивание гораздо меньше.
Получается своеобразный порог.
До него колода сохраняет память о прошлом. После него эта память почти исчезает.
И в этот момент простая колода из 52 карт превращается в наглядную демонстрацию того, насколько огромным может быть пространство возможных состояний: всего несколько движений рук - и перед нами возникает порядок карт, которого, вероятнее всего, никогда раньше не существовало.
Так, подъехала хорошая новость недели: мои еженедельные дайджесты новостей возвращаются на Хабр!
Я писал в июне, что мне там сообщили «Habr только про айти, иди со своими левыми темами финансируйствовай в другом месте…» Так вот, с тех пор у них там шли какие-то долгие внутренние обсуждения, и в итоге Анна (спасибо ей!) вернулась с информацией, что не-айтишные темы на ресурсе всё-таки не забанены.
Это меня радует, потому что, на мой взгляд, Хабр с большим отрывом остается самой крутой массовой UGC-площадкой в Рунете:
🐌 Благодаря системе кармы и модерации, здесь самый высокий шанс увидеть интересные-адекватные обсуждения в комментариях. Я знаю, некоторые считают «да там душнилово сплошное, Хабр уже не торт!», но я вам отвечу: ребята, во всех других местах просто всё во много раз хуже.
🐌 У Хабра самый годный редактор текстов, откуда потом очень удобно копировать статьи на другие площадки (в частности, он там не зашивает в ссылки автоматические редиректы через себя, как на VC-DTF-Pikabu-Smartlab).
🐌 Материалы на Хабре можно править даже спустя годы после их публикации (опять же, на всех остальных площадках кнопка редактирования замораживается через сутки или другой не очень долгий срок). Это удобно, если надо добавить что-то важное в свою старую статью, которую до сих пор активно гуглят (к слову, наш с Игорем Котенковым текст «Как работает ChatGPT» уже перевалил за 600к прочтений).
🐌 Кстати, про правки: на Хабре есть фича, с помощью которой любой читатель может легко отправить тебе в личку указание на опечатку. Несмотря на то, что небольшая доля хабровчан упорно пытается исправлять мои шутки, в целом – это здорово помогает вычищать материал.
Короче, надеюсь, в этот раз у нас с площадкой всё сложится. =)
Аналитик между бизнесом и разработкой: что нужно знать сегодня
Задача поставлена, но никто не может точно объяснить, что именно нужно сделать. Бизнес ждёт результат, разработчики задают десятки уточняющих вопросов, а изменения продолжают появляться по ходу проекта.
Работа аналитика — превратить этот хаос в понятную систему: выявить потребности, зафиксировать требования, найти слабые места и помочь команде прийти к правильному решению.
Подобрали бесплатные уроки, которые помогут усилить практические навыки системного и бизнес‑анализа.
Системный анализ и работа с требованиями
8 сентября, 20:00. «Системный аналитик и его ценность глазами компании». Записаться
23 сентября, 20:00. «Как системному аналитику проводить архитектурное ревью и находить риски до начала разработки». Записаться
Анализ конкурентов — полезный инструмент для продуктовой команды: он помогает понимать рынок, замечать интересные решения и находить идеи для развития продукта. Но беда в том, что собранная информация быстро устаревает.
Пока команда занята своими задачами, у других игроков появляются новые функции и меняется фокус. Поэтому в Naumen Erudite решили дополнить разовые исследования регулярным мониторингом.
Как устроен процесс и что он изменил, рассказала Таня, продуктовый аналитик Naumen Erudite.
1️⃣ Зачем продуктовым аналитикам следить за конкурентами?
Для нас здесь три основные цели:
Понимать, где находится наш продукт на рынке — какие тренды актуальны, в чем мы сильнее, а где есть точки для развития.
Развивать насмотренность — чем больше решений видишь, тем проще находить идеи для развития своего продукта.
Делиться информацией с командой — данные о конкурентах нужны не только аналитикам, но и руководителю продукта, пресейлам и проектным командам.
2️⃣ Почему решили менять прежний подход?
Информация о конкурентах хранилась в разных источниках — Google-таблицах, Jira, Miro, Confluence. Поэтому не всегда было понятно, где искать нужные данные и насколько они актуальны.
В таблице накопилось больше 50 компаний, которые мы анализировали и за которыми хотим следить. Ориентироваться в таком объеме становилось все сложнее.
Не хватало регулярности. К анализу возвращались под конкретную задачу, а затем переключались на другую работу. В результате могли долго не замечать изменения у некоторых конкурентов.
3️⃣ Как удалось собрать все в систему?
Выбрали Miro как единую базу знаний: там храним краткую информацию о конкурентах, роадмап анализа и ссылки на подробные материалы — кейсы, проекты, скриншоты, презентации и видео с мистери-шоппинга.
В Miro сравниваем конкурентов по выручке, формату работы продукта и наличию функций. За подробностями можно перейти в Confluence, на сайт или в документацию компании.
4️⃣ Как сделали анализ регулярным?
Добавили повторяющиеся задачи: раз в две недели смотрим рассылки, Telegram-каналы и обновления продуктов, а раз в полгода пересматриваем роадмап анализа.
Раз в два месяца делимся находками с продуктовыми аналитиками, руководителями проектных команд, пресейлами и руководителем продукта: кого изучили и какие обновления могут быть полезны. Например, сейчас следим, как конкуренты развивают LLM-агентов и какие возможности для них выпускают.
Мистери-шоппинг проводим, когда открытых источников недостаточно.
5️⃣ Почему недостаточно пересматривать всех конкурентов раз в год или два?
Например, игрок, который раньше работал со средним и малым бизнесом и почти не пересекался с нами, со временем может начать претендовать на тех же клиентов.
Регулярный мониторинг помогает замечать такие изменения раньше и экономить время. Если нужно изучить конкретную функциональность, мы уже примерно знаем, у кого она есть, и можем смотреть решения прицельно.
6️⃣ Как понять, кого анализировать в первую очередь?
Разделили конкурентов на четыре группы по степени влияния: высокий, средний и низкий уровень, а также косвенные конкуренты.
Для сравнения определили критерии: финансовую динамику, формат работы продукта — в облаке или инфраструктуре клиента — и наличие функций на базе LLM. Так проще ориентироваться среди 50+ компаний и выбирать, кого изучать подробнее.
7️⃣ Какие инструменты помогают следить за изменениями?
Для десяти ключевых конкурентов настроили Google Alerts — раз в неделю получаем подборку новостей о них. Еще подписались на Telegram-каналы и рассылки компаний, а раз в две недели выделяем час на просмотр источников.
8️⃣ Что изменилось после перестройки процесса?
Появилась единая база знаний, информацию об изменениях стали собирать регулярно, а нужные материалы теперь проще находить всей команде.
Процесс продолжаем развивать. Сейчас тестируем автоматизацию анализа с помощью LLM: например, используем Claude для поиска информации в открытых источниках и ее систематизации в таблицах, которые раньше заполняли вручную.
Как фильтровать результат оконных функций в ClickHouse
Когда пишешь SQL-запрос с оконками, часто необходимо сделать фильтрацию по данным, которые они возвращают, например, получить первую строку в каждой группе через ROW_NUMBER(). Для этого приходится оборачивать запрос в подзапрос и уже на уровне внешнего запроса фильтровать данные. Ну, либо использовать CTE.
В ClickHouse можно проще.
Недавно наткнулся на фичу, которая позволяет сделать такую фильтрацию вообще без использования подзапросов или CTE. Это предложение QUALIFY.
Оно работает по аналогии с WHERE, но с одним важным отличием. WHERE отрабатывает до вычисления оконных функций, поэтому оно просто их «не видит», а QUALIFY — после.
Поэтому раньше приходилось писать так:
SELECT *
FROM (
    SELECT
        id,
        category,
        ROW_NUMBER() OVER(PARTITION BY category ORDER BY created_at DESC) as rn
    FROM my_table
)
WHERE rn = 1;
А с использованием QUALIFY запрос становится короче:
SELECT
    id,
    category,
    ROW_NUMBER() OVER(PARTITION BY category ORDER BY created_at DESC) as rn
FROM my_table
QUALIFY rn = 1;
Несколько нюансов:
В QUALIFY можно фильтровать данные прямо по алиасу из SELECT и не дублировать весь код оконной функции.
Оконную функцию можно написать прямо внутри QUALIFY. Выводить её в итоговый SELECT не обязательно. Фильтрация всё равно сработает «под капотом».
Если в запросе нет ни одной оконки, QUALIFY выдаст ошибку. Для обычной фильтрации всё так же используем WHERE.
Собрали подборку из пяти материалов о разных задачах аналитика: от работы с требованиями и взаимодействия с командой до поиска решений и использования ИИ.
Как подготовить задачу так, чтобы сократить количество уточнений и переделок, расставить приоритеты и иногда найти решение без дополнительной разработки.