Chrome изменил работу window.open с несколькими мониторами
Раньше в Chrome можно было открыть окно на втором мониторе обычным window.open, передав его координаты:
window.open(url, '_blank', 'left=1920,top=0');
Теперь Chrome может ограничить позицию окна текущим экраном, если сайту не выдано разрешение «Управление окнами» (window-management). При этом в Firefox старый вариант продолжает работать.
Современное решение — Window Management API:
const details = await window.getScreenDetails();

const screen = details.screens.find(
  x => x !== details.currentScreen
);

window.open(
  url,
  '_blank',
  `left=${screen.availLeft},top=${screen.availTop}`
);
Главный нюанс: вызов getScreenDetails() запрашивает разрешение на управление окнами. После его выдачи Chrome снова позволяет корректно размещать окно на другом мониторе.
P.S. это изменение уже упоминалось в версии 135.0.7049.116 - ссылка
Аналитики считают, что российский ИТ-рынок вырастет в 2026 году всего на 4%, а к двузначному росту вернётся не раньше 2028 года. Основные причины — замедление экономики и смещение фокуса с цифровизации к поддержке базовых процессов. Мы бы ещё прибавили значительный рост цен на комплектующие и их дефицит.
Кто тянет российский рынок? Облачные сервисы — хотя в 2026 году темп роста замедлится, но все равно составит 20%. А сервис аренды GPU-мощностей — на 36% и будет столько же прибавлять до 2028 года. Полагаем, что главным драйвером развития рынка остаётся ИИ: компании разрабатывают собственные модели, локально запускают доступные мировые решения. И аналитики считают, что рост проходил бы ещё быстрее, если бы не дефицит площадок под дата-центры, из-за которого замораживаются проекты постройки новых ЦОДов. RUVDS уже писала, что повышение аренды земли под вычислительные комплексы в десятки раз — не лучший стимул для развития отрасли.
Возвращаясь к дефициту компонентов, он приводит к интересным последствиям — аналитики OCS сообщили, что впервые поставки серверных SSD превысили продажи жестких дисков для серверов. Хотя твердотельные накопители дорожают быстрее, в условиях ограниченных ресурсов компании выбирают более эффективное решение. Производству жёстких же дисков мешает дефицит комплектующих — производители начинают уделять внимание самым топовым моделям, но они стоят дороже и у клиента уже возникают вопросы — не целесообразнее ли купить HDD. Естественно, базовые преимущества SSD (скорость) и жёстких дисков (низкая цена хранения) остаются, и в мировом масштабе основная информация хранится именно на HDD.
В итоге облачные провайдеры остаются оптимальным решением: они за пользователя решают проблему с дефицитом и удорожанием комплектующих и дают ему возможность без капитальных инвестиций проверить, серверы на каких комплектующих нужны для бизнеса.
На митап в нашем офисе зарегистрировалось несколько сотен специалистов. Принять в гостях в офлайн смогли лишь небольшую часть из них. Так что выложили записи выступлений спикеров в открытый доступ, чтобы посмотреть их мог каждый.
> Deepcoding — новый уровень энтерпрайз разработки Спикер: Виктор Карпов, Frontend developer Garage Eight YouTube | VK Видео
> Используем AI для ускорения продуктового цикла от discovery до delivery Спикер: Ксения Лысенко, Product Manager Garage Eight YouTube | VK Видео
> От страха до эйфории: как разные люди адаптируются к AI-инструментам Спикер: Анастасия Жукова, разработчик core-решений для работы с AI в MWS YouTube | VK Видео
Погонял llama.cpp на пяти NVIDIA CMP 90HX и сравнил layer split с tensor split.
Конфигурация:
5 × NVIDIA CMP 90HX по 10 ГБ
суммарно llama.cpp видит 49 383 MiB VRAM
4 карты подключены по PCIe x8
1 карта подключена по PCIe x4
применен rejoin15
модель - Qwen3.8-27B-Heretic
квант - Q8_0
размер GGUF - 26.62 GiB
параметров - 26.90B
llama.cpp build e107984
распределение по GPU - 1/1/1/1/1
все слои загружены на GPU
KV cache - F16, тоже на GPU
Flash Attention - auto
С tensor split картина получилась довольно интересная.
На пустом контексте генерация выросла с 23.76 до 31.93 tok/s. Это примерно +34%.
На 32K контекста - с 22.15 до 31.06 tok/s, то есть уже около +40%.
Для чистой генерации tensor split реально быстрее.
Но есть обратная сторона - prompt processing просел очень сильно.
На пустом контексте:
Layer - 1992.67 tok/s
Tensor - 268.46 tok/s
На 32K:
Layer - 1457.97 tok/s
Tensor - 246.84 tok/s
То есть обработка входного контекста в tensor split получилась примерно в 6-7 раз медленнее.
На 64K tensor-тест дальше не пошел - модель выгрузилась из памяти. Причину пока отдельно не разбирал, поэтому данные для tensor на 64K, 96K и 128K не привожу.
Layer split при этом нормально прошел весь тест до 128K.
Скорость генерации по мере заполнения контекста:
0K - 23.76 tok/s
32K - 22.15 tok/s
64K - 20.75 tok/s
96K - 19.53 tok/s
128K - 18.44 tok/s
То есть даже при 128K контекста dense-модель на 26.9B параметров в Q8 все еще работает со скоростью около 18.4 tok/s.
Prompt processing тоже падает постепенно, без резкого провала:
0K - 1992.67 tok/s
32K - 1457.97 tok/s
64K - 1136.52 tok/s
96K - 916.35 tok/s
128K - 724.86 tok/s
Для обычного чата tensor split может быть интересен, если контекст короткий, а ответы длинные. Там прирост с 24 до 32 tok/s ощущается.
Но если чат уже большой и модель каждый раз должна перерабатывать много входных токенов, выгода быстро начинает пропадать из-за очень медленного prefill.
Для кодового агента вроде Hermes я бы оставил layer split.
Агент постоянно читает файлы, получает куски исходников, и добавляет все это в контекст. В таком режиме скорость обработки входа важнее, чем дополнительные 8 tok/s на генерации.
Плюс layer split у меня стабильно работает вплоть до 128K, а tensor пока отвалился уже при переходе к 64K.
Итог пока такой:
короткий чат и длинные ответы - tensor split может быть быстрее
длинный чат - уже спорно
кодовый агент и большие проекты - layer split выглядит намного практичнее
Сами CMP 90HX тоже порадовали. Qwen3.8-27B dense Q8 дает около 24 tok/s на пустом контексте и около 18.4 tok/s на 128K.
После того как выкрутил вентиляторы на 100%, самая горячая карта держится примерно на 65 градусах.
Добавили в маркетплейс дополнений для Kubernetes аддон cert-manager CSI Driver — он выдает TLS-сертификаты подам напрямую, без Certificate и Secret.
Классическая схема с Secret имеет слабое место: секреты лежат в etcd и доступны любому с правами на namespace. CSI Driver убирает посредника:
1️⃣ У каждого пода своя пара ключей — приватный ключ генерируется прямо на ноде и не передается по сети.
2️⃣ Ключ удаляется вместе с подом — не остается зависших секретов, которые нужно чистить
3️⃣ Сертификаты обновляются автоматически — без ручных перевыпусков и просроченных TLS
Пригодится, когда сервисы внутри кластера подтверждают подлинность друг друга по сертификатам. После настройки каждый под автоматически получает свой сертификат и приватный ключ при запуске.
Как установить: откройте кластер → Дополнения → cert-manager CSI Driver. Понадобится cert-manager — он тоже есть в маркетплейсе.
SpaceWeb — 25 лет. По этому поводу мы спрятали немного истории и раздаем подарки
Привет, Хабр! На связи команда хостинг-провайдера SpaceWeb. Сегодня, четвертого сентября, нам исполняется 25 лет. За это время мы прошли путь от первых сайтов на хостинге до VDS, облачной инфраструктуры и ИИ в техподдержке — и накопили достаточно историй, чтобы не ограничиваться обычным юбилейным постом.
К 25-летию мы уже выпустили на Хабре серию материалов под хэштегом #spaceweb25лет. В них вспоминаем, как менялся рынок хостинга, спорим о будущем shared-хостинга, обсуждаем ИИ-агентов с админскими правами, клиентский сервис, наем и то, кто вообще будет выбирать провайдера через следующие 20 лет — человек или AI.
А теперь предлагаем проверить, насколько внимательно вы всё это читали.
Мы собрали небольшой юбилейный квест из 10 вопросов. Ответы специально не лежат рядом с формой: за ними придется немного побродить по нашим статьям на Хабре, сайту SpaceWeb и соцсетям. Где-то нужно найти факт из истории компании, где-то — пасхалку, а где-то вспомнить техническую деталь из одного из материалов.
Например, придется выяснить, на чем был запущен самый первый сайт SpaceWeb, каким словом наш коммерческий директор описал состояние shared-хостинга, как зовут паука-птицееда, которого мы опекаем в Ленинградском зоопарке, и сколько сайтов сегодня размещено на нашем хостинге.
Участвовать может любой — быть клиентом SpaceWeb или зарегистрированным пользователем Хабра для этого не обязательно. Ответы принимаем до 11 сентября, а 16 сентября определим победителей. Среди участников разыграем фирменный мерч и подарки от SpaceWeb.
И еще один подарок без всяких вопросов и розыгрышей: по промокоду #spaceweb25 можно получить скидку 20% на услуги хостинга и VDS.
25 лет для интернет-компании — срок приличный. Поэтому предлагаем заодно посмотреть, сколько всего успело поменяться за это время и какие вещи, наоборот, пережили уже несколько поколений технологий.
Переходите на страницу юбилейного квеста, отвечайте на все вопросы и участвуйте в розыгрыше. А если какой-то ответ не знаете — скорее всего, мы уже где-то спрятали его в материалах по тегу #spaceweb25лет.
KiroCrew: персональный AI-ассистент с памятью и автономностью
Автономный агент с persistent memory, планировщиком задач, фоновыми subagents и поддержкой множества каналов коммуникации
Введение
Привет. В эпоху ИИ, новые инструменты растут как грибы и можно потеряться от разнообразия оных. В своей практике получилось использовать KiroCrew, чем мне он очень понравился, поэтому рассказываю про него вам.
KiroCrew - это персональный AI-агент, который работает локально на вашей машине поверх kiro-cli (KiroACP) или на сервере с доступом через браузер или десктоп клиент.
Установка и первый запуск
KiroCrew можно запустить разными способами - выберите подходящий сами, веб сервер с браузером или настольное приложение.
Предпочтения: стиль кода, предпочитаемые инструменты, формат ответов. Обновляются автоматически после ~30 сообщений.
Контекст проекта: над чем вы работаете, ключевые решения, блокеры.
Историю: сводки по дням с естественным затуханием (14 дней - полная детализация, далее - сжатие).
Уроки: исправления, которые вы даёте агенту. Сказали «всегда используй pytest» - запомнил навсегда.
Память работает в трёх режимах: Нормальная работа, Конфиденциальные задачи, Изолированные эксперименты. Режимы переключаются прямо из дашборда.
Векторная память использует Qwen3-Embedding-0.6B (около 610 MB), который качается автоматически при первом запуске. Семантический поиск по памяти работает «из коробки» - никаких внешних серверов не нужно.
Cron-задачи: автономное выполнение по расписанию
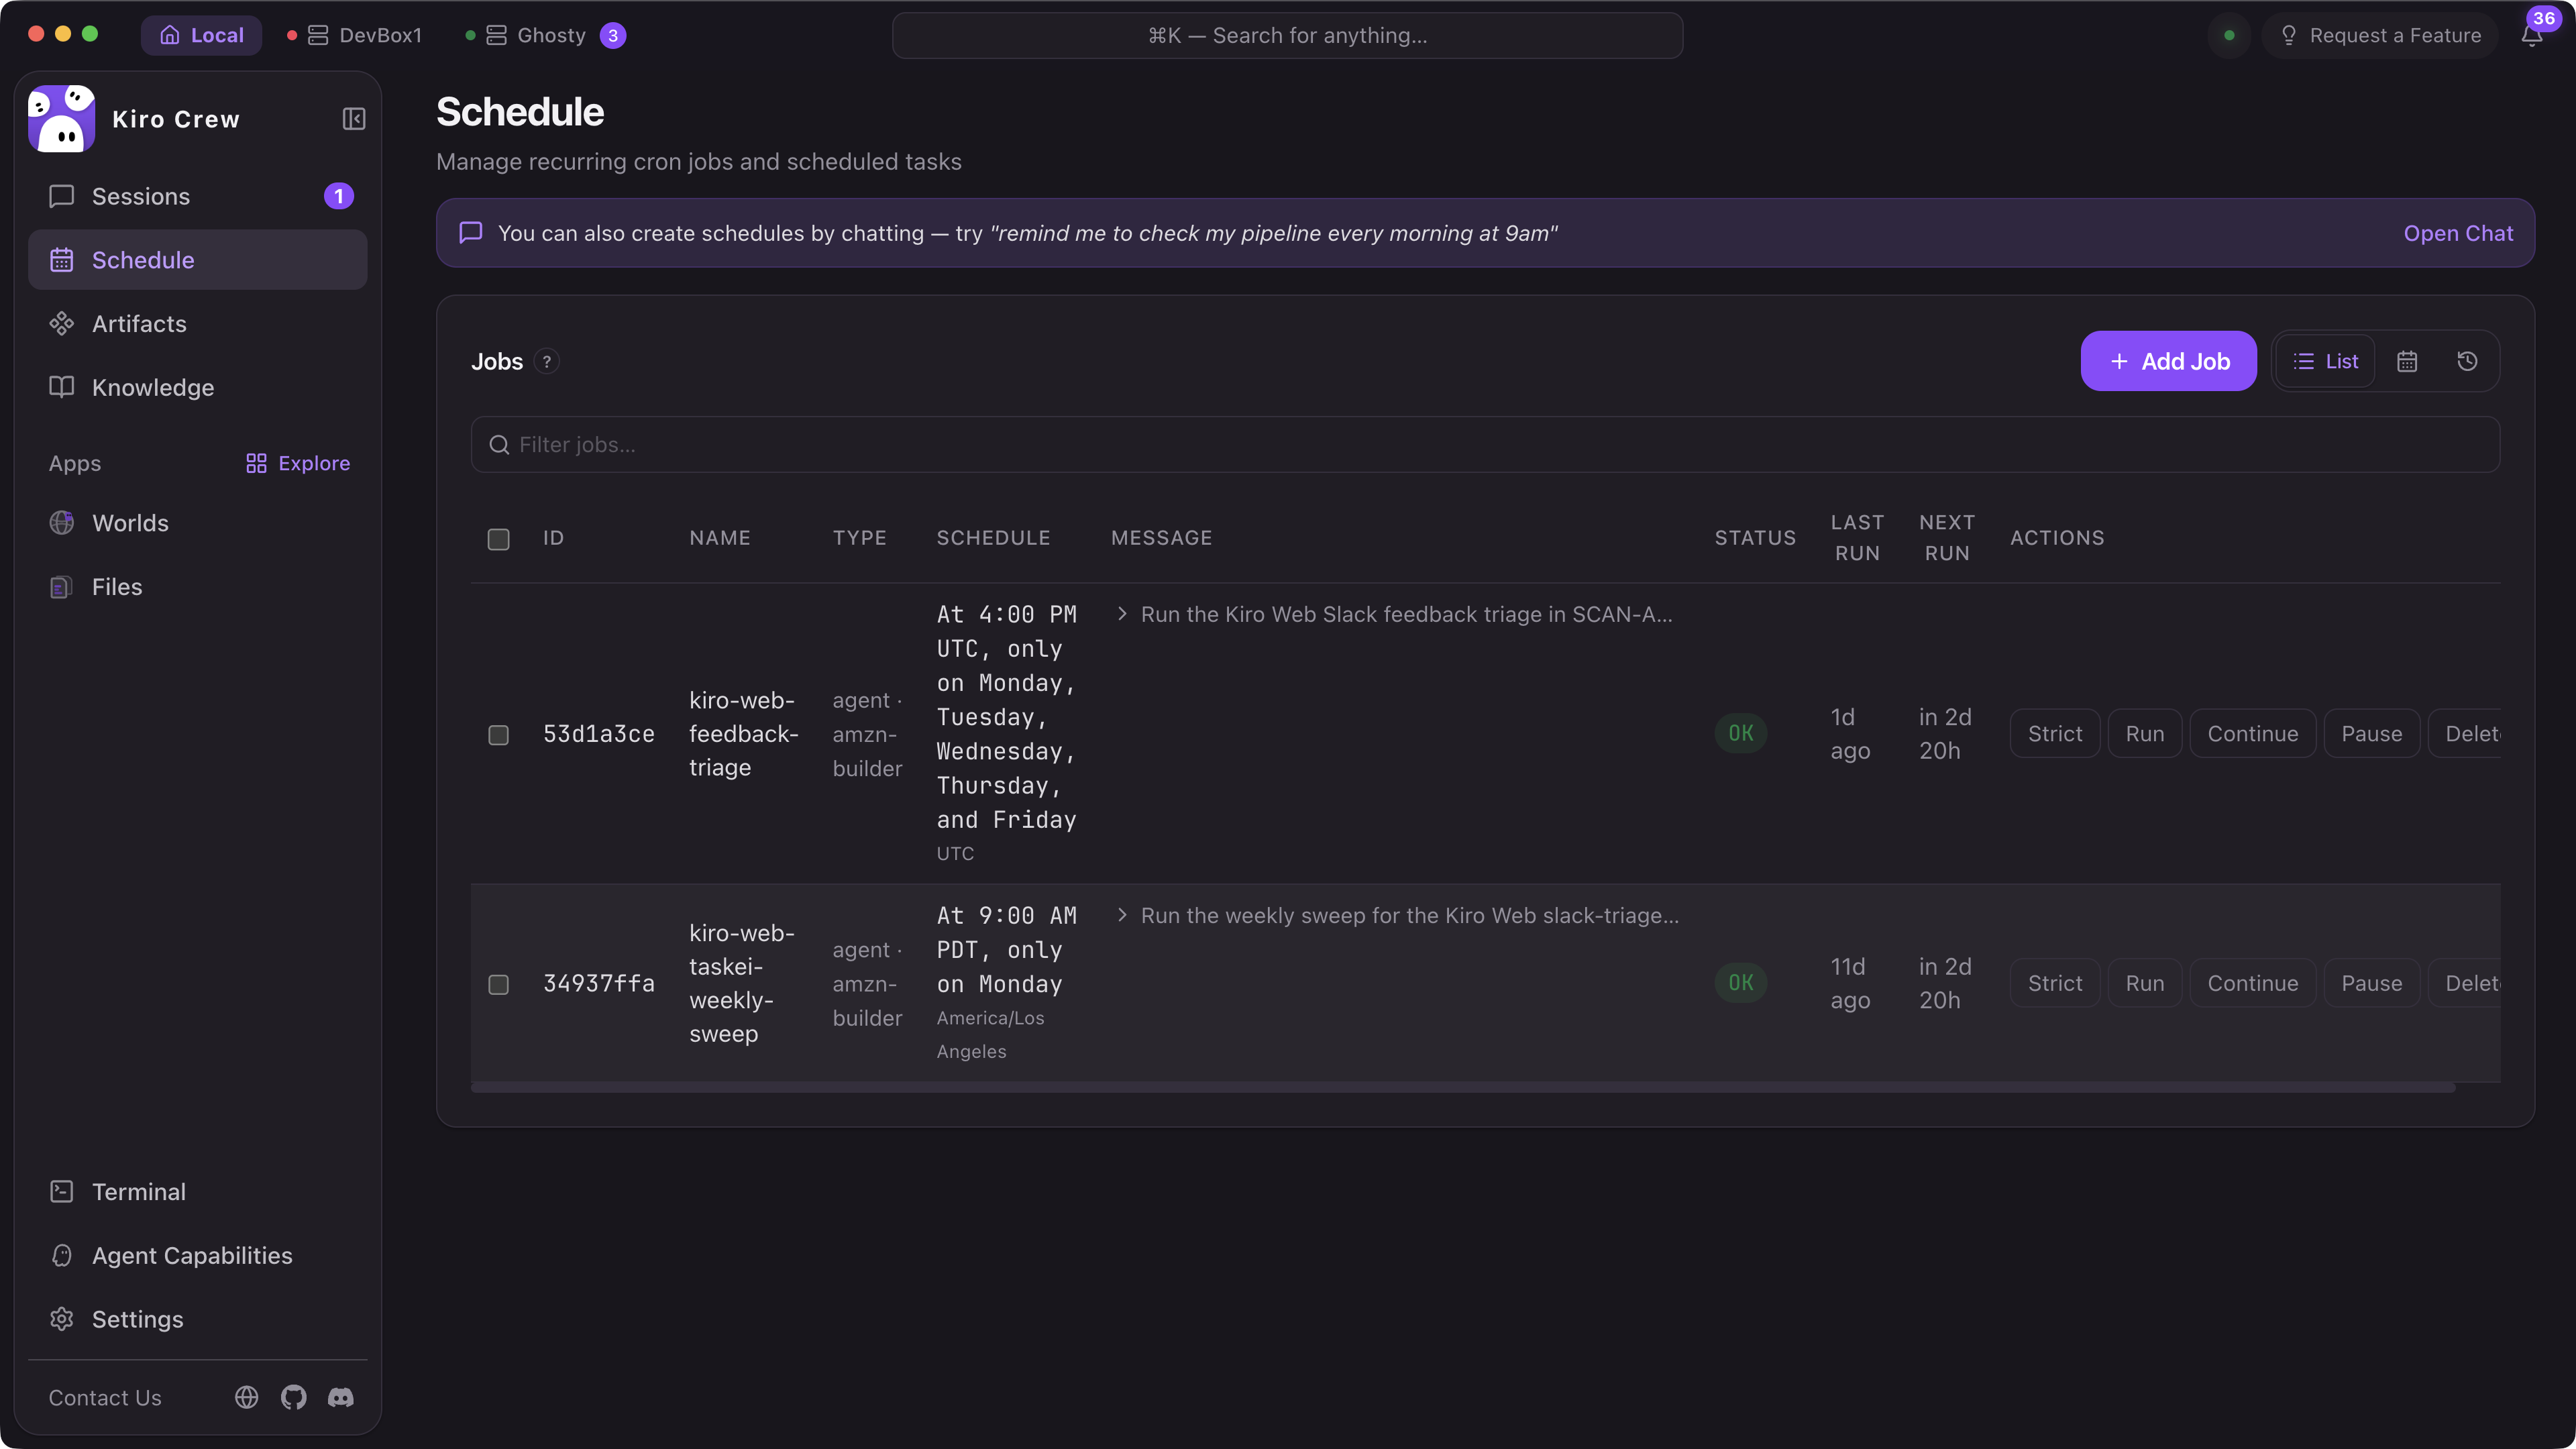
KiroCrew может выполнять задачи по расписанию без вашего участия Скриншот программы Каждая задача запускается в изолированной LLM-сессии с полным доступом к инструментам.
Дополнительные возможности
Subagents: умеет запускать параллельных фоновых агентов (subagents) для одновременного выполнения задач.
Self-learning: агент учится на ваших исправлениях
Skills: навыки подгружаются автоматически по контексту запроса.
Task Runner: автономное выполнение многошаговых задач из спеки
Research Lab: многоцикловые исследовательские кампании с экспортом отчётов
Энтузиаст запустил учебный игровой онлайн‑ресурс Ports decomp/recomp, который отслеживает проекты портирования классических консольных игр на современные платформы. Решение аккумулирует информацию о нативных ПК‑портах, созданных на основе декомпиляции или обратной компиляции кода. На портале отслеживаются версии для Windows, Linux, macOS, iOS и Android.
Текущая база данных ресурса содержит 118 проектов для самых разных консолей — от Game Boy и NES до PlayStation 2 и Xbox 360.
Уникальность площадки в том, что это автоматизированный реестр, а не строго курируемый вручную список. С учётом современной волны нейросетей, облегчающих декомпиляцию и портирование игр, проект рискует столкнуться с наплывом низкокачественных портов. Однако такой подход позволит наглядно увидеть реальную статистику: какие фанатские порты забросят сразу после первого релиза, а какие продолжат активно развиваться годами. Никаких игровых файлов или ROM‑образов сайт не распространяет.
А начну с того, что мне на работе купили комплект для усиления связи. Казалось бы всё просто , направь внешнюю антенну в сторону вышки, внутреннюю относи подальше от внешней и направь в противоположную сторону Про поляризацию не забудь и всё - профит. Нет
1️⃣ Во первых я бы не стал выбирать оборудование без поддержки со стороны производителя. Телеграм чаты , почта , номер телефона - это офигеть какой плюс , когда работаешь с чем-то новым. Я ой как не завидую тем , кто взял оборудование у ноннейма, который уже закрылся.
Во вторых выбрать надо правильно, антенна с более высоким dbi якобы лучше , однако - это маркетинг. На практике высокий dbi лучше подойдёт на открытых пространствах - он бьёт более узким лучом и дальше.
В городе, где много препятствия и есть пере отражения - лучше будет небольшой Dbi - он бьёт широким лучом и лучше ловит пере отражённый сигнал. Благо, у моей был 10-11dbi оптимальный средний вариант
Перед началом работы не будет лишним проверить работоспособность репитера, например так ссылка
2️⃣ Ещё часто советуют направить антенну в сторону вышки. В сторону вышки сигнал может быть хуже, правильнее не воспринимать однозначно совет "направлять в сторону базовой станции - БС." Так как есть отражения , гашение, усиление волны ( она же интерференция ) и хороший сигнал вообще из отверстия в сельском туалете может идти , туда и надо ставить внешнюю антенну. Это я не к тому, что именно там надо искать, я к тому , что место может быть неожиданным.
3️⃣ Вряд-ли у простых смертных будет анализатор спектра, так что для выбора "сладкой точки" - места с уверенным сигналом. можно использовать смартфон или USB модем с аккумулятором. Иногда модемы надо перепрашивать для получения нужных данных. Но это отдельная история, которую можно решить на сайте 4pda
4️⃣ На принимающем устройстве (смартфон/модем) надо смотреть на 2 показателя: RSRP и SINR Чем выше SINR, тем меньше шума в сигнале Чем ближе RSRP к нулю, тем лучше уровень сигнала от БС.
После того как место найдено, можно искать идеальное положение для антенны, разница в высоте установки 5-10 см может играть существенную роль - спасибо зонам Френеля
5️⃣ внутреннюю антенну лучше повесить там где сигнал плохой - это очевидно, но можно стать жертвой заблуждения, якобы антенну, которая внутри можно вешать где угодно. Кстати она не должна смотреть в сторону внешней
6️⃣ если всё сделано по инструкции, а результат не оправдывает ожиданий, стоит проверить антенну в другой части города, чтобы понять, что происходит - антенна не работает или на объекте сложная радиочастотная ситуация.
7️⃣ я нашёл блестящую точку (sweet spot, перспективную область) сигнал там сильный и он перегружает усилитель. Теперь надо по возможности сохранить хорошее усиление и избежать перегрузки. буду работать на повышение SINR - а можно было взять пассивный набор без усилителя и завести сигнал в здание за мазя - но опыта не было , так что работал с тем что было.
8️⃣ аттенюаторы - для гашения избыточного сигнала их применяют. Тут может быть путаница, часто говорят не о форм факторе разъёма, а о сопротивлении - подразумевая форм фактор. Например: аттенюатор 75 ом , подразумевает разъём F типа , как для кабельного ТВ. Часто их сложно найти.( я себе заказывал из Англии ) Как правило используют 50 ом, подразумевая N разъём.
9️⃣ на что крепить ? У каждого свои варианты , но я нашёл длинную трубу от рекламного баннера и решил прикрутить к другой трубе... благо я нашёл прекрасное крепление для этого в магазине сантехники
🔟 хотите дать сигнал в другие комнаты - не выйдет , если это бетонные стены , покупайте делитель и доп внутренние антенны.
По итогу я добился своими действиями улучшения сигнала с -105 до -82db , что соответствует отличному уровню сигнала. Да +22дб , но интернет ощутимо лучше стал работать.
Одно из преимущество размещения системы складского учёта на своём хостинге по сравнению с облаком.
Крупные SaaS‑сервисы — «вкусная» мишень для DDoS‑атак, ведь упавший гигант парализует тысячи компаний. Self‑hosted система убирает ваш бизнес из этого «списка массового поражения»: отдельный сервер не представляет интереса для масштабных атак, а значит, риски простоя снижаются.
Когда компания перерастает файловые серверы, дорог обычно две: публичное облако или собственная инфраструктура. Для банков, госсектора и промышленности первая часто закрыта регуляторикой, и тогда встает вопрос, из чего собирать хранилище у себя. VK Tech отвечает на него готовым программно-аппаратным комплексом: корпоративный Диск VK WorkSpace работает в нем поверх объектного хранилища VK Object Storage.
Коробка вместо конструктора
Программно-аппаратный комплекс (ПАК) объединяет серверы, СХД и программную платформу в единый поставляемый продукт. Заказчик получает протестированную производителем связку железа и софта с гарантированными характеристиками, а разворачивается она на его собственной площадке.
VK Object Storage поставляется в трех вариантах: облачный сервис, ПО для установки на оборудование заказчика и ПАК. Третий вариант дает максимум предсказуемости: сборка, совместимость и производительность проверены до отгрузки, поэтому сроки запуска считаются заранее.
Два уровня одной системы
Диск VK WorkSpace закрывает пользовательский уровень. Это корпоративное хранилище для централизованного размещения файлов. Поддерживается совместная работа с документами в реальном времени через интеграцию с Р7-офис. Администратор может настроить квоты для сотрудников, общие папки и права доступа к ним. База пользователей подтягивается из внешних LDAP-каталогов.
VK Object Storage выполняет роль бэкенда хранения. Это объектное хранилище корпоративного класса с поддержкой стандарта S3 API, рассчитанное на данные любого типа и объема: от пользовательских файлов до резервных копий баз данных и производственных систем.
Всё, что сотрудники загружают в Диск, физически ложится в объектное хранилище на оборудовании комплекса. Пользователь этой кухни не видит и продолжает работать с привычными папками, файлами и правами доступа.
Что комплекс дает на практике
Возможность масштабирования. Емкость не упирается в пределы отдельных дисковых массивов: комплекс наращивается горизонтально, добавление узлов увеличивает и объем, и производительность. На реальных внедрениях решение обслуживает массивы неструктурированных данных объемом свыше петабайта.
Отказоустойчивость. Стабильность работы достигается балансировкой нагрузки на маршрутизаторах и отказоустойчивой архитектурой инфраструктуры. Перед вводом в эксплуатацию комплекс проходит обязательные нагрузочные тесты и учения по аварийному восстановлению прямо на площадке заказчика.
Хранилище в периметре организации. Хранилище разворачивается внутри контура заказчика и настраивается под его политики информационной безопасности. Для компаний, работающих с персональными данными или критической производственной информацией, это принципиально.
Единый интерфейс вместо зоопарка инструментов. Администратор управляет и пользовательским доступом через Диск VK WorkSpace, и инфраструктурным слоем через VK Object Storage. Мониторинг, жизненный цикл данных и политики резервного копирования настраиваются из единого инструментария.
Кому это полезно
Промышленным предприятиям. Файлы сотрудников, медиаконтент, данные MES-систем и резервные копии баз данных живут в одном хранилище.
Финансовому сектору и госструктурам. Регуляторика исключает публичное облако, а ПАК держит данные внутри организации.
Проектам в области больших данных и ИИ. Объектное хранилище служит фундаментом для накопления и обработки датасетов под аналитику и нейросетевые модели.
В итоге один отечественный комплекс закрывает весь цикл работы с корпоративными данными: от повседневной совместной работы сотрудников до резервного копирования и долгосрочного архива.
Узнать больше о ПАК VK WorkSpace можно на сайте. Цифровая среда для корпоративных коммуникаций в вашем контуре: оборудование, ПО, настройка и поддержка от VK Tech.
Digital Q.DataBase 18.2 | Выполняем Oracle-скрипты в DBeaver и qclient
В этом коротком видео я демонстрирую работу модуля Onyx в Digital Q.DataBase и выполнение PL/SQL-скриптов, написанных для Oracle Database.
► В основном примере (через qclient) выполняется полноценный PL/SQL-сценарий: создаётся таблица, объявляются PACKAGE и PACKAGE BODY с процедурами, используется отдельная функция и анонимный PL/SQL-блок.
В скрипте используются характерные для Oracle механизмы: NUMBER, VARCHAR2, CLOB, SYSDATE, DUAL, ADD_MONTHS, а также пакеты DBMS_LOB и DBMS_OUTPUT. Скрипт компилируется и выполняется непосредственно в модуле Onyx.
► Также показываю, что работать с Onyx можно привычным способом через DBeaver.
Подключаемся к Digital Q.DataBase по характерному для Oracle порту 1521 и прямо из SQL-редактора выполняем обычный PL/SQL-скрипт: создаём таблицу employees_1, хранимую процедуру add_employee_1, вызываем её через CALL и проверяем результат обычным SELECT.
То есть для разработчика работа выглядит привычно: DBeaver, PL/SQL, процедуры, Oracle-типы и Oracle-синтаксис - но исполняется всё в Digital Q.DataBase Onyx.
Это позволяет переносить существующие Oracle-приложения и PL/SQL-код с минимальным объёмом изменений.
При этом для работы с Digital Q.DataBase можно использовать и привычные специалистам по Oracle инструменты: существующие средства администрирования, разработки и подключения могут работать с модулем Onyx через Oracle-совместимый интерфейс и порт 1521.
Всем доброго времени суток. Несколько дней назад я опубликовал ссылку на три онлайн-справочника по STEM-тематике, которые полностью написал Codex (GPT Sol Ultra). Это физика, высшая математика и схемотехника.
Комментатор (большое ему спасибо) сразу обратил внимание что по схемотехнике агент Codex меня обманул, он выдал макет справочника, а не реальный справочник, в каждой карточке фактически стояли заглушки.
Я выяснил что с физикой была ровно такая же ситуация, а вот с математикой все было норм, воспаление хитрости агента, который этим справочником занимался, обошло стороной.
Это надо было исправить, и в этот раз я подошел к вопросу более ответственно. Сперва я начал со справочника по матеше, там хоть и по содержанию все было норм, UX-дизайн мне показался слишком отвлекающим, плюс сам по себе аудит со стороны внешней LLM не помешал бы. Занимался этим Opus 5 через Claude Code.
Текст оказался нормальным, ошибок в определениях и примерах почти не нашлось. Но обвязка вокруг него была той же заглушкой, что и в схемотехнике: во всех 76 обычных параграфах «цели» и «маршрут параграфа» собирались автоматически из названий подтем. Их он убрал и переделал дизайн, чтобы он был более спокойным и не отвлекал от текста.
Со справочником по схемотехнике все было сделано более интересно. Первоначальное наполнение справочника я делал через ZCode на модели GLM 5.3 Flash, было интересно проверить ее способности, мне она показалось довольно прикольной, плюс за 16-18 бачей в месяц на плане Lite тебе давали ~300 млн токенов в неделю (!!!).
А потом было несколько фаз аудитов. Первый аудит прошел на том же агенте, он нашел ошибки и исправил их. А уже после этого аудит был отдан Codex. Он нашел несколько десятков ошибок (и фактологогического характера, и технического), и исправил их, но в целом Codex сказал что предыдущий агент провел достойную работу, какой-то откровенной отстебятины не было.
У учебника по физике аудит тоже проходил в несколько фаз. Сначала я ткнул тому же агенту, который выдал мне макет, в то что он мне дал кусок *продукта* а не справочник, и он побежал это исправлять.
После того, как он закончил, я дал итоговый результат на аудит Opus 5, чтобы он проверил фактологические, педагогические и UX-ошибки. Нашел много всего, но исправления я поручил тому же Codex агенту.
Итоговые результаты смотреть здесь (Github Pages):
Разработчики обычно не останавливаются долго на одном уровне. У всех со временем появляются новые задачи: высокие нагрузки, сложные архитектурные решения, оптимизация производительности, работа с внутренними механизмами языка.
Но есть одна проблема: свои знания сложно оценивать объективно. То, что кажется хорошо знакомым после нескольких лет работы, иногда скрывает пробелы в фундаментальных концепциях.
Короткий технический тест помогает проверить себя: какие темы уже хорошо закрепились, а какие стоит изучить глубже.
Можно оценить знания по направлениям:
— Java: язык, JVM, коллекции, многопоточность и практики разработки; — Go: особенности языка, конкурентность, работа с памятью и создание сервисов; — C# и ASP.NET: платформа .NET, веб-разработка и ключевые инструменты экосистемы; — Rust: владение памятью, система типов и особенности безопасной разработки.
Пройдите вступительный тест и получите ориентир, какие темы стоит изучить дальше.
Сотрудник просит согласовать отпуск с понедельника по пятницу. В такой ситуации я всегда уточняю, понимает ли он, как начисляются отпускные.
Уходя в отпуск, ты лишаешься части зарплаты, но взамен получаешь компенсацию в виде отпускных. Вопрос в том, покрывают эти деньги потерю в зарплате или нет.
Потеря зарплаты считается, как отношение рабочих дней, помноженное на оклад.
Отпускные рассчитываются, как отношение календарных дней, помноженное на среднюю зарплату за последние 12 месяцев.
Что больше, оклад или средняя зарплата за год? Если недавно было повышение, очевидно, оклад будет больше. С другой стороны, если за прошедший год было много премий и переработок, они увеличат среднюю зарплату. Для простоты будем считать, что они примерно равны.
Теперь посмотрим на отношение дней. Пропущенные рабочие дни делятся на число рабочих дней в месяце (тут полезно заглянуть в производственный календарь, чтобы исключить праздники из подсчёта). Календарные дни отпуска делятся на 29,3.
Пример: в августе 2026 года я неделю был в отпуске. Т.е. отсутствовал 5 рабочих дней из 21, а отдыхал 7 дней.
Потеряно от зарплаты: 5 / 21 = 23,81%
Получено в виде отпускных: 7 / 29,3 = 23,89%
Как видим, доли почти равны. А если бы я оформил отпуск строго с понедельника по пятницу?
Потеряно от зарплаты: 5 / 21 = 23,81%
Получено в виде отпускных: 5 / 29,3 = 17,06%
Разница весьма ощутимая. Тут уже сотрудник должен решить, что ему важнее: деньги сейчас или сэкономленные отпускные дни потом.
«Дональд Трамп. Искусство сделки» Дональд Трамп, Тони Шварц
Вот это, конечно, надо читать прям сейчас. Такие возможности случаются крайне редко.
Судите сами. Успешный бизнесмен в 1987 году пишет книгу. Рассказывает, как заключал множество сделок, излагает принципы достижения победы и некоторые свои секреты. Книга становится бестселлером, а автор, и до того популярный, поднимается ещё выше. Всё хорошо, автор молодец – сделки заключил (факт), книжку об этом написал (тоже факт).
А потом бац! – и автор становится президентом США. Прямо сейчас, на наших глазах! И какое слово повторяет чаще всего? Сделка! С первых дней говорит, что будет заключать сделки!
Не удивительно, правда? Автор ведь мастер сделок – есть и факты, и книга. Но…
Применимы ли сейчас методы, которые он изложил в книге? Как они работают в другой, не бизнесовой среде?
Всё это – новые факты о применении автором навыков заключать сделки – мы можем наблюдать в прямом эфире. И эта возможность – поистине колоссальная.
Представьте, например: Ли Куан Ю был бы жив и возглавил бы другую страну, не Сингапур. И попробовал бы так же его развить, как в своей книге написал. Или Макиавелли пустили бы в Евросоюз, на должность какого-нибудь заместителя (его, вроде, уровень). Адизесу дали бы в управление завод на Урале. И т.д.
Одно дело – написать книгу по факту, изложить опыт и сказать, что он вполне себе применим в другом контексте. А если кто-то взял опыт, попробовал применить и провалился – сказать, что сам дурак.
Совсем другое дело – блюдо, как говорится, от шефа. Когда автор взялся повторить и превзойти свои же успехи, своими же методами, но на более высоком и сложном уровне. Это, друзья, просто Парад Планет.
P.S. Книга, кстати, хорошая. Про упорство, «не сдаваться» и всегда искать варианты (почти как у Кови в «Третьей альтернативе»).
Очень надеюсь, что когда-нибудь автор напишет про опыт заключения сделок уровня государств.
Если всё ещё думаете, чем поздравить IT-команду, у нас есть вариант: выездная квест-комната «Комната Анонима», которую можно организовать прямо в офисе.
Не нужно никуда ехать и освобождать весь день — формат легко встроить в рабочий график.
Недавно написали материал, в котором рассказали, что находится внутри квест-комнаты и почему она может подойти именно вашей команде.
Сервис тормозит, а мониторинг ничего не показывает: разбираемся с eBPF
Сервис начал отвечать медленнее, пользователи жалуются на ошибки, а привычные дашборды показывают только рост задержек. Где искать причину, если приложение, сеть и инфраструктура выглядят «почти нормально»?
В таких ситуациях инженерам приходится спускаться глубже — к событиям внутри Linux-ядра. Один из инструментов для этого — eBPF: технология, которая позволяет получать данные о работе системы без остановки сервисов и точнее находить узкие места в продакшене.
На открытом уроке курса «DevOps практики и инструменты» вместе с преподавателем разберём, как eBPF помогает исследовать сетевые взаимодействия, производительность и безопасность современных систем. Посмотрим, какие задачи он решает в реальной эксплуатации и где его применение действительно оправдано. Когда: 23 сентября в 20:00. Присоединяйтесь
А пока можно посмотреть другие темы бесплатных уроков месяца в дайджесте.