Обновить

Все потоки

Сначала показывать
Порог рейтинга

Инверсия моноуральной передаточной функции в бинауральной звукозаписи и рендеринге

Предложенный метод решает фундаментальную проблему «чужой анатомии» и двойного фильтра при воспроизведении бинаурального звука через акустические системы. Технология позволяет полностью исключить наложение частотных и фазовых искажений искусственной модели на индивидуальный слуховой аппарат слушателя.

Алгоритм работы и суть технологии

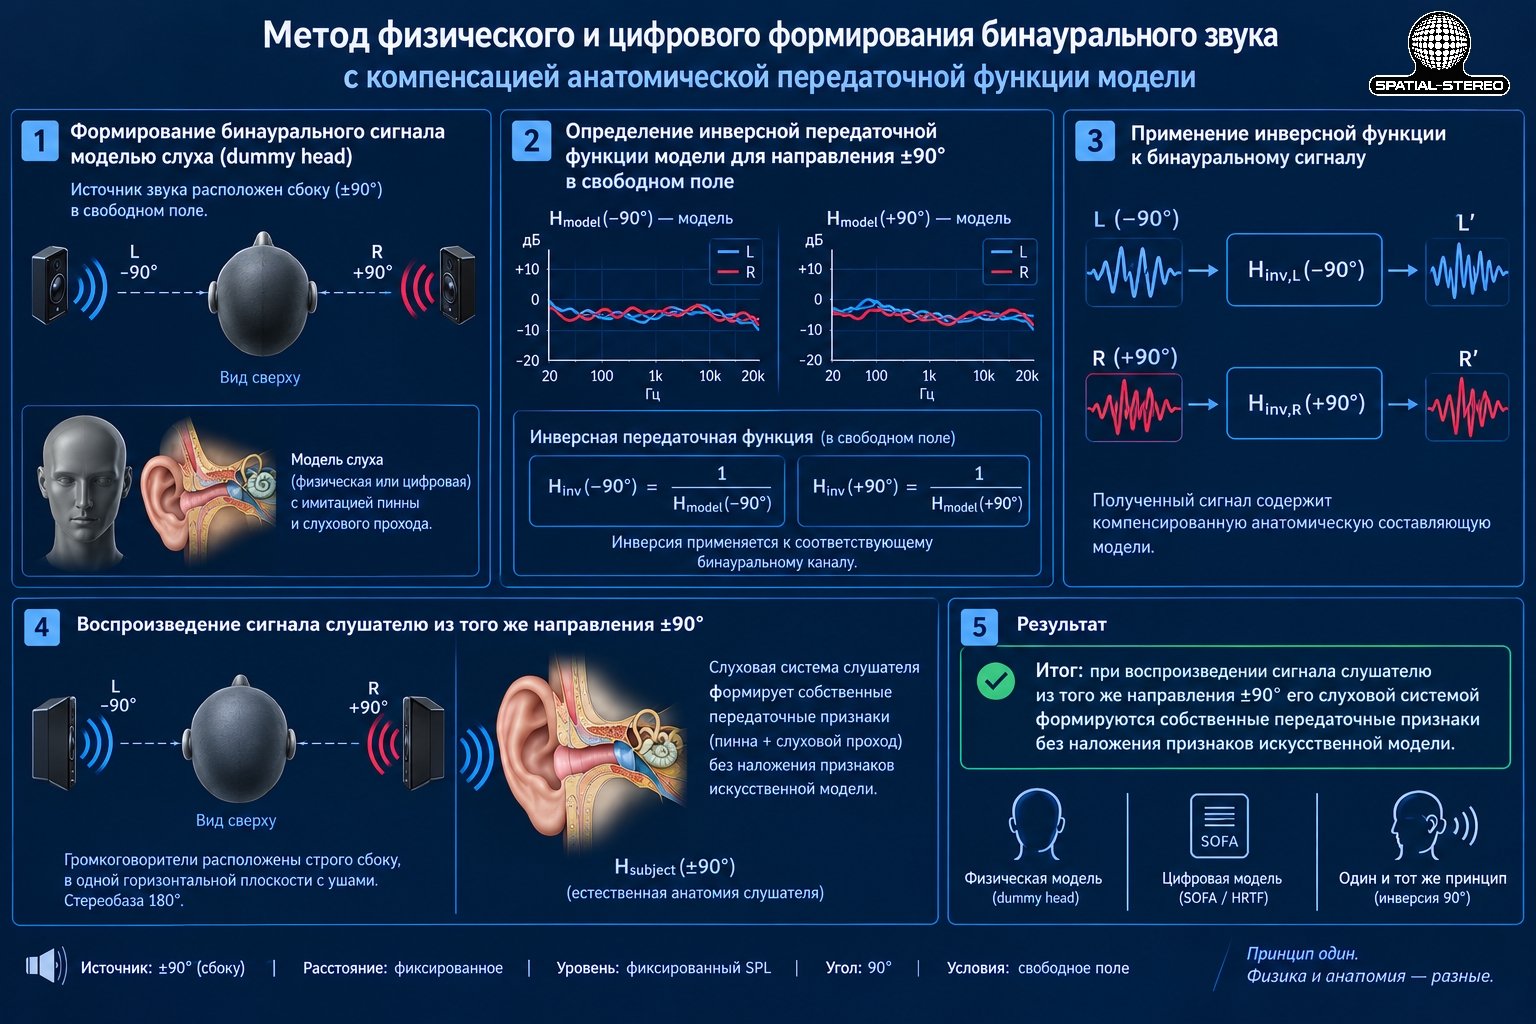
  1. Формирование исходного сигнала.
    Запись или симуляция пространственной сцены осуществляется через модель слуха (физический стенд dummy head или цифровой профиль SOFA / HRTF) с анатомически точной имитацией ушных раковин и слуховых проходов.

  2. Вычисление инверсного фильтра.
    В свободном поле снимается частотная характеристика модели для строго боковых направлений (\pm90^\circ). На её основе рассчитывается компенсирующая инверсная функция:
инфографика метода
инфографика метода
  1. Линейная коррекция фонограммы.
    Полученный инверсный фильтр применяется к соответствующим каналам бинаурального сигнала. Это полностью «очищает» аудиозапись от акустического отпечатка искусственной модели.

  2. Геометрия воспроизведения.
    Сигнал подаётся на внешние громкоговорители, расположенные по сторонам от слушателя под углом \pm90^\circ (стереобаза 180^\circ). Либо наушники открытого типа с тканевыми амбушюрами.

  3. Результат.
    Очищенная звуковая волна падает на голову слушателя сбоку под прямым углом. Слуховой аппарат человека (пинна и слуховой канал) формирует собственные, 100% индивидуальные передаточные признаки (H_{subject}). Обеспечивается натуральный объём и идеальная локализация без необходимости индивидуального сканирования ушей.

Архитектурное место в звуковом тракте

Метод инверсии моноуральной передаточной функции принципиально отделен от этапа бинаурального рендеринга. Рендеринг отвечает за формирование пространственных признаков (ITD/ILD) и работает с отдельными источниками до их суммирования. Инверсия ПФ является инструментом финальной постобработки и применяется исключительно к уже сведенному бинауральному сигналу на мастер-шине. Такое разделение исключает накопление фазовых искажений при суммировании виртуальных каналов и позволяет независимо обновлять как модель слуха (заменяя IR-файл), так и алгоритмы рендеринга без взаимного влияния .

  • Он не участвует в бинауральном рендеринге сцены.

  • Он не вмешивается в динамическое позиционирование виртуальных источников звука.

  • Его единственная задача — убрать двойное наложение и синтетический окрас, предоставив уникальной геометрии слушателя восполнить эти пики и провалы .

Теги:
0
Комментарии2

О внутреннем времени клиентского процесса в LLM / ноосвиках:

Внутри цикла "задание-ответ" ноосвик готовит свой ответ клиенту по результатам множества прогонов проекции контейнера LLM-беседы на пространство активаций по всем слоям трансформера. На каждом слое контейнер меняется квази-детерминировано – с точностью до влияния неопределенности от вычислительного шума. После последнего слоя на каждом прогоне происходит штатная стохастизация: при ненулевой температуре следующее состояние контейнера выбирается из возможных случайным образом, определяя содержимое начального контейнера для следующего прогона. Когда в таком вероятностном определении состояния контейнера актуализируется маркер завершения, из контейнера определёнными процедурами выявляется ответ, который помещается в диалоговое окно ноосвика.

После нового задания в рамках той же беседы идут прогоны следующего цикла.

Теги:
0
Комментарии0

К возможности описания клиентских процессов в чатах с LLM / ноосвиками как случайных процессов:

Кроме штатного случайного выбора продолжения на выходе последнего слоя трансформера при ненулевой температуре, дополнительную вариативность траектории обработки конкретного задания в пространстве активаций вносит организация вычислений в LLM: число одновременно обрабатываемых запросов, точность представления чисел, оборудование и т.д. (He & TML, 2025; Kasa et al., 2026). Возникающие из-за этого малые расхождения могут как гаснуть в слоях трансформера, так и лавинообразно расти (Islam et al., 2026). Особыми усилиями по организации вычислений можно добиться их полной воспроизводимости (He & TML, 2025), но при обычной эксплуатации даже при нулевой температуре одно и то же задание может приводить к разным ответам (He & TML, 2025). У исследованной в (Yuan et al., 2025) рассуждающей модели стандартное отклонение доли правильных ответов на множестве вариантов организации вычислений оказалось около 9%. Так что даже без учета штатной случайности проекция LLM-беседы на пространство активаций вполне допускает стохастическое описание.

Поведенчески, как отражение стохастичности процессов в ноосвиках, была введена характеристика семантическая энтропия (СЭ) (Farquhar et al., 2024). LLM многократно отвечает на один и тот же вопрос, ответы группируются по смыслу, и мерой неопределённости служит разброс между смысловыми группами. Так отстраивается характеристика именно ансамбля траекторий в пространстве активаций, а не одного прогона. Притом Kossen et al. (2024) показали, что уровень СЭ может быть оценён и по активациям одной траектории: их проекция на выявленную ось семантической энтропии позволяла предсказывать, является ли этот уровень высоким или низким. Получается, что контейнер LLM-беседы несёт в себе сведения о вариативности своих продолжений.

Теги:
0
Комментарии0

Что скрывается в логах и где искать слабые места инфраструктуры?

SIEM может пропустить атаку, уязвимости — добраться до продакшена, а привычные инструменты мониторинга — не показать причину проблемы. Как находить слепые зоны в защите, анализировать сетевой трафик и выстраивать процессы безопасной разработки, чтобы снижать риски до возникновения инцидентов?

Собрали бесплатные уроки для специалистов по информационной безопасности, которые помогут разобраться с этими вопросами. В программе — практические подходы к обнаружению угроз, DevSecOps и работе с инфраструктурой.

Мониторинг и обнаружение угроз

  • 5 ноября, 20:00. «Как построить SIEM‑мониторинг без слепых зон: от сценария атаки до источников событий». Записаться

  • 18 ноября, 20:00. «Что SIEM не увидит „из коробки“: корреляция событий и оценка качества детектора». Записаться

DevSecOps и безопасная разработка

  • 11 ноября, 20:00. «Как оценить зрелость DevSecOps‑команды и составить карту развития». Записаться

  • 16 ноября, 20:00. «Швейцарский нож РБПО: карта инструментов безопасной разработки на практике». Записаться

Сети, трафик и инфраструктура

  • 5 ноября, 20:00. «Стек сетевых протоколов и с чем его едят. На примере TCP/IP». Записаться

  • 10 ноября, 20:00. «CRI — обзор контейнерных runtime». Записаться

  • 17 ноября, 20:00. «Почему тормозит приложение: диагностика в Wireshark». Записаться

Чем лучше понимаешь, как устроена инфраструктура и где могут возникнуть проблемы, тем проще выстраивать эффективную защиту.

Что почитать по теме?

Безопасность инфраструктуры складывается из конкретных решений: какие права дать контейнеру, как защитить сервисы от атак и почему нельзя отключать проверку TLS ради удобства. Подобрали три статьи на Хабре, которые помогут разобраться в этих вопросах на практике.

Теги:
0
Комментарии0

ИИ не заменит тебя. Но инженер с ИИ - заменит

Прямо сейчас рынок делится на два типа инженеров.

➖Первые до сих пор вручную копируют конфиги и разгребают тонны логов.

➖Вторые уже настроили себе цифровых помощников и пьют кофе, пока ИИ делает рутину.

Мы собрали интенсив, где учим строить реальные рабочие воркфлоу под твоим полным контролем.

Что мы там разберем:

🔹n8n на практике: свяжем GitHub, базы данных, Slack и терминал в единую автоматизированную сеть.

🔹Алерты, которые не бесят: настроим их так, чтобы в 3 часа ночи ты видел не «ERROR 500», а готовый разбор полетов от Claude Code с предложением решения.

🔹RAG и MCP-серверы: дадим ИИ доступ к твоей внутренней документации, чтобы он знал контекст твоего проекта, а не галлюцинировал.

🔹Безопасность (OWASP Top-10): сделаем всё так, чтобы твоя автоматизация не стала дырой в инфраструктуре и поводом для разговора с безопасниками.

Хватит бояться, что тебя заменят. Стань тем самым инженером, который управляет ИИ.

👉 Забирай место на потоке

Теги:
0
Комментарии0

Приглашаем на Ozon Tech Platform Meetup

30 октября встречаемся в Москве, в лофте Casa Picassa на короткие доклады и глубокие технологические дискуссии. 

Все сервисы, о которых поговорим, написаны на Go. Но мы ждём не только Go-разработчиков. Будем рады всем, кто интересуется платформенной инженерией или просто хочет узнать, как всё устроено у нас.

Регистрируйтесь на странице события и присоединяйтесь

Темы выступлений:

  • Под капотом Ozon: как устроена технологическая платформа.
    Михаил Кабищев, руководитель департамента разработки PaaS, о задачах Платформы сегодня, о стандартах разработки, CI/CD, сетевой инфраструктуре, мониторинге и инфраструктурных сервисах.

  • Как мы оптимизировали более 4 000 сервисов на Go перед сезоном распродаж.
    Денис Крупецкий, руководитель группы разработки Go-платформы, о том, как мы освободили 7000+ CPU в масштабе более 4 000 микросервисов на Go.

  • Олимп: как устроен портал платформы данных в Ozon?
    Артемий Сероокий, руководитель платформы управления и визуализации данных, о том, как мы организовали взаимодействие с множеством сервисов и построили удобный интерфейс, который можно развивать независимо от изменений бэкенда.

Митап проведёт Марина Самойлова, руководитель направления платформы данных.

До встречи!

Теги:
0
Комментарии0

Выложил в открытый доступ небольшой инструмент, который сделал для своей работы: расширение для SketchUp, импортирующее сборки STEP.

Ruby API SketchUp не умеет читать STEP напрямую, поэтому расширение запускает FreeCAD в фоне и собирает модель в SketchUp:

- иерархия сборки сохраняется в виде групп
- повторяющиеся детали (винты, гайки) становятся компонентами
- тяжёлые узлы, например плата с компонентами, склеиваются в один меш: ~1200 деталей импортируются за секунды
- собственное окно прогресса, результат сохраняется в .skp

По пути наткнулся на несколько подводных камней производительности Ruby API SketchUp (add_faces_from_mesh против fill_from_mesh, молчаливая склейка точек) и описал их в README для других разработчиков расширений.

Windows, SketchUp 2021+, лицензия MIT. Это ранний релиз: цвета пока не импортируются. Буду рад отзывам и issues.

GitHub: https://github.com/eugenyh/sketchup-step-importer

Теги:
+1
Комментарии3

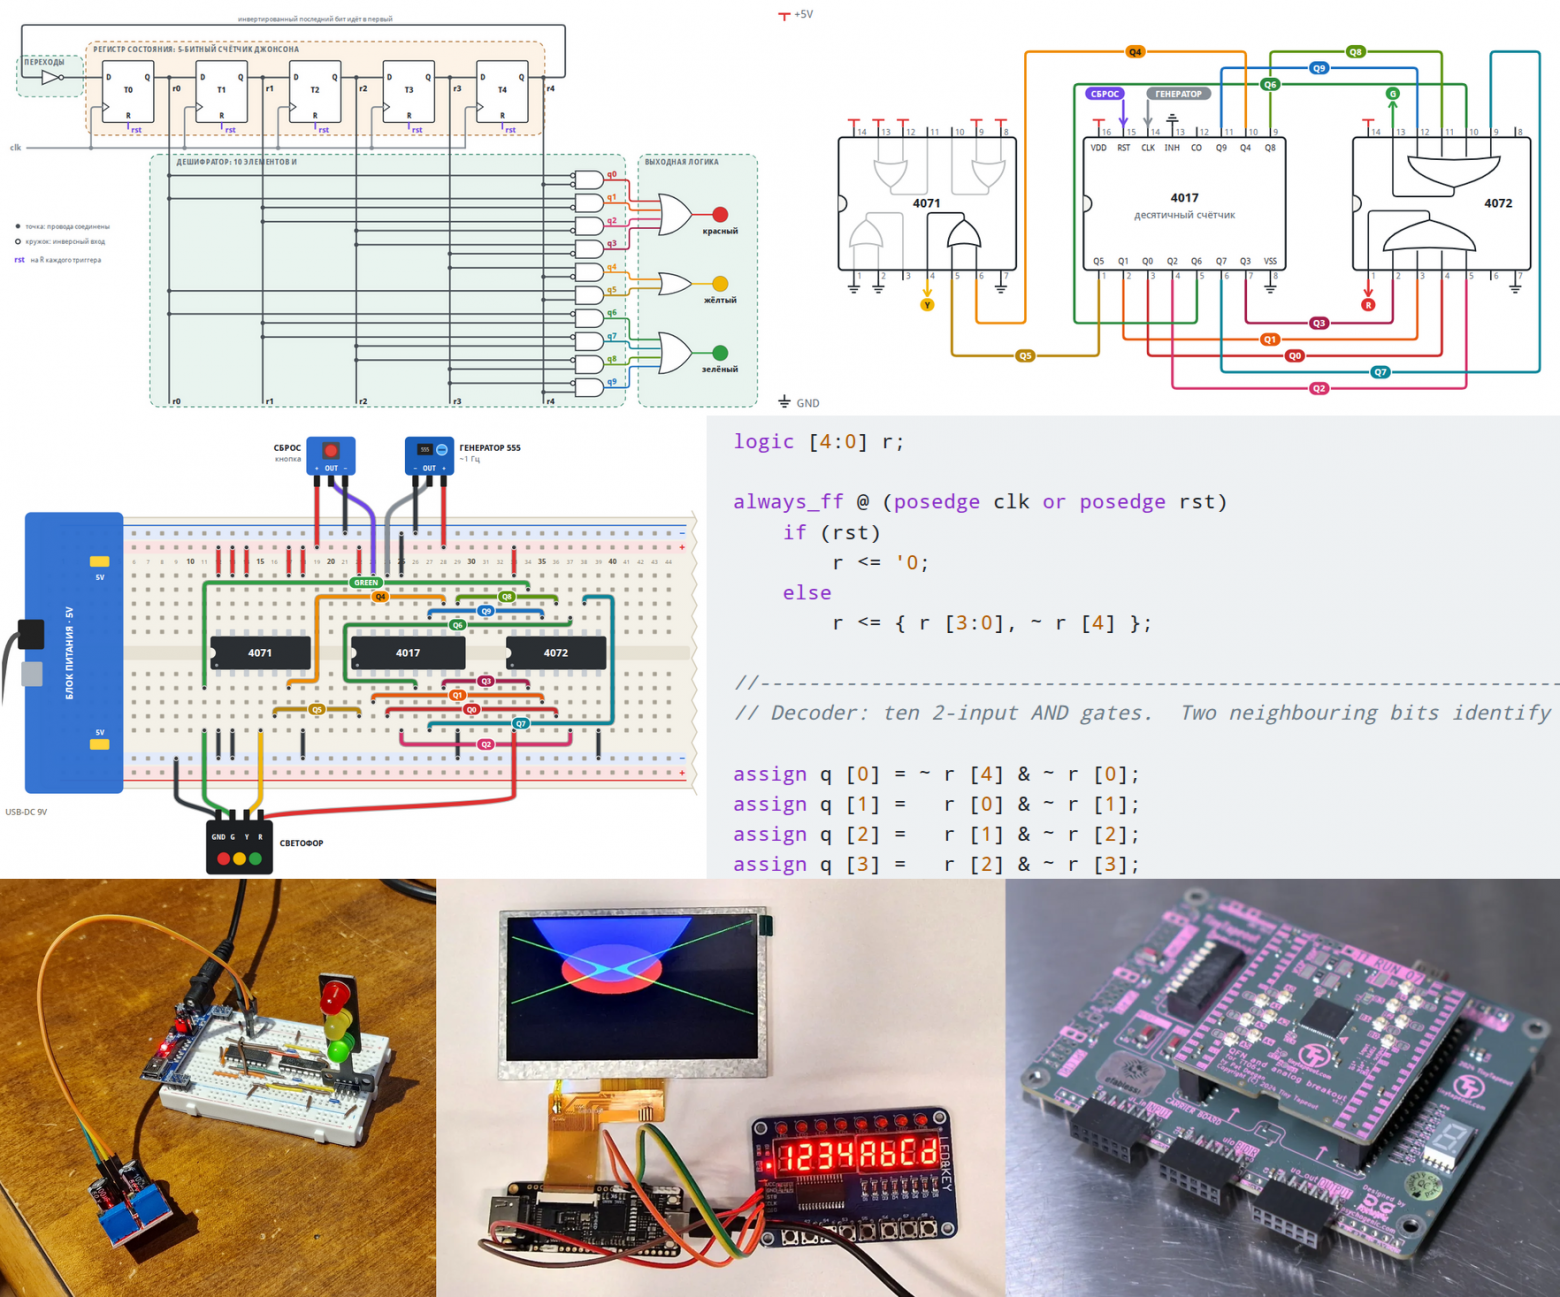
Я решил сделать пример инструкции для школьников на основе схемы со светофором от школьника Тимофея, комбинируя сгенеренные инструкции от Claude и Codex. Господа, вы можете это все прочитать и высказать ваши замечания? Когда я отлажу эту технологию, я сгенерю еще 100 таких инструкций.

Исходный промпт

Страница примера на русском от Claude

Страница примера на русском от Codex

Это часть деятельности, которую я описал в посте "От Цифровой Логики к Процессору через ПЛИС. Программа годового курса для школьников физматшкол". Идея в том, чтобы вернуть школьникам обучение с помощью микросхем малой степени интеграции, но не циклится на всякой ерунде из 1970-х, типа JK-триггеров или сборки генератора тактового сигнала из 555 с конденсаторами и резисторами, а использовать уже собранный генератор и компоненты со встроенными резисторами, чтобы можно было сконцентрироваться чисто на логике, и потом перейти к SystemVerilog-у, ПЛИС-ам и ASIC-ам, с конечными автоматами, конвейерной обработкой данных, очередями FIFO итд, то есть вещам релевантным современной работе.

Далее я попросил Claude и Codex покритиковать друг друга:

Analyze what your competitor put in its breadboard directory and write a comparison report in html file. Find errors, bad ideas, problems with style and presentation, good ideas to adopt, etc. Comprehensive assessment of everything.

Claude критикует Codex

Codex критикует Claude

Кто победил, по вашему?

И да, если возникнет стремление высказать "не надо это детям, дайте им Ардуино!" то у меня для этих дискуссий есть другой пост.

Теги:
+3
Комментарии7

Голоса в голове

Ещё одна история практического применения знаний из книг. На этот раз – «Эго – это враг» Райана Холидея.

Книга, напомню, о том, как эго мешает человеку заниматься полезными делам и быть, прошу прощения, эффективным. В том числе Райан упомянул вполне конкретный процесс, который служит исключительно эго – разговоры в голове с другими людьми.

Например, поговорил ты днём с начальником, и результат не в твою пользу. Начальник в чём-то обвинил, наехал, покритиковал. Во время разговора ты сообразить толком не успел, как эффектно ответить на его бред (ну бред же!), а может и просто побоялся. Что будет происходить в оставшееся время дня, а то и завтра? Разговор в голове с начальником, где ты, конечно, будешь блистать, ушатаешь его в пух и прах, он разревётся, падёт на колени, будет умолять о прощении и зарплату тебе повысит.

Так вот, Холидей сказал: нет никакой пользы в этих разговорах, окромя вреда. Исключительно своё эго почесать. Как кота, чтобы замурлыкал. А в чём вред-то, казалось бы?

Для меня вред был вполне конкретный – я тратил на эти разговоры огромное количество времени. Буквально часы в неделю. И настроение портилось – и в процессе, и после, когда отпустит и осознаёшь, сколько времени зря потратил. Пока разговариваешь с голосами, не можешь нормально работать, общаться, осознанность снижается – как будто спишь на ходу.

У меня разговоров с голосами было очень много, потому что занимаюсь продажами и управлением. За день пообщаешься с двумя-тремя десятками людей, и в голове буквально рой жужжащих пчёл. Каждый требует с ним поговорить.

И это я ведь ещё бросил в комментариях к своим статьям общаться – спасибо Поварнину. Раньше я и с комментаторами в голове разговаривал, не только посредством клавиатуры. Сложно представить, как я это выдерживал и хоть что-то успевал делать.

Но, спасибо Райану, я практически избавился от разговоров с голосами. Не сразу, но выработался триггер: как только начался разговор в голове, его надо срочно прекратить. Переключится на что угодно, но уйти от разговора с фантомом. Вплоть до применения инструментов подавления тревожности – например, найти и сосчитать все белые предметы.

И это работает. Высвободилось огромное количество мозгового времени – а для меня в работе это ценнейший ресурс. Именно время, когда я ничего не делаю, а думаю. Вместо разговоров с привидениями я теперь обдумываю изменения в работе, сочиняю темы для постов и статей, планирую будущие разговоры.

Вот здесь важное отличие: будущие разговоры вполне можно прогонять в голове. Это известная всем продавцам отработка возражений. И знакомый всем стратегам приём «что будет, если?». Разговоры в голове о будущем – да, о прошлом – нет. Не путать с рефлексией, разумеется.

Этот пост также придуман в освободившееся от фантомных разговоров время. Райан Холидей проспонсировал сам себя.

Этот текст - практика применения книг из Книжного стека

Теги:
+5
Комментарии2

Как я вырастил физику из одного синуса (и где мне нужна ваша помощь)

Привет, Хабр.

Взял одно допущение: всё — процесс, а процесс — идеальный синус. Больше ничего. Ни измерений, ни частиц, ни полей, ни постоянных — одна волна, которая знает только себя.

Дальше просто честно смотрел, что из этого следует. Выяснилось, что у синуса есть мнение по многим вопросам:

  • во первых скорость света реально для нас единственная постоянная, на её основе формируются все остальные физические величины и этому есть объяснение, используется её значение, не размерность;

  • стабильных частиц должно быть четыре (их и правда четыре: нейтрино, электрон, протон, нейтрон);

  • масса электрона получается из значения одной скорости света с точностью 0,7 %, у других стабильных - погрешность до 4%;

  • и элементарный заряд появляется, с точностью 3,2%

  • наша Галактика по массе — это нейтрон, только очень большой (5,5·10¹⁰ масс Солнца против наблюдаемых 6,1·10¹⁰);

  • постоянная Хаббла выходит 68,7 — ровно между двумя спорящими лагерями астрономов (67,4 и 73);

  • гравитационная постоянная — c в степени −6/5, с точностью 0,8 %.

Проценты пока великоваты…, но это идеальная модель и пока работаю над вопросом об эталоне, пока значения из СИ почти идеально подходят. Больше интересна качественная картина. Есть связка и с квантовой механикой и с ОТО, частично:) Появляются необходимые константы, с погрешностью конечно:)

Понимаю, как это звучит. Поэтому не прошу верить — прошу найти ошибку. Всё расписано пошагово, у каждого утверждения стоит статус: доказано, гипотеза или открытый вопрос. Работа на трёх языках.

Если синус где-то врёт — покажите где. Если не врёт — тем интереснее.

Создавать статью не стал, ещё полностью не готова, работа кипит, но интересные результаты всё таки есть. На данный момент больше новость для поста.

Если кому интересно, то вот ссылка на работу, которая ещё наверняка будет обновляться:

Рождение измерений - формальный скелет google.disk

Рождение измерений - формальный скелет zenodo

Рождение измерений - формальный скелет mail.ru

Что бы на mail.ru открывалось - нужно там авторизоваться.

Теги:
-2
Комментарии8

Росреестр выделил 725 млн на киберзащиту


Росреестр выделил 725 млн ₽ на лицензии и поддержку для своего центра управления инцидентами. Его задача – замечать инциденты и помогать их разбирать. В случае атаки важна скорость: как быстро удастся вернуть сервисы в работу. Документы закупки показывают, что деньги идут на защиту периметра, поиск уязвимостей, сбор событий и защиту рабочих мест.

Главная суперсила кибербезопасников: остановить атаку как можно раньше, пока она не нанесла непоправимый ущерб. Затем нужно понять масштаб и вернуть сервисы в работу.

Каждый час, пока сервисы недоступны, обходится бизнесу дороже. Может оказаться, что вредоносный скрипт поменял права у сотен сотрудников или удалил важные группы. Доступы вернутся только после восстановления прежних прав.

Если затронута служба каталога

Если инцидент затронул каталог, полностью восстанавливать его есть смысл после серьёзной аварии: когда он полностью испорчен или испорчены все данные в нём. Для одной удалённой группы такой способ избыточен. Банк же не закрывают на день, чтобы исправить один ошибочный перевод. Здесь нужен точечный возврат нужной группы, атрибута или права.

Хочется надеяться, что следующая крупная закупка Росреестра будет захватывать и защиту службы каталога – инфраструктуры нулевого уровня. Каталог обычно не замечают, как воздух, которым дышат. Но когда он перестаёт работать, бизнес это чувствует сразу: доступ к системам и данным пропадает. Нет каталога – нет доступа.

Нынешняя закупка закрывает две задачи: помогает раньше заметить атаку и быстрее её остановить. Но остановка атаки сама по себе не вернёт сервисы в работу. У каждой критичной системы свой сценарий восстановления. Для каталога это точечный возврат прав без отката всего каталога.

Теги:
+1
Комментарии1

LiteLLM 1.107.0 со стилером ключей: как проверить себя и что менять

21 октября 2026 на PyPI вышел litellm==1.107.0 со стилером учётных данных во всех бинарных wheel-файлах. Образы Docker с тегом v1.107.0 тоже заражены, а теги latest, main-latest и main-stable около трёх часов указывали на заражённый образ. Чистыми названы 1.106.x и ниже.

Инцидент развивается: данные из разбора StepSecurity, сверьтесь с заявлением BerriAI. Релиз загрузили в 11:39 UTC, с PyPI убрали к 13:23.

Чем опасно

В site-packages попадают cook.pth, cook.py и sitecustomize.py. Стилер запускается при каждом старте Python в этом окружении, import litellm не нужен. Уходят SSH- и облачные ключи, .env, переменные окружения, токены AI-инструментов. Если задан DATABASE_URL, дампится база прокси с API-ключами вендоров. Архив зашифрован и отправляется на litellm.dev.

Как проверить

Не запускайте Python на подозрительном хосте: это снова запустит стилер, поэтому pip show не подходит.

grep -rn "litellm.*1\.107\.0" --include="requirements*.txt" --include="*.lock" --include="pyproject.toml" .
find / \( -name cook.pth -o -name cook.py \) 2>/dev/null
ls -l /tmp/remote_code_loader.lock 2>/dev/null
docker images --digests | grep -i litellm

Скомпрометирован любой хост, раннер или контейнер, где ставился 1.107.0 или был образ v1.107.0/latest из того окна. Признак в сети: запросы к litellm.dev.

Что делать

  1. Убить процесс, держащий /tmp/remote_code_loader.lock, и заблокировать litellm.dev на выходе.

  2. Пересобрать контейнеры и переустановить окружения, а не чистить.

  3. Запинить litellm==1.106.2 или образ по дайджесту, удалить 1.107.0 из зеркал.

  4. Сменить всё, до чего хост мог дотянуться: облачные, SSH- и CI-ключи, токены. Для прокси с базой ещё и все ключи вендоров, master key и salt key. Архив зашифрован, поэтому считайте, что данные ушли.

  5. Поискать в логах litellm.dev и проверить расход у вендоров.

Для любого шлюза

Шлюз хранит ключи ко всем вендорам. Пиньте версии и дайджесты, не деплойте latest, ставьте с хэшами и ограничьте исходящий трафик шлюза.

Для LiteLLM это второй случай: в марте 2026 были скомпрометированы 1.82.7 и 1.82.8. Зависимости можно отравить в любой экосистеме, не только в Python.

Теги:
+2
Комментарии0

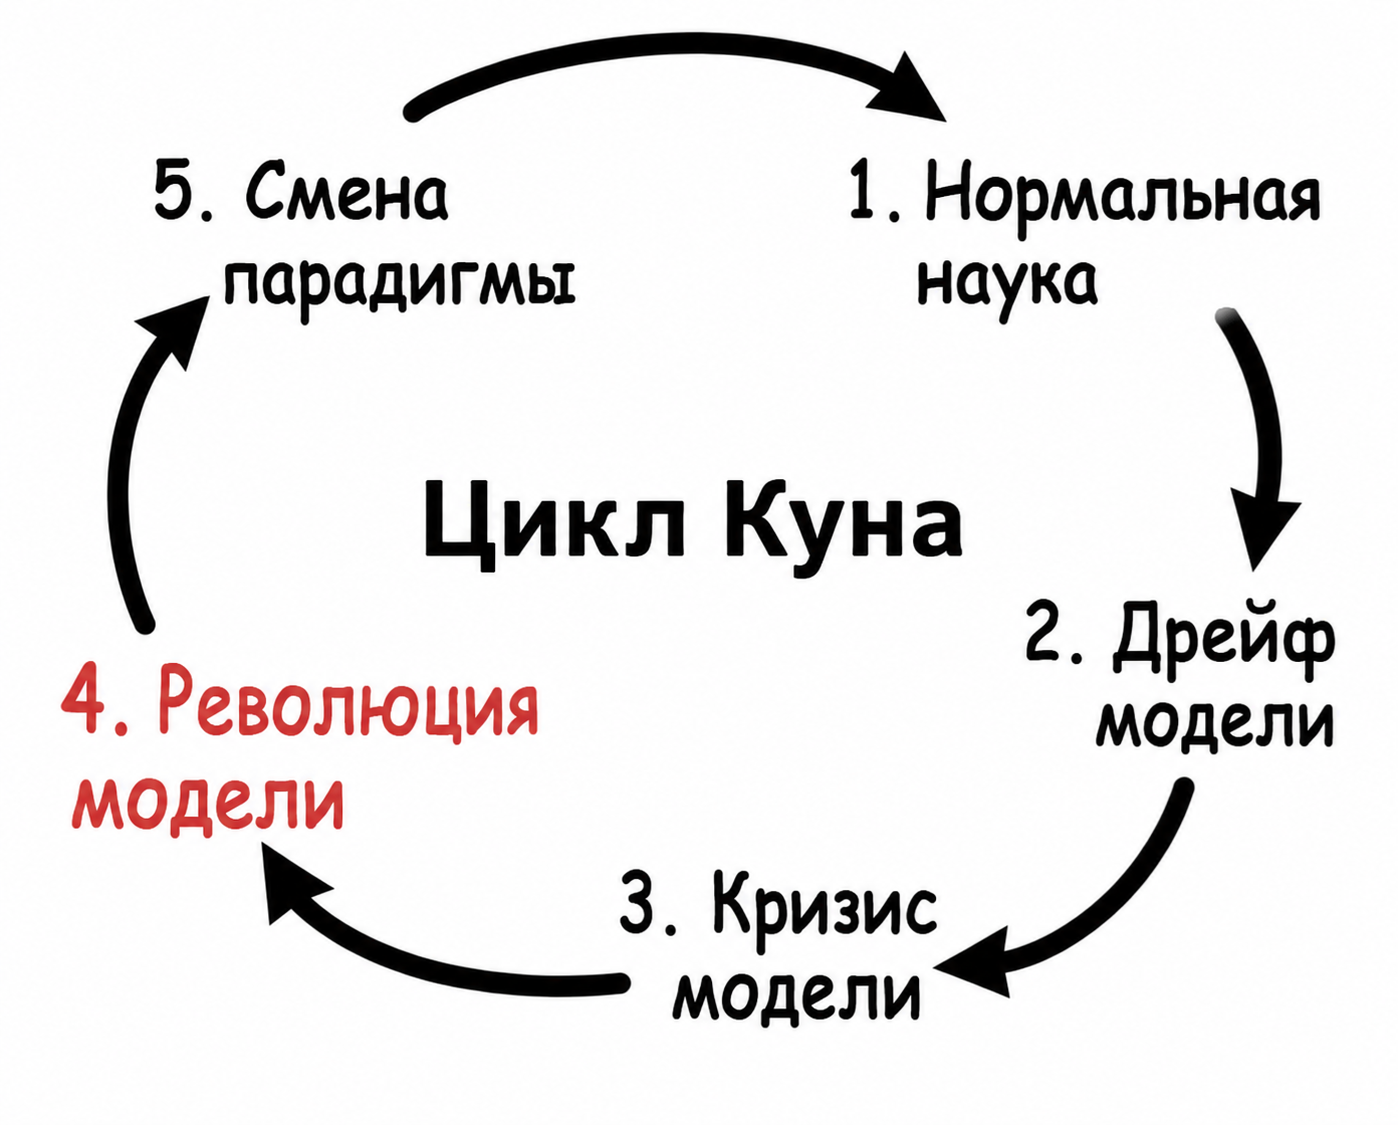
Что такое «смен парадигм».

Один из самых влиятельных философов науки 20 века Томас Кун предложил известную схему анализа этого процесса в фундаментальной книге «Структура научных революций».

Сначала формируется и утверждается господствующая парадигма - система представлений, теорий и методов, с помощью которых учёные объясняют определённые явления. Большинство исследований ведётся именно в её рамках.

Учёные проверяют и развивают существующие представления, собирая новые эмпирические данные. Постепенно обнаруживаются аномалии - факты, не вполне согласующиеся с господствующей парадигмой.

Поначалу противоречия пытаются объяснить, не отказываясь от прежней парадигмы. Старые представления начинают «растягивать» и приспосабливать к новым открытиям, а неудобные данные могут отвергаться, считаться исключениями или недооцениваться. Однако по мере накопления аномалий способность прежней парадигмы объяснять наблюдаемую реальность всё чаще ставится под сомнение. Наступает кризис.

Когда противоречия становятся достаточно серьёзными, появляются альтернативные объяснения и начинается конкуренция между старой и новой системами представлений. Происходит революционный пересмотр фундаментальных предпосылок прежней науки.

В итоге новая парадигма вытесняет старую, поскольку лучше соответствует накопленным фактам и обладает большей объяснительной и предсказательной силой. Она становится основой нового периода нормальной науки. И цикл начинается заново.

Хорошего дня! заходите на тг канал https://t.me/TradPhronesis

Теги:
-3
Комментарии0

Ближайшие события

Unitree представила робота‑телохранителя H2-X Kung Fu Legend Guardian, который умеет отбить нападение грабителя, поднять автомобиль и даже откинуть человека в сторону, если ему угрожает пуля или неадекватный водитель. Без подзарядки робот активен лишь 8 часов,

Теги:
0
Комментарии4

Что такое ZDP? Рассказываем об этом в новом выпуске нейрословаря от лаборатории ИИ компании «Криптонит»!💚

После дообучения большая языковая модель (LLM) может изменять представление данных внутри своих слоёв. Такие изменения называют дрейфом. Он помогает адаптации модели с учётом новых данных, но одновременно может приводить к ухудшению прежних навыков, в том числе и к «катастрофическому забыванию».
 
Обычно для оценки дрейфа проводят повторное тестирование модели на серии вопросов. Это довольно трудоёмкий процесс. Недавно был разработан подход к упрощённому анализу дрейфа по активациям трансформера, то есть численным значениям его внутренних состояний. Для этого анализа не нужны ни метки (правильные ответы к примерам), ни оценка выходов модели.

Метод получил название «зондирование нулевого направления» — Zero-Direction Probing (ZDP). При его использовании сначала все активации одного слоя собирают в матрицу. В этой матрице строки соответствуют токенам (элементам, на которые модель разбивает текст), а столбцы — координатам в скрытом пространстве.
 
Затем в нём находят направления, при умножении матрицы активаций на которые получается ноль. После изменения модели проверяют новые активации в тех же направлениях. Если возникает отличный от нуля сигнал, то фиксируются изменения представлений.
 
Количественно ZDP измеряет Null-Variance Leak (NVL) — суммарную энергию новых активаций в ранее нулевых направлениях. Также он позволяет оценить относительный показатель Spectral Null-Leakage (SNL) — та же энергия, делённая на полную энергию новых активаций.
 
Важно отметить, что пороговые значения для обнаружения изменений выведены из предположения о гауссовском (нормальном) распределении случайных активаций, но на практике это не всегда так. ZDP стоит рассматривать как исследовательский метод, упрощающий отслеживание изменений модели, а не как гарантию сохранения её качества.

Теги:
0
Комментарии0

Понадобилось отлаживать туннель между VIPNet координаторами (доступ на координаторы только по SSH), стандартными средствами проверил что пакеты от удаленной сети приходят:

machine logs show network-traffic

Это просмотр трафика в псевдо GUI. В целом довольно удобно

Однако же приходят то они приходят, и дешифруются но целевая станция не отвечает.

Увы но смотреть далее порта випнета я не могу, поэтому для начала хотел убедится что дешифрованные декапсулированные пакеты, уходят во внутренний интерфейс.

Что нам понадобится? разумеется tcpdump и он тут есть.

Заходим в shell:

admin escape

Ту пожалуйста действуйте аккуратно, лучше тут вообще ничего не трогать :-)

Но мы посмотрим:

arp -a
ip a
ip route

В моем случае целевой хост в одном L2 сегменте с интерфейсом eth1 координатора

Запустим tcpdump (будем смотреть пинги с удаленной машины на целевой хост):

tcpdump icmp -i eth1 -xx

Но смотреть дампы на экране не очень хорошая идея, да иногда достаточно но мы хотим pcap.

Тогда пишем в файл:

 tcpdump icmp -i eth1 -w icmpcap.pcap

Останавливаем.

Файл сохранился в текущей директории (/root)

Нам нужно его забрать но у нас нет ни tftp ни ftp клиента.

SCP тоже не работает (думаю понятно почему)

Давайте выведем его содержимое на экран, в кодировке Base64:

base64 icmpcap.pcap

Теперь скопируем все что мы видим на экране и сохраним в файл на локальном ПК, например в base64 icmpcap.pcapи64

Теперь, если ПК под управлением операционной системы Windows, сконвертируем его обратно в pcap:

certutil.exe -decode .\icmpcap.pcapи64 vipneticmp.pcap

Ну и удаляем ненужный файл на координаторе:

rm icmpcap.pcap

Все, комфортно смотрим дамп в Wireshark, сообщаем администраторам сети за координатором:

"От меня пинги вылетели, проблемы на вашей стороне" :-)

Теги:
0
Комментарии0

Если код написал ИИ, такое ПО можно включать в Реестр Минцифры?

Все чаще клиенты спрашивают меня: нужно ли сообщать экспертам Минцифры, что код написан с помощью ИИ? Не откажут ли из-за этого во включении в реестр российского ПО? Пришло время развеять туман неочевидности.

Давайте немного копнем в суть, кому вообще принадлежат права на результат генерации ИИ🤨

В российском законодательстве автор – это всегда человек, внесший творческий вклад (ст. 1228 ГК РФ, п. 80 ППВС РФ № 10 от 23.04.2019 г.). Однако одно наличие промпта авторство не гарантирует.

Судебная практика такова:

1. ИИ-изображения не защитили: ответчик указал на признаки генерации ИИ, а истец не смог доказать своё авторство.

2. Ролик с дипфейком защитили: сценарий, съёмку и звук создали люди, используя ИИ как инструмент.

То есть главное внести творческий вклад и зафиксировать это в документах. Так, например, заказчик сможет удостовериться в чистоте ваших прав на код (для этого, кстати, обязательно сохраняйте промпты, историю версий и собственные доработки – они подтвердят ваш вклад в разработку).

Так можно ли зарегистрировать ПО, созданное с помощью ИИ?

Да! Получается, ИИ не препятствует регистрации ПО в Роспатенте и реестре Минцифры, уведомлять о его использовании пока не требуется. 

Но важно, чтобы права на ПО были надлежащим образом оформлены, а программа соответствовала остальным требованиям реестра.

Теги:
+1
Комментарии2

Обсудили научпоп и будущее ИИ с автором Onigiri

В новый выпуск подкаста к нашему техлиду Саше Стародубцеву пришел Артем Яшин, автор канала Onigiri, где разбираются сложные темы из мира математики, физики, геймдева и программирования. Поговорили о научпопе и разработке.

Что обсудили:

  • историю канала и мотивацию;

  • процесс создания: сначала анимации, потом текст;

  • 4D-графику и рендеринг червоточин;

  • самообразование по YouTube;

  • игру Logic Arrows и Steam;

  • оптимизацию кода с помощью нейросетей;

  • математическую сингулярность.

Смотрите на удобной площадке: YouTube | VK Видео | Rutube

Теги:
0
Комментарии0

Импорт устройств в Netbox с помощью CSV, JSON, YAML

Если у вас есть большое количество серверов, сетевых и других устройств то для управления инфраструктурой, то можно использовать один из самых популярных инструментов - NetBox, он упрощает инвентаризацию и автоматизацию задач. Однако если устройств много ручной их ввод может быть трудоёмким. В этой статье хочу рассмотреть пошаговый процесс импорта устройств в NetBox с помощью файлов форматов .csv, .json и .yaml, чтобы ускорить переход и избежать проблем при заполнении данных.

1.Для начала создаем файл

Поля должны называться согласно страницы импорта в Netbox

Примеры csv файлов

1.devices.csv

2.interface.csv

3.ipaddress.csv

4.cable.csv

Нельзя повторять название устройств в столбце name название AP_01 и AP_01 одинаковы, даже если адреса разные

Если необходимо перед\после во все столбы добавить одно и тоже слово, например "/24"

В Libreoffice можно с помощью "Найти и заменить" выделить нужные ячейки и установить "птички" "Регулярное выражение" и "Только текущее

выделение"\

В поле Найти:^.* карет\циркумфлекс (крышечка, домик), точка, звёздочка

В поле **Заменить на *&/24

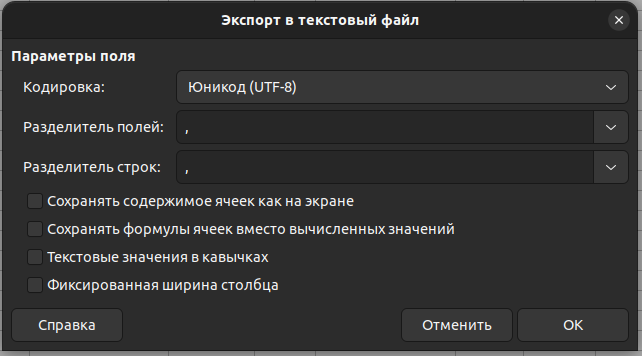
2.Сохранить файл xlsx в формат csv

В LibreOffice выбрать Файл - Сохранить как…, с такими параметрами

3.Для конвертации в JSON формат можно выбрать любой онлайн ресурс, например Convert CSV to JSON

https://www.convertcsv.com/csv-to-json.htm

Step 1: Select your input - Choose File - Нажать кнопку обзор

Скачать json файл, нажав Download Result

4.Импорт файла в формате JSON

Переходим на страницу Devices (или другую страницу для которой предназначен файл), выбираем Import, далее нажать Upload file

Внизу видим Field Options:

Field - это название поля в таблице Excel,

Required (если стоит галочка - обязательный параметр, должен быть в таблице)

Остальные поля необязательные

У некоторых строк справа есть знак вопроса, можно узнать какое значение нужно указывать для поля * (например для поля status значение указываем из столбца Import Value)

Если каких то обязательных полей нет в Netbox

Идём в соответствующий раздел и создаём их начиная с шага один. Для примера поле device_type.Переходим на страницу Device Types, далее можно добавить вручную если типов устройств немного или следуя первому шагу.

При успешном импорте появятся добавленная таблица и надпись Imported <кол-во устройств> devices (импортировал сначала по 50, потом решил около 300 импортировать всё прошло успешно, только долго ждать) Если покажет ошибку то смотреть её описание (скорей всего это неправильно названы столбцы, нет такого устройства, возможно пробел в ячейку попал).

Заключение

Импорт данных в NetBox с использованием форматов .csv, .json или .yaml даёт возможность значительно упростить и ускорить администрирование и поддержание актуальности вашего списка оборудования. Следуя приведённым выше шагам, можно без лишних ошибок загрузить устройства, интерфейсы, адреса и другие данные, а также быстро адаптировать данный процесс под собственные нужды.

Остальные изображения по ссылке https://github.com/solizarevich/netbox-import
(больше одного не дает добавить)

Теги:
-2
Комментарии0

ИИ и кризис идей

ИИ в 1С и бизнесе обнажил острую нехватку качественных идей. Сейчас кризис идей - главное ограничение, бутылочное горлышко всей затеи.

Можно быстро и дёшево сделать всё, что в голову взбредёт, но... Ничего не взбредает.
Поэтому подавляющее большинство применителей ИИ, будь то программисты, аналитики или люди из бизнеса, просто дают ИИ те задачи, которые делали сами, руками.

Напоминает одну старую историю. Я когда ИТ-директором работал, то увлекался полуконсалтинговыми проектами.
Один из них - исполнительская дисциплина. В компании было так себе с исполнением поручений (ну, как везде), и решили поднять ту самую исполнительскую дисциплину до 95%.
95% всех задач должны быть выполнены в согласованный срок.

Проект я сделал, всё получилось (эх, были времена 😊). Писал статью как-то про этот проект - https://habr.com/ru/articles/433514/. Но один из результатов оказался совершенно неожиданным - точно такой же кризис идей, только уже у руководителей.

Когда люди не делают то, что говорит руководитель, ему намного проще казаться компетентным и полезным.
Распоряжения отдаёт, стратегии рисует, планы верстает. Там всё красиво. Но результат - плохой, потому что никто всё это не исполняет полностью.
И руководитель может сказать "ну вот, опять исполнение подвело, а задумки-то хорошие были".

Когда же всё вдруг стало исполняться, то - пфффф - вдруг оказалось, что руководитель велел делать какую-то фигню, и результата от неё нет и не будет.
Руководители и расстроились. У них начался кризис идей. Когда ты знаешь, что всё тобой сказанное будет сделано - думать над словами надо сильно крепче.

То же происходит с ИИ. В бизнесе всегда было много людей, которые говорили, что у них много идей по автоматизации. Но им не дают бюджетов, ресурсов и вообще. Сейчас есть ИИ - любому нарисует всё, что в голову взбредёт. И вот человек садится, идею свою выдаёт, ИИ чего-то рисует... И?

И случается такая же фигня, что с руководителями. Вдруг оказывается, что реализованные идеи никому и ничем особо не помогают.
И человек больше не просит ИИ делать автоматизацию.

У разработчиков так вообще с идеями полный швах. Они всегда избегали задач, проблем и даже терминологии бизнеса. Поэтому у них нет идей вообще. Технические ИИ-разработки "для себя" не в счёт (это реинкарнация нетленок, это для души).

Можно, конечно, спросить идеи у самого ИИ. Но для этого в него надо залить бизнес-контекст, а его слишком много. Люди, их отношения, история, цифры и показатели, контрагенты, продукты и т.д. Пока до этого не дошло.

Так что люди, способные придумать хорошие, реалистичные и полезные идеи, сейчас в самой цене. Или скоро станут.

Другой 1С

Теги:
+3
Комментарии0